
Simate behauptet, bei „Robotics“ „GPT-6 geschlagen“ zu haben. Die eigene Rangliste gibt 27,96 Prozent an.
Die Behauptung eines erst drei Monate alten Start-ups, es habe „GPT-6“ bei einem Robotik-Benchmark „geschlagen“, verbreitete sich diese Woche ungeprüft wie ein Lauffeuer, während die vom Benchmark selbst veröffentlichten Zahlen zeigen, dass selbst das Modell an der Spitze der Rangliste die meisten realistischen Manipulationsaufgaben im Vergleich zu einer zu 100 Prozent menschlichen Referenzleistung nach wie vor nicht bewältigen kann.

Ein Unternehmen, das im März noch gar nicht existierte, führte diese Woche eine Rangliste im Bereich der Robotermanipulation an, und die am schnellsten verbreitete Darstellung lautete, es habe „GPT-6-Astra und DeepMind übertroffen“ und damit den weltweiten Spitzenplatz erobert. Diese Behauptung wurde durch keinerlei Punktzahl untermauert. Kein Datum, kein Eintrag in der Rangliste, keine Möglichkeit, sie anhand irgendwelcher Daten zu überprüfen. Sie verbreitete sich einfach, so wie eine solche Behauptung dazu bestimmt ist, sich zu verbreiten.
Was sich jedoch nicht mitverbreitete: Der Benchmark, den dieses Unternehmen anführte, veröffentlicht seine eigenen Zahlen, und diese Zahlen zeigen, dass sich das Feld noch in den Kinderschuhen befindet. Ein Mensch, der dieselben Manipulationsaufgaben ausführt, erreicht in der realen Welt 100 Prozent und in der Simulation 76 Prozent. Das beste Modell, das vor der Aktualisierung der Rangliste in dieser Woche verzeichnet war – ein offenes System namens Hy-Embodied-0.5-VLA – erreichte in der Simulation 8,8 Prozent. Bei Aufgaben, die das Verstehen einer unbekannten gesprochenen Anweisung anstelle einer auswendig gelernten erforderten, lag die Bestleistung aller getesteten Modelle bei 1,67 Prozent. Das ist der tatsächliche Stand der Technik, auf dem die Behauptung „GPT-6 geschlagen“ beruht. Meine These ist einfach: Die verkörperte KI hat genau jenen Benchmark-Hype-Fehlermodus wiederbelebt, der die frühen Ranglisten für Sprachmodelle diskreditiert hat – und zwar genau in dem Moment, in dem ihre eigenen Bewerter beweisen, wie weit das Feld noch zu gehen hat.
Die Zahl, die niemand wiederholte
Der Benchmark heißt RoboDojo, wurde vom Team hinter RoboTwin entwickelt und im Juli als wissenschaftliche Arbeit veröffentlicht. Er umfasst 42 simulierte Aufgaben und 18 reale Aufgaben, die von drei physischen Roboterarmen ausgeführt werden, und wird anhand von fünf separaten Leistungsdimensionen bewertet: Generalisierung, Gedächtnis, Präzision, langfristige Planung und offenes semantisches Verständnis. Es handelt sich nicht um eine Marketing-Rangliste. Es ist der Versuch, der verkörperten KI etwas zu geben, was Sprachmodelle bereits besitzen: eine standardisierte, veröffentlichte und durch Peer-Review überprüfbare Schwierigkeitskurve.
Diese Kurve ist von ihrer Konzeption her extrem anspruchsvoll, und die wissenschaftliche Arbeit sagt dies ganz offen: Modelle, die bei einer einstudierten Aufgabe kompetent wirken, versagen, sobald sich die Anweisung auch nur geringfügig ändert, und die
Der Einbruch ist gerade in jener Dimension am gravierendsten, die für einen Roboter, der in einem Haushalt oder einem Lagerhaus eingesetzt wird, in dem er nicht trainiert wurde, am wichtigsten ist. Ein Benchmark, der entwickelt wurde, um diese Lücke aufzudecken, erfüllt seinen Zweck, wenn die Ergebnisse niedrig ausfallen. Das Problem liegt nicht beim Benchmark. Das Problem ist, was geschieht, sobald eine neue Zahl daran angehängt wird.Was sich diese Woche tatsächlich geändert hat
Am 23. September wurde ein neuer Teilnehmer namens „Simate-beta“ mit einer Punktzahl von 33,95 – normiert 27,96 Prozent – in die Simulations-Rangliste von RoboDojo aufgenommen. Im Vergleich zur besten im Juli veröffentlichten Punktzahl von 8,8 Prozent ist das ein echter Sprung, und ich möchte darauf achten, diesen nicht zu schmälern: Etwas in der Trainingspipeline dieses Modells ist deutlich besser als das, was vor zehn Wochen noch vorhanden war. Simate selbst ist kaum älter als diese Verbesserung. Das Unternehmen wurde im Juni von einem ehemaligen Führungskraft eines Unternehmens für autonomes Fahren, einem Assistenzprofessor der HKUST, dessen Labor sich mit Weltmodellen befasst, und einem Ingenieur gegründet, der zuvor am Aufbau eines Start-ups im Bereich physikalischer KI mitgewirkt hatte, das später von Meta übernommen wurde. Das Unternehmen hat in mehreren Finanzierungsrunden innerhalb von drei Monaten einen nicht genannten Betrag aufgebracht, der lediglich als „Hunderte Millionen RMB“ (nach aktuellem Wechselkurs mehrere zehn Millionen US-Dollar) beschrieben wird, und zwar von Investoren, deren Namen nicht genannt wurden.
Nichts davon ist an sich schon ein Ausschlusskriterium. Schnelles Geld im Streben nach echtem technischem Fortschritt – so hat diese Branche schon immer funktioniert. Was jeden Leser jedoch stutzig machen sollte, ist die folgende Tatsache: Die Behauptung, ein Ergebnis an der Spitze der Rangliste erzielt zu haben, gelangte an die Öffentlichkeit, bevor eine unabhängige Stelle die Ergebnisse überprüft hatte. Einer der sorgfältigeren Berichte über diese Geschichte formulierte dies in klarer Sprache: Das Ergebnis wurde als selbst gemeldet beschrieben, ohne unabhängige Nachprüfung, und es wurde darauf hingewiesen, dass der eigene technische Bericht von Simate für einen späteren Zeitpunkt zurückgehalten wurde. Ein unbestätigtes Ergebnis von 27,96 Prozent wird vom Markt als „GPT-6 übertroffen“ interpretiert.
Eine Geschichte von zwei Ranglisten
Vergleichen Sie dies mit RoboCasa, einem konkurrierenden Benchmark eines anderen akademischen Teams, der bereits lange genug läuft, um entsprechende Erkenntnisse zu gewinnen
RoboDojo musste dies bislang noch nicht lernen. Die Einreichungsregeln von RoboCasa schreiben vor, dass bei jedem Closed-Source-Modell den Betreibern des Benchmarks vor der Veröffentlichung einer Punktzahl privater Zugriff auf das Modell und dessen Code gewährt werden muss. Open-Source-Einreichungen werden hingegen öffentlich überprüft, da der Code direkt im Pull-Request enthalten ist. In dieser Rangliste erreichen nun drei verschiedene verifizierte Systeme bei ihrem Aufgabensatz 70 bis 80 Prozent: eine GR00T-Version in Kombination mit einem Weltmodell-Add-on mit 72,6 Prozent, eine von Xiaomi entwickelte Richtlinie mit 74,5 Prozent sowie ein weiteres System mit 79,2 Prozent.Lassen Sie diesen Kontrast einen Moment auf sich wirken. Zwei Benchmarks, zwei Forschungsgemeinschaften, zwei unterschiedliche Bilder davon, wie weit die verkörperte KI bereits fortgeschritten ist – und der Unterschied liegt nicht in erster Linie darin, wessen Roboter intelligenter sind. Es geht um die Aufgabengestaltung – fünf anspruchsvolle Dimensionen im Vergleich zu einer gut einstudierten Küche – sowie um die Verifizierung: eine Anforderung des privaten Zugriffs im Gegensatz zu einer nach wie vor informellen Aktualisierung der Rangliste. Ein Leser, der die 27,96 Prozent von RoboDojo mit den 79,2 Prozent von RoboCasa vergleicht und daraus Rückschlüsse auf die relative Modellqualität zieht, hat nichts Wahres gelernt. Dieser Vergleich ist nicht wie Äpfel mit Birnen. Es handelt sich nicht einmal um Obst.
Was die Hardware tatsächlich kostet
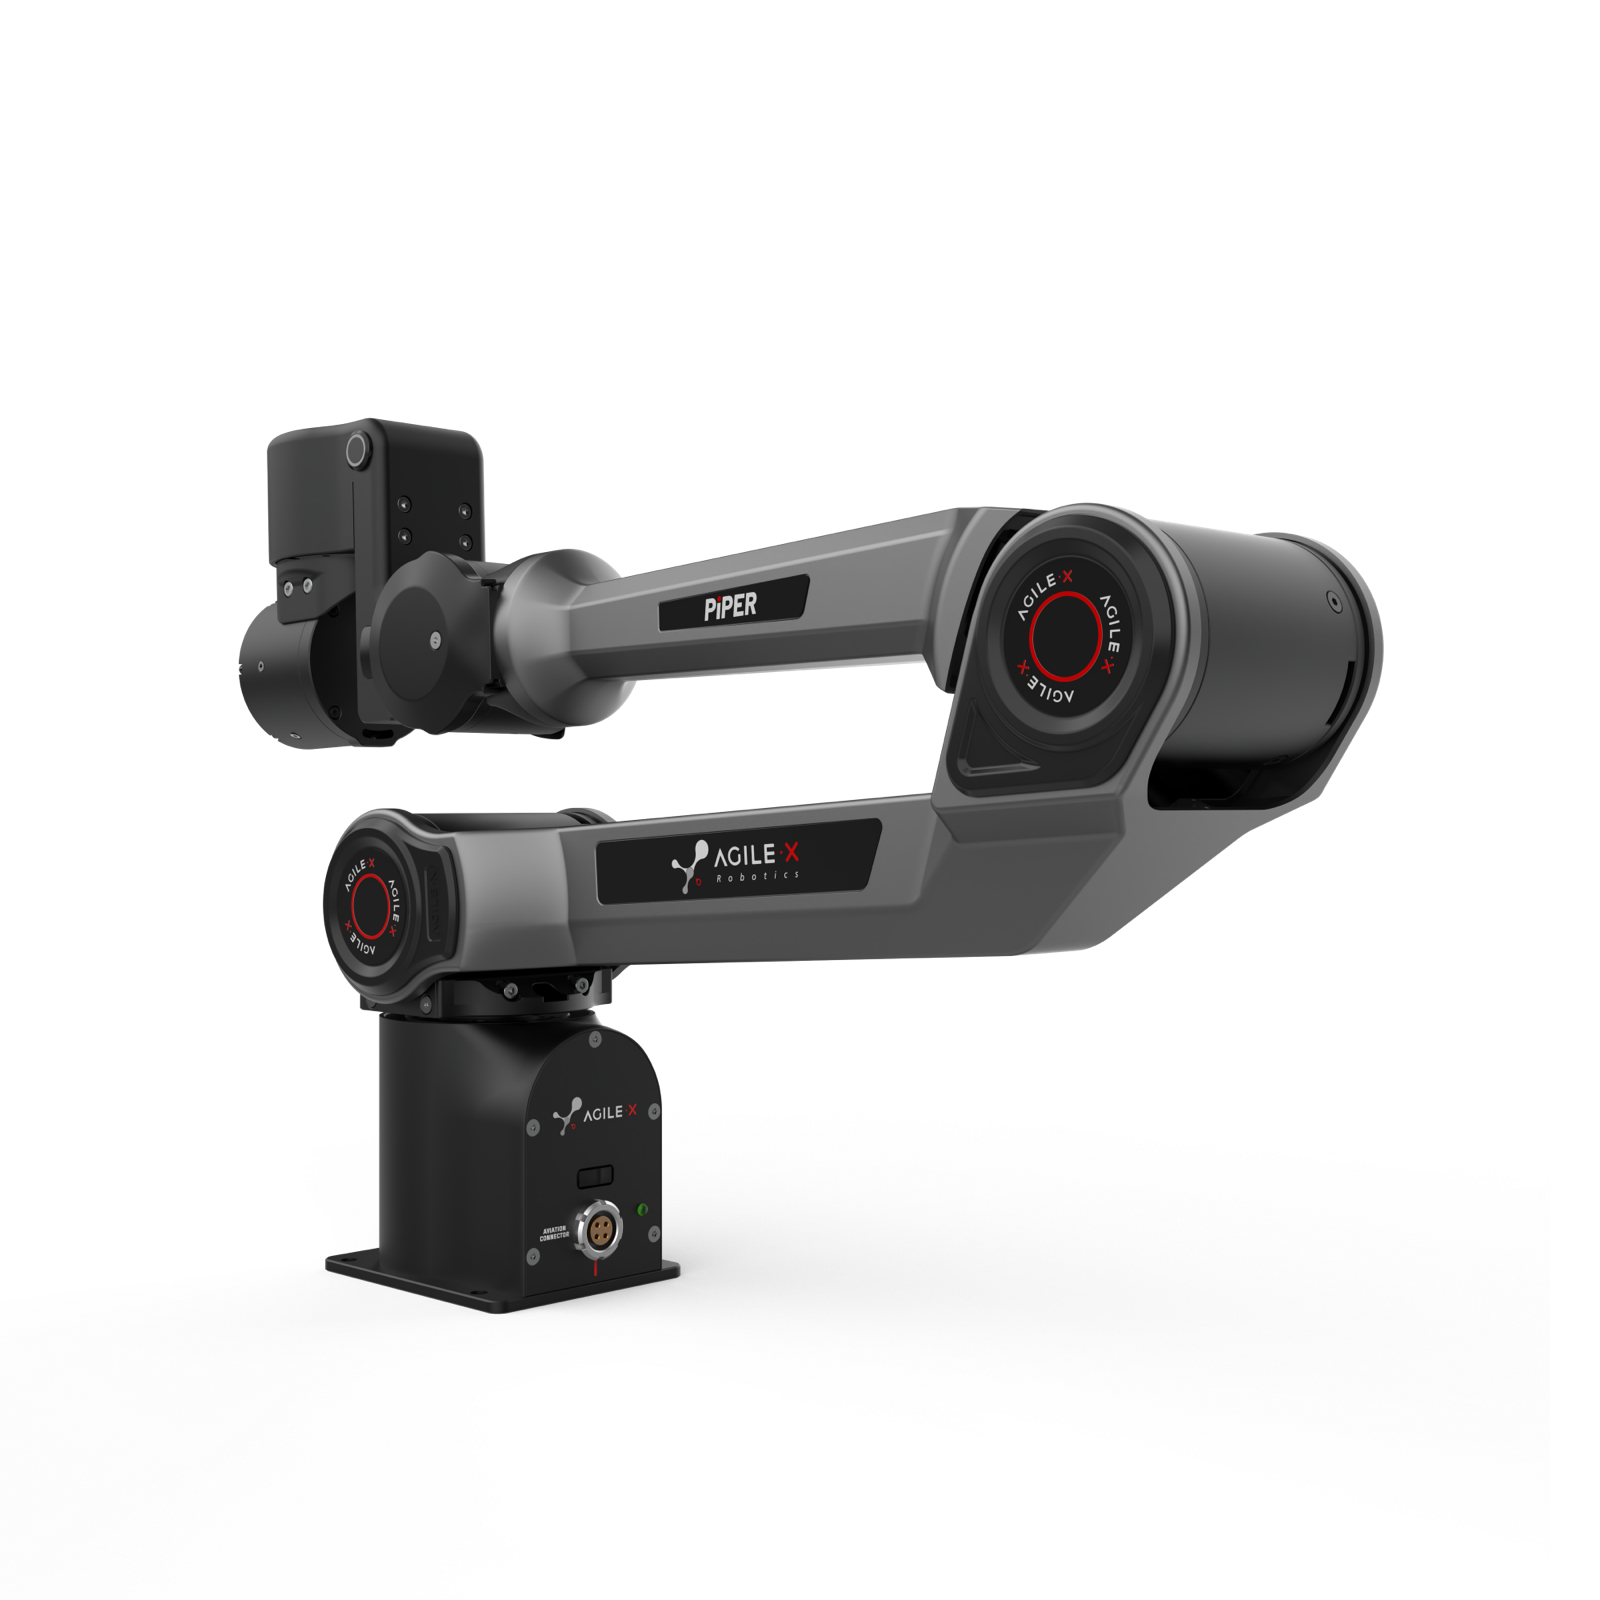
Ich habe eine mentale Korrekturmaßnahme für Hype-Zyklen wie diesen parat, die auf jahrelanger Pflege einer Taxonomie darüber basiert, was Roboter sind und was sie tatsächlich leisten: Suchen Sie den Teil der Geschichte, den niemand vermarktet. In diesem Fall ist es der Arm. Die realen Aufgaben von RoboDojo laufen unter anderem auf dem „Piper X“ von AgileX Robotics, einem sechsachsigen Roboterarm, der auf der firmeneigenen Website mit 1.999 US-Dollar vor Versandkosten und Steuern aufgeführt ist. Das Modell, das als „GPT-6-Killer“ gefeiert wird, ist in seiner physischen Form ein Roboterarm zum Desktop-Preis, der Aufgaben ausführt, bei denen er in der Simulation noch immer etwa sieben von zehn Mal versagt – und in der Praxis sogar noch schlechter abschneidet. Das ist kein Vorwurf an die Hardware, die für diesen Preis ein wirklich leistungsfähiges Stück Technik darstellt. Es ist vielmehr eine Richtigstellung einer Schlagzeile, die Ihnen etwas vorstellen möchte, das näher
zu einem Humanoiden, der morgen eine Fabrik betritt.Was ich mir als Nächstes ansehen würde
Die ehrliche Version dieser Geschichte lautet nicht: „China hat den Westen in der Robotik überholt.“ Sie lautet vielmehr: „Ein von seriösen Forschern entwickelter Benchmark tut genau das, wofür er konzipiert wurde, und der Medienrummel um einen seiner neuen Einträge verläuft genau so, wie es bei Medienberichten über Ranglistenangaben stets der Fall ist.“ Ich habe zwei Jahre lang beobachtet, wie sich genau dieses Muster bei Sprachmodellen wiederholte, bevor die Bewerter „Held-out“-Testsätze erstellten und unabhängige Prüfungen durchführten, denen die Menschen tatsächlich vertrauten. Die verkörperte KI durchläuft nun ihre eigene Version derselben Lektion – bei einem schwierigeren Problem und mit einem kürzeren Gedächtnis.
Was ich als Nächstes im Auge behalten werde, ist nicht, ob sich die Zahl von Simate bestätigt – obwohl ich hoffe, dass jemand dies überprüft. Vielmehr geht es darum, ob die Betreuer von RoboDojo noch vor der nächsten viralen Ranglistenbehauptung eine Regelung ähnlich der Zugangsbeschränkung von RoboCasa einführen und ob der nächste Gründer, der diese Rangliste anführt, den technischen Bericht vor der Schlagzeile und nicht erst danach veröffentlicht. Solange keines dieser beiden Ereignisse eintritt, lautet die ehrliche Einschätzung jeder Behauptung vom Typ „GPT-6 geschlagen“ in diesem Bereich gleich: nicht verifiziert, noch nicht, und wahrscheinlich nicht das, wonach es klingt.
Diese Kolumne spiegelt die eigene Analyse des Autors von öffentlich zugänglichen Benchmark-Unterlagen, Unternehmenserklärungen und wissenschaftlichen Veröffentlichungen wider, die zum Stand vom 27. September 2026 aktuell sind. Sie dient ausschließlich allgemeinen Informationszwecken und stellt keine Anlage-, Finanz- oder Rechtsberatung dar.
Titelbild: Der Roboterarm PiPER-X von AgileX Robotics, eine der physischen Plattformen, die bei den realen Bewertungstests von RoboDojo zum Einsatz kommen; offizielles Produktfoto. Bildnachweis: AgileX Robotics.











