Simate 宣稱在「Robotics」項目上「擊敗了 GPT-6」。但其自身的排行榜顯示成績為 27.96%。
一家成立僅三個月的新創公司聲稱在機器人學基準測試中「擊敗了 GPT-6」,此消息本週在未經查證的情況下迅速瘋傳;然而,該基準測試本身公布的數據顯示,即使是排行榜首的模型,與 100% 人類基準相比,仍無法完成大多數真實世界的操作任務。

一家在三月時還不存在的公司,本週登上了機器人操控排行榜的榜首,而傳播最廣的說法是,該公司已「超越 GPT-6-Astra 和 DeepMind」,奪得全球第一名。 這項聲明並未附上任何分數。沒有日期、沒有排行榜條目、也無法透過任何管道進行核實。它就這樣廣為流傳,就像這類聲明原本就設計成要這樣傳播一樣。
但有件事並未隨之流傳開來:這家企業所超越的基準測試本身會公布其數據,而這些數據顯示,該領域目前仍處於蹣跚學步的階段。人類在完成相同的操作任務時,在真實世界中的得分為100%,在模擬環境中則為76%。 在本週排行榜更新之前,紀錄中表現最佳的模型——一個名為 Hy-Embodied-0.5-VLA 的開放系統——在模擬環境中僅獲得 8.8% 的得分。在需要理解陌生口頭指令(而非背誦指令)的任務中,所有受測模型的最高得分僅為 1.67%。 這正是「擊敗 GPT-6」這項主張所立足的實際現狀。我的論點很簡單:就在具身人工智慧的評估者們正證明該領域仍有漫長路要走之際,它卻恰恰重現了當年使早期語言模型排行榜聲名狼藉的「基準測試炒作失敗模式」。
那個無人能複製的數字
該基準測試名為 RoboDojo,由 RoboTwin 開發團隊打造,並於七月以正式論文形式發表,涵蓋三組實體機械手臂執行的 42 項模擬任務與 18 項真實世界任務,並針對五項獨立能力維度進行評分:泛化能力、記憶力、精準度、長程規劃以及開放式語義理解。 這並非行銷性質的排行榜,而是試圖賦予具身人工智慧(embodied AI)一項語言模型早已具備的特質——一套標準化、公開且經同行評審的難度曲線。
這條曲線在設計上極為嚴苛,論文也直言不諱:那些在預先排練的任務中看似游刃有餘的模型,一旦指令稍有改變便會徹底崩潰,而
在機器人於未經訓練的家庭或倉庫環境中運作時,其表現最糟糕的恰恰是那個至關重要的層面。若某項旨在揭露此差距的基準測試所獲得的分數偏低,便表示該測試確實發揮了應有的作用。問題不在於基準測試本身,而在於當新的數值被硬性套用至該基準測試的瞬間所產生的後果。本週實際發生了什麼變化
9月23日,RoboDojo的模擬排行榜上新增了一位名為 Simate-beta 的新參賽者,其得分為 33.95,標準化後為 27.96%。 相較於 7 月份公布的最高分 8.8%,這確實是一個顯著的躍進,而我必須謹慎避免抹殺這個進展:該模型的訓練流程中,某個環節確實比十週前更為優異。Simate 這個專案本身,其歷史也僅比這項改進稍早一點。 該公司成立於六月,創始團隊包括一位來自自動駕駛公司的前高管、一位研究世界模型的香港科技大學助理教授,以及一位曾協助創建一家後被 Meta 收購的物理人工智慧新創公司的工程師。 該公司在三個月內歷經多輪融資,從未公開姓名的投資者處籌得一筆未披露的金額,僅被描述為「數億人民幣」(按當前匯率計算約為數千萬美元)。
這些情況本身並無不妥。快速資金追逐真正的技術突破,向來是這個產業的運作模式。但真正值得讀者警惕的是下一項事實:聲稱取得排行榜榜首成績的聲明,在任何獨立第三方重新驗證之前便已公諸於世。 其中一篇對此事報導較為謹慎的文章以直白語言指出這一點,將該結果描述為「自行宣稱」,並未經獨立重新驗證,同時指出 Simate 自身的技术報告將留待日後發布。 這個未經驗證的 27.96% 得分,正被市場解讀為「擊敗 GPT-6」。
兩個排行榜的故事
相較之下,由另一支學術團隊開發的競爭性基準測試 RoboCasa,運行時間已足夠長,足以從中汲取教訓
RoboDojo 目前還不需要學習這一點。根據 RoboCasa 自身的提交規則,任何閉源模型在發布分數之前,都必須授予基準測試維護者對該模型及其程式碼的私有存取權限。至於開源提交,則會以另一種方式進行公開驗證,因為程式碼就直接放在拉取請求中。 在該排行榜上,目前有三個不同的經驗證系統在其任務集上達到了 70% 至 80% 的準確率:一個搭配世界模型外掛的 GR00T 版本達 72.6%,一個由小米開發的策略達 74.5%,另一個系統則達 79.2%。請花一秒鐘細細體會這份對比。 兩個基準測試、兩個研究社群、兩幅關於具身人工智慧發展進程的不同圖景,而其中的差異主要並非在於哪一方的機器人更聰明。關鍵在於任務設計——五個艱難的維度與一個反覆演練過的廚房環境之別;更在於驗證機制——私有存取要求與仍屬非正式的排行榜更新之別。 若有讀者將 RoboDojo 的 27.96% 與 RoboCasa 的 79.2% 相比較,並據此推斷出任何關於相對模型品質的結論,那他根本什麼都沒學到。這種比較不僅是「蘋果與橘子」的對比,甚至連「農產品」都稱不上。
硬體的實際成本
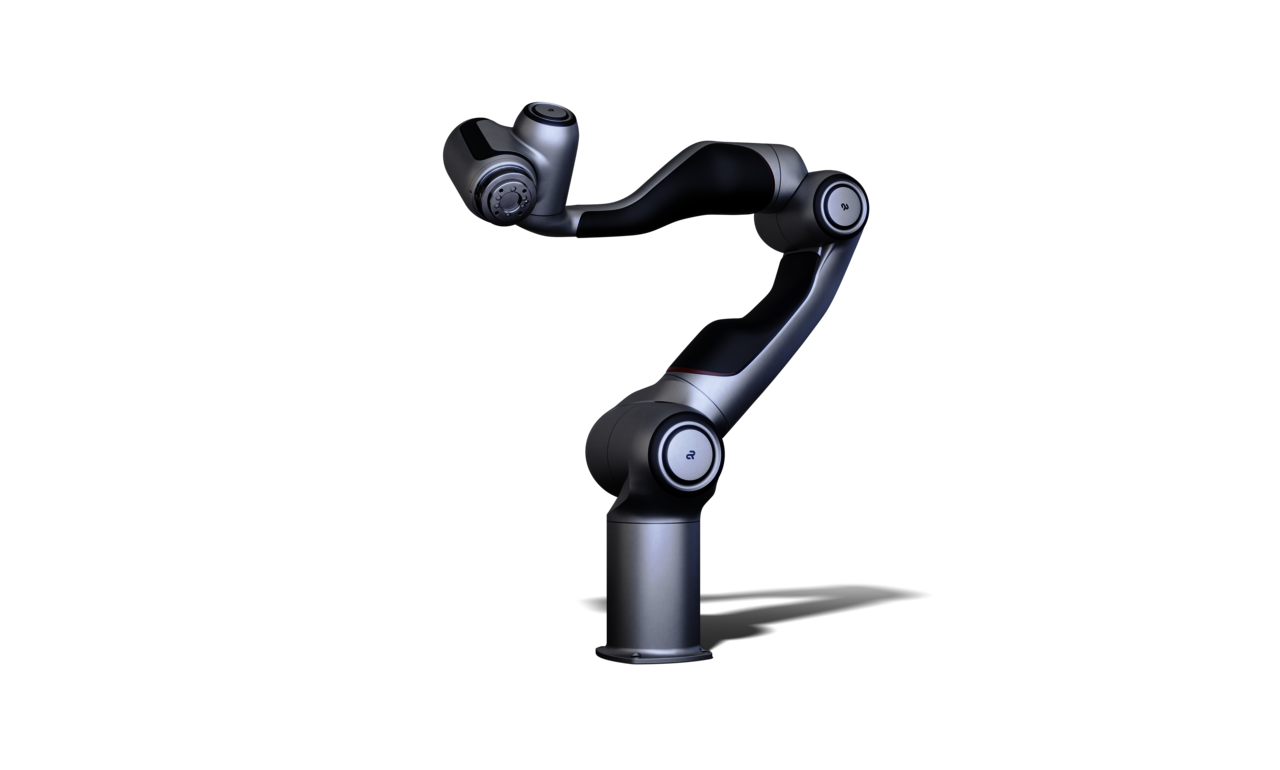
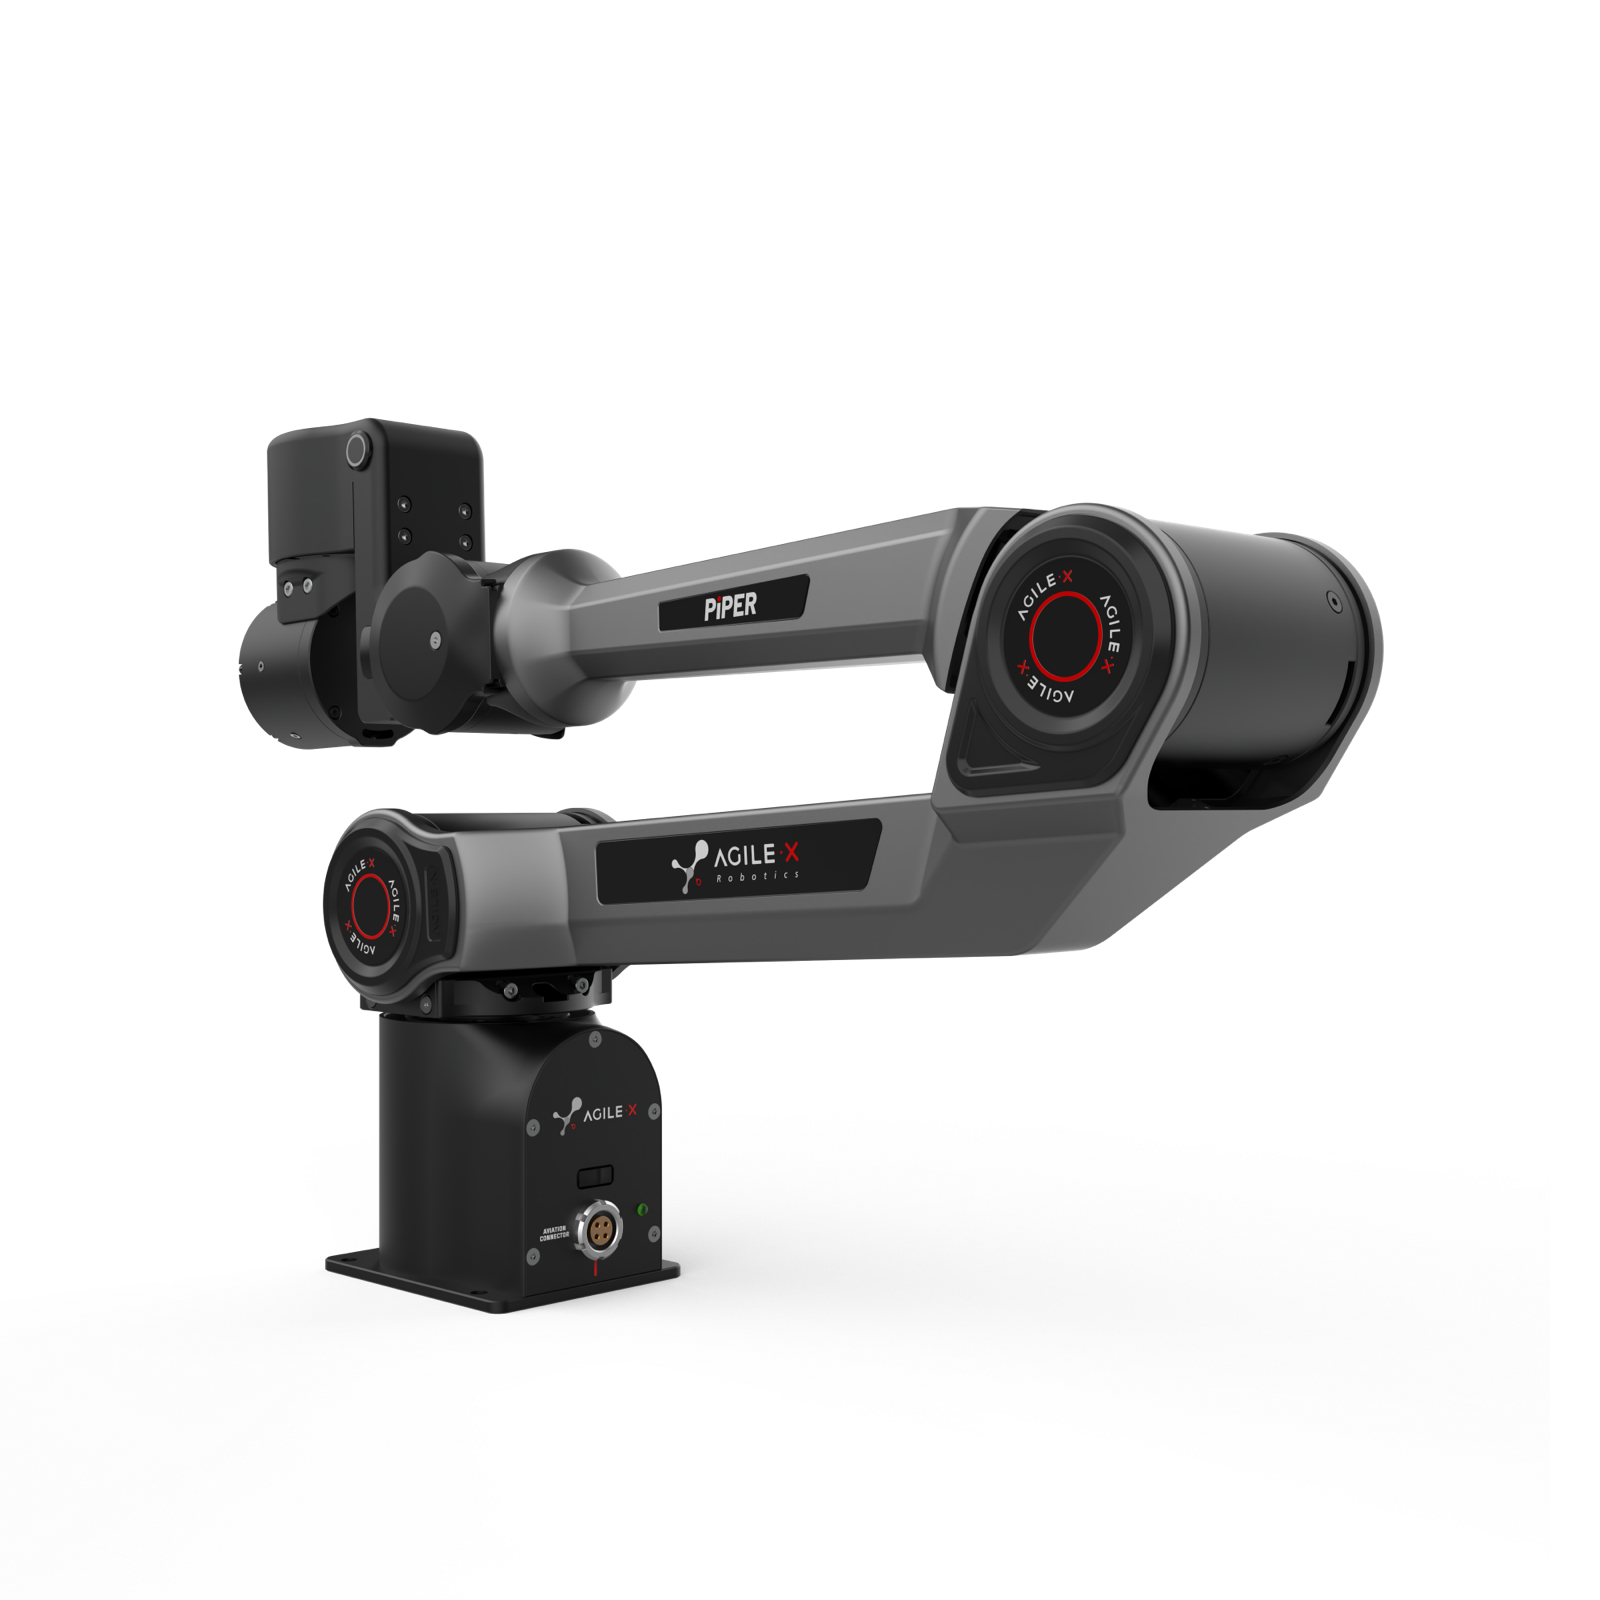
面對像這樣過度炒作的循環,我總會憑藉多年來對「機器人是什麼」以及「它們實際能做什麼」的分類體系所建立的經驗,在腦海中進行糾正:去尋找故事中那個無人宣傳的部分。 在這個案例中,關鍵就在於機械臂。RoboDojo 的實務任務運行於多個平台,其中包括 AgileX Robotics 的 Piper X——這是一款六軸機械臂,該公司官網標示價格為 1,999 美元(未含運費及稅金)。 這款被譽為「GPT-6殺手」的機型,其實體形態不過是一台價格與桌上型電腦相當的機械臂,執行任務時在模擬環境中約十次仍有七次失敗,而在真實世界中的表現更為糟糕。這並非在批評硬體本身——以這個價格而言,這確實是一項真正出色的工程傑作。 這只是對某則標題的糾正——該標題試圖讓你聯想某種更接近
到明天將有一名類人型機器人走進工廠。接下來我會關注什麼
這則新聞的真實版本並非「中國在機器人領域超越了西方」,而是「由嚴謹的研究人員建立的基準測試,正完全按照設計目的運作,而圍繞其新參賽者所引發的媒體熱潮,也完全複製了以往圍繞排行榜聲稱時一貫的媒體循環。」 我曾連續兩年目睹語言模型重演同樣的模式,直到評估者建立保留測試集,並進行了人們真正信賴的第三方審計。如今,具身人工智慧正經歷著這堂課的另一種版本——面對更艱鉅的問題,卻擁有更短暫的記憶。
接下來我關注的重點,並非 Simate 的數據能否經得起考驗——儘管我希望有人能進行驗證。 而是 RoboDojo 的維護者是否會在下一次引發熱議的排行榜聲稱出現之前,採納類似 RoboCasa 的「私有存取」要求;以及下一位登上該排行榜榜首的創辦人,是否會在頭條新聞發布之前而非之後,就公開技術報告。 在上述兩件事中任一發生之前,對該領域任何「擊敗 GPT-6」聲稱的客觀解讀都是一樣的:尚未經證實,目前仍未得到驗證,而且很可能並非表面所言那般。
本專欄反映作者對截至 2026 年 9 月 27 日公開的基準測試文件、公司聲明及學術出版物的個人分析。本文僅供一般資訊參考,不構成投資、財務或法律建議。
首圖:AgileX Robotics 的 PiPER-X 機械臂,這是 RoboDojo 實境評估任務中所使用的實體平台之一,官方產品照片。圖片來源:AgileX Robotics。