
機器人如何學習移動,以及為何「動作分段化」是物理智能中被低估的瓶頸
「視覺-語言-動作」模型能夠解析場景並遵循指令,但仍需將這種理解轉化為流暢、連續的動作。這種連結語言與運動控制的方法稱為「動作分段」,它已悄然成為機器人學習領域中最具影響力的設計選擇之一。
隱藏在每台智慧機器人內在的問題
現代機器人若能透過自然語言指令,完成摺疊襯衫或工作台上零件分類等任務,其運作基礎便是一種稱為「視覺語言動作」(Vision Language Action, VLA)的模型。其名稱已道出其功能:該模型首先接收視覺資訊,即場景的攝影機影像。 它會接收語言輸入,也就是指令及相關語境;接著必須產生動作,也就是驅動關節和夾爪的實際運動控制指令流。
該處理流程的前兩部分,大量借鑒了現已成熟的人工智慧技術。VLA 模型重複利用了視覺語言核心架構——這正是驅動圖像理解與聊天功能的模型家族,而這些核心架構是透過海量網路文本與圖像進行訓練的。第三部分才是機器人技術真正面臨的難題。 語言天生是離散的,由稱為「標記」(tokens)的有限詞彙片段構成,而變壓器(Transformer)模型會根據前面的標記來預測下一個標記。機器人的運動則截然不同。它是連續的、高頻率的,且具有物理特性。關節角度、末端執行器位置以及夾爪指令,皆以平滑的實數訊號流形式傳輸,每秒往往達數十次。
因此,在每台功能完善的機器人背後,都潛藏著一個問題,而研究界以外的大多數人從未聽聞此問:如何將連續運動轉化為令標記預測模型能夠學習並生成的形式? 答案就在於一個稱為「動作分段化(action tokenization)」的步驟,而團隊如何解決這個問題,將決定機器人的訓練速度、能達到何種靈巧程度,以及單一模型在不同機器間的遷移效果。
動作分片化究竟做什麼
分詞化是指將連續的動作片段(即未來動作的短時間視窗)轉換為一串離散符號,使模型能夠依序預測這些符號。在模型預測完這些
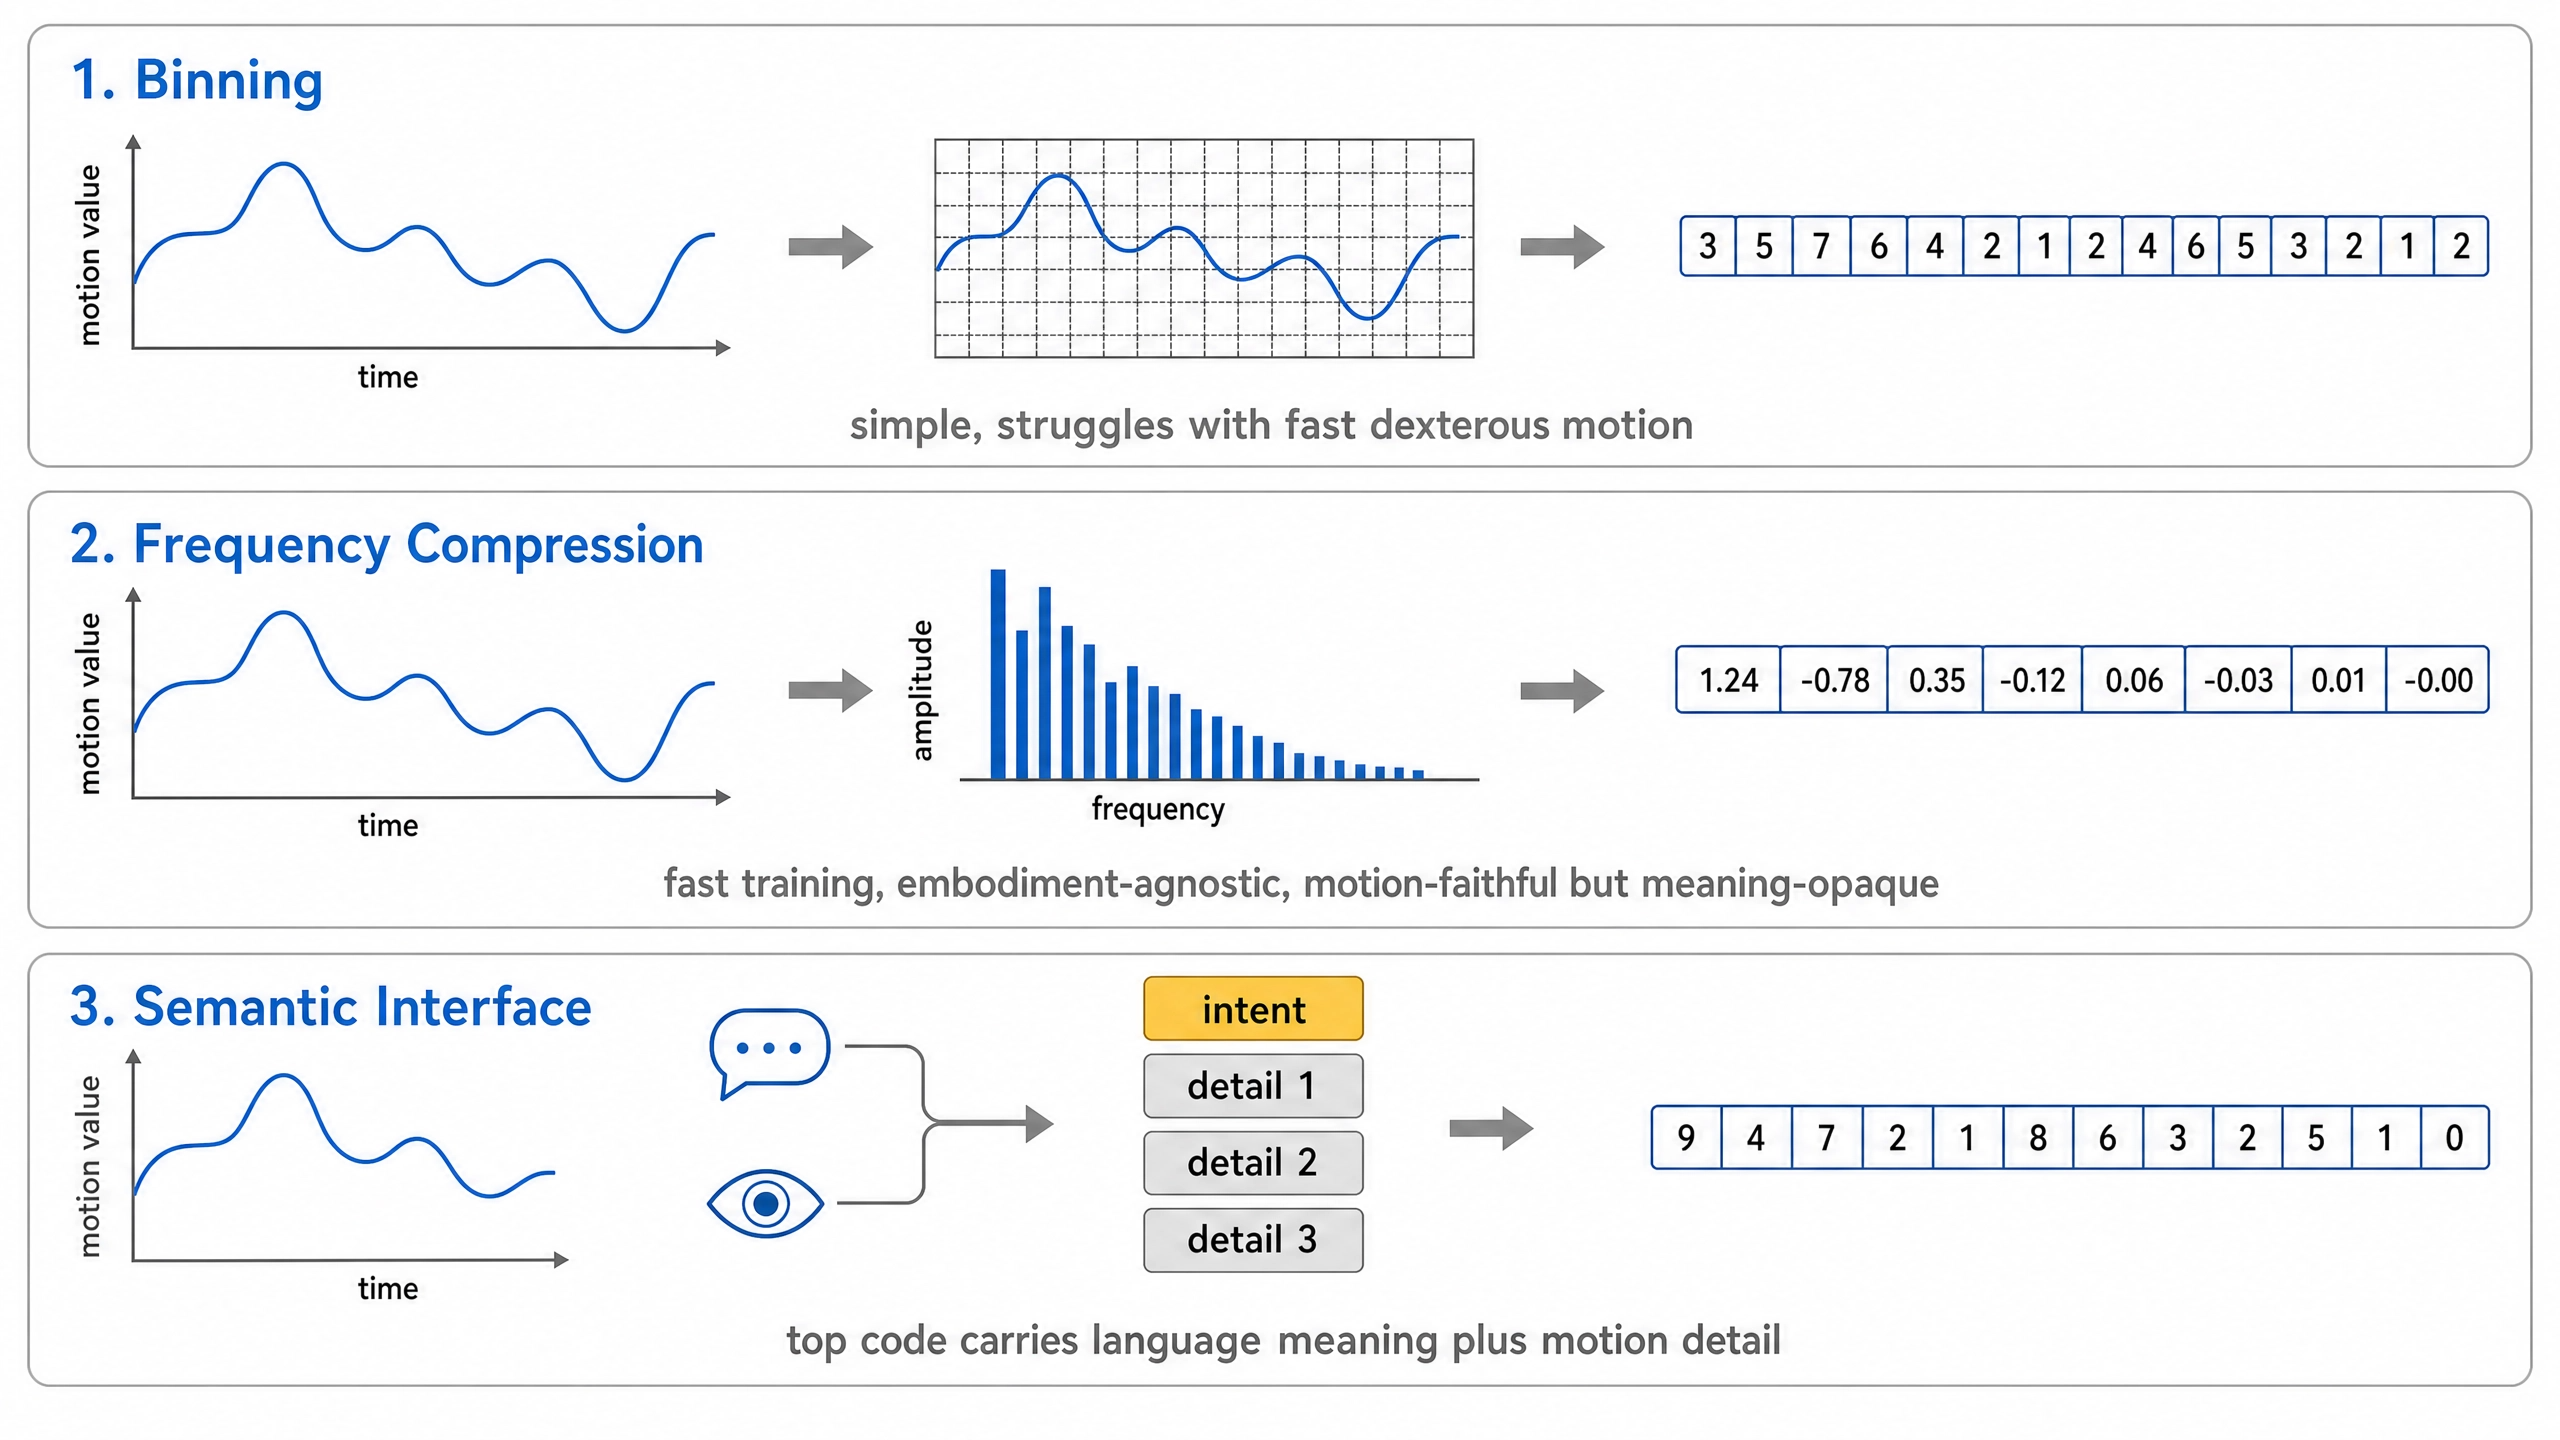
解碼器會將這些符號重新轉換為機器人可執行的連續指令。若您曾聽說過語言模型如何將文字拆解為次詞級標記,這正是運動控制領域的對應機制,兩者之間的類比絕非牽強。頂尖的機器人研究人員直接借鑒了使文字與圖像標記器得以運作的壓縮理念。這種選擇之所以重要,是因為分詞器並非中立的管道。它決定哪些資訊得以保留,哪些則被捨棄。若分詞器雖能忠實捕捉動作,卻打亂了連續時刻之間的關聯性,便可能導致訓練過程緩慢或不穩定;若分詞器壓縮過度,則可能模糊掉精巧任務所需的細微控制。 此外,若分詞器雖易於模型預測,卻與任務的意義脫節,則可能導致機器人動作流暢,卻難以遵循操作意圖。下圖展示了已浮現的三種主要理念,本文其餘部分將依序闡述。
方法一:分桶法——證明可行性的方法
首個廣為人知的示範,證明單一模型既能讀取網路資訊又能控制機器人,來自 2023 年 Google DeepMind 推出的「機器人變壓器 2 號」(Robotic Transformer 2,簡稱 RT-2)模型。該模型處理動作的方式十分直接:它將機器人動作—— 即末端執行器的位置與旋轉變化,加上夾爪指令,將每個維度切分成離散區間,再將這些區間寫出為一串看似普通文字的整數,例如 1 128 91 241 5 101 127 217 這樣的序列。 接著,標準的文字分詞器會處理該字串,這意味著機器人動作與網路數據能夠流經同一個模型,而無需重新設計該模型。
這在
能力。RT-2 在先前未見過的場景中,表現從前代模型的 32% 提升至 62%,且相較於早期基準模型,其在新興技能的泛化能力上更呈現出超過三倍的躍升。這證明了網路規模的知識能夠轉化為物理控制能力。 事後回顧,這也揭示了簡單分桶法的弱點。當動作快速且靈巧時,連續的動作標記之間會產生高度相關性,而下一個標記的預測器只需執行複製前一個標記這類簡單操作,便能獲得高分。這會使模型陷入劣質解中,也解釋了為何天真的分桶法往往僅限於較慢、較簡單的控制情境。第二種方法:頻率壓縮——讓模型運算加速的關鍵
Physical Intelligence 團隊與加州大學柏克萊分校及史丹佛大學的合作夥伴攜手,於 2025 年初透過一種名為「頻率空間動作序列分詞」(FAST)的方法,從根源上解決了相關性問題。 他們的洞見在於:應在訓練前對動作訊號進行壓縮,使代幣攜帶獨立資訊,而非相互重複。他們採用的是離散餘弦變換(DCT)技術——這與 JPEG 圖像檔案所使用的壓縮技術同屬一類,能將平滑訊號表示為一小組頻率成分。
實際成效相當顯著。該團隊發布了一個通用分詞器,該分詞器是基於一百萬組真實機器人動作軌跡(涵蓋單臂、雙臂及移動機器人)訓練而成,並證明其可作為現成的、與具體實現形式無關的組件使用。 當與其旗艦策略搭配使用時,這種基於頻率分詞的自迴歸模型可擴展至一萬小時的機器人數據,其表現可媲美更複雜的擴散式方法,而訓練速度卻快達五倍。頻率壓縮技術已逐漸成為各團隊的預設選擇
希望進行自迴歸訓練,同時避免分桶所帶來的不穩定性。這裡存在一個微妙的限制,而這也為接下來的構想奠定了基礎。 頻率標記雖能忠實反映動作,但在語義上卻不透明。這些代碼描述的是手臂如何移動,而非該動作相對於模型所接收指令的意義。視覺語言骨幹在意義空間中進行推理,而動作代碼則存在於訊號壓縮空間中,且沒有任何機制能迫使兩者對齊。
第三種方法——語義介面,旨在彌合此鴻溝
這正是最新進展——也是本文撰寫原因——登場之處。中國機器人公司 X Square Robot 旗下的一支團隊,與學術合作夥伴共同於 2026 年中發表了一款名為 X-Tokenizer 的標記器。其核心論點在於框架的轉變。 它不再將分詞視為純粹的壓縮過程,而是將分詞器視為一種語義介面——一個共享層,在該層中,動作編碼會被刻意與視覺語言模型已理解的語義對齊。
其運作機制是一個具有非對稱任務的四層殘差量化器。頂層代碼經過訓練,形成與模型對場景及指令的理解相吻合的粗略、離散動作詞彙表;而較深層級則專注於重建細微的動作細節。 實際上,第一個符號被賦予特定含義(例如動作的整體意圖),而後續符號則填補精確的執行細節。編碼器被引導將每個動作片段與骨幹網路對同一時刻的視圖相匹配——該視圖源自多角度鏡頭與任務語言——從而使動作代碼與感知特徵能夠使用共同的語言進行溝通。
報告中的結果是與頻率壓縮基準進行比較,而非與分桶法比較,這才是針對 2026 方法的正確對比方式。
該方法在 240 萬條軌跡和 17 種機器人手臂系列上進行訓練,並將分詞器凍結後重複使用(無需針對各任務進行微調),相較於頻率基準,其多模態錨定表現提升了 13.5%,長時程執行表現則提高了 8.25 分。 在高難度的雙臂基準測試中,當難度提升時,其表現退化程度低於領先的對照策略;且透過在不同機器人機體上聯合訓練單一模型,不僅未稀釋最困難任務的表現,反而提升了相關分數。這些結果目前仍僅限於模擬與桌面實驗室環境,因此僅指向一個有前景的方向,而非已確立的實際應用優勢,這一點值得留意。並列比較
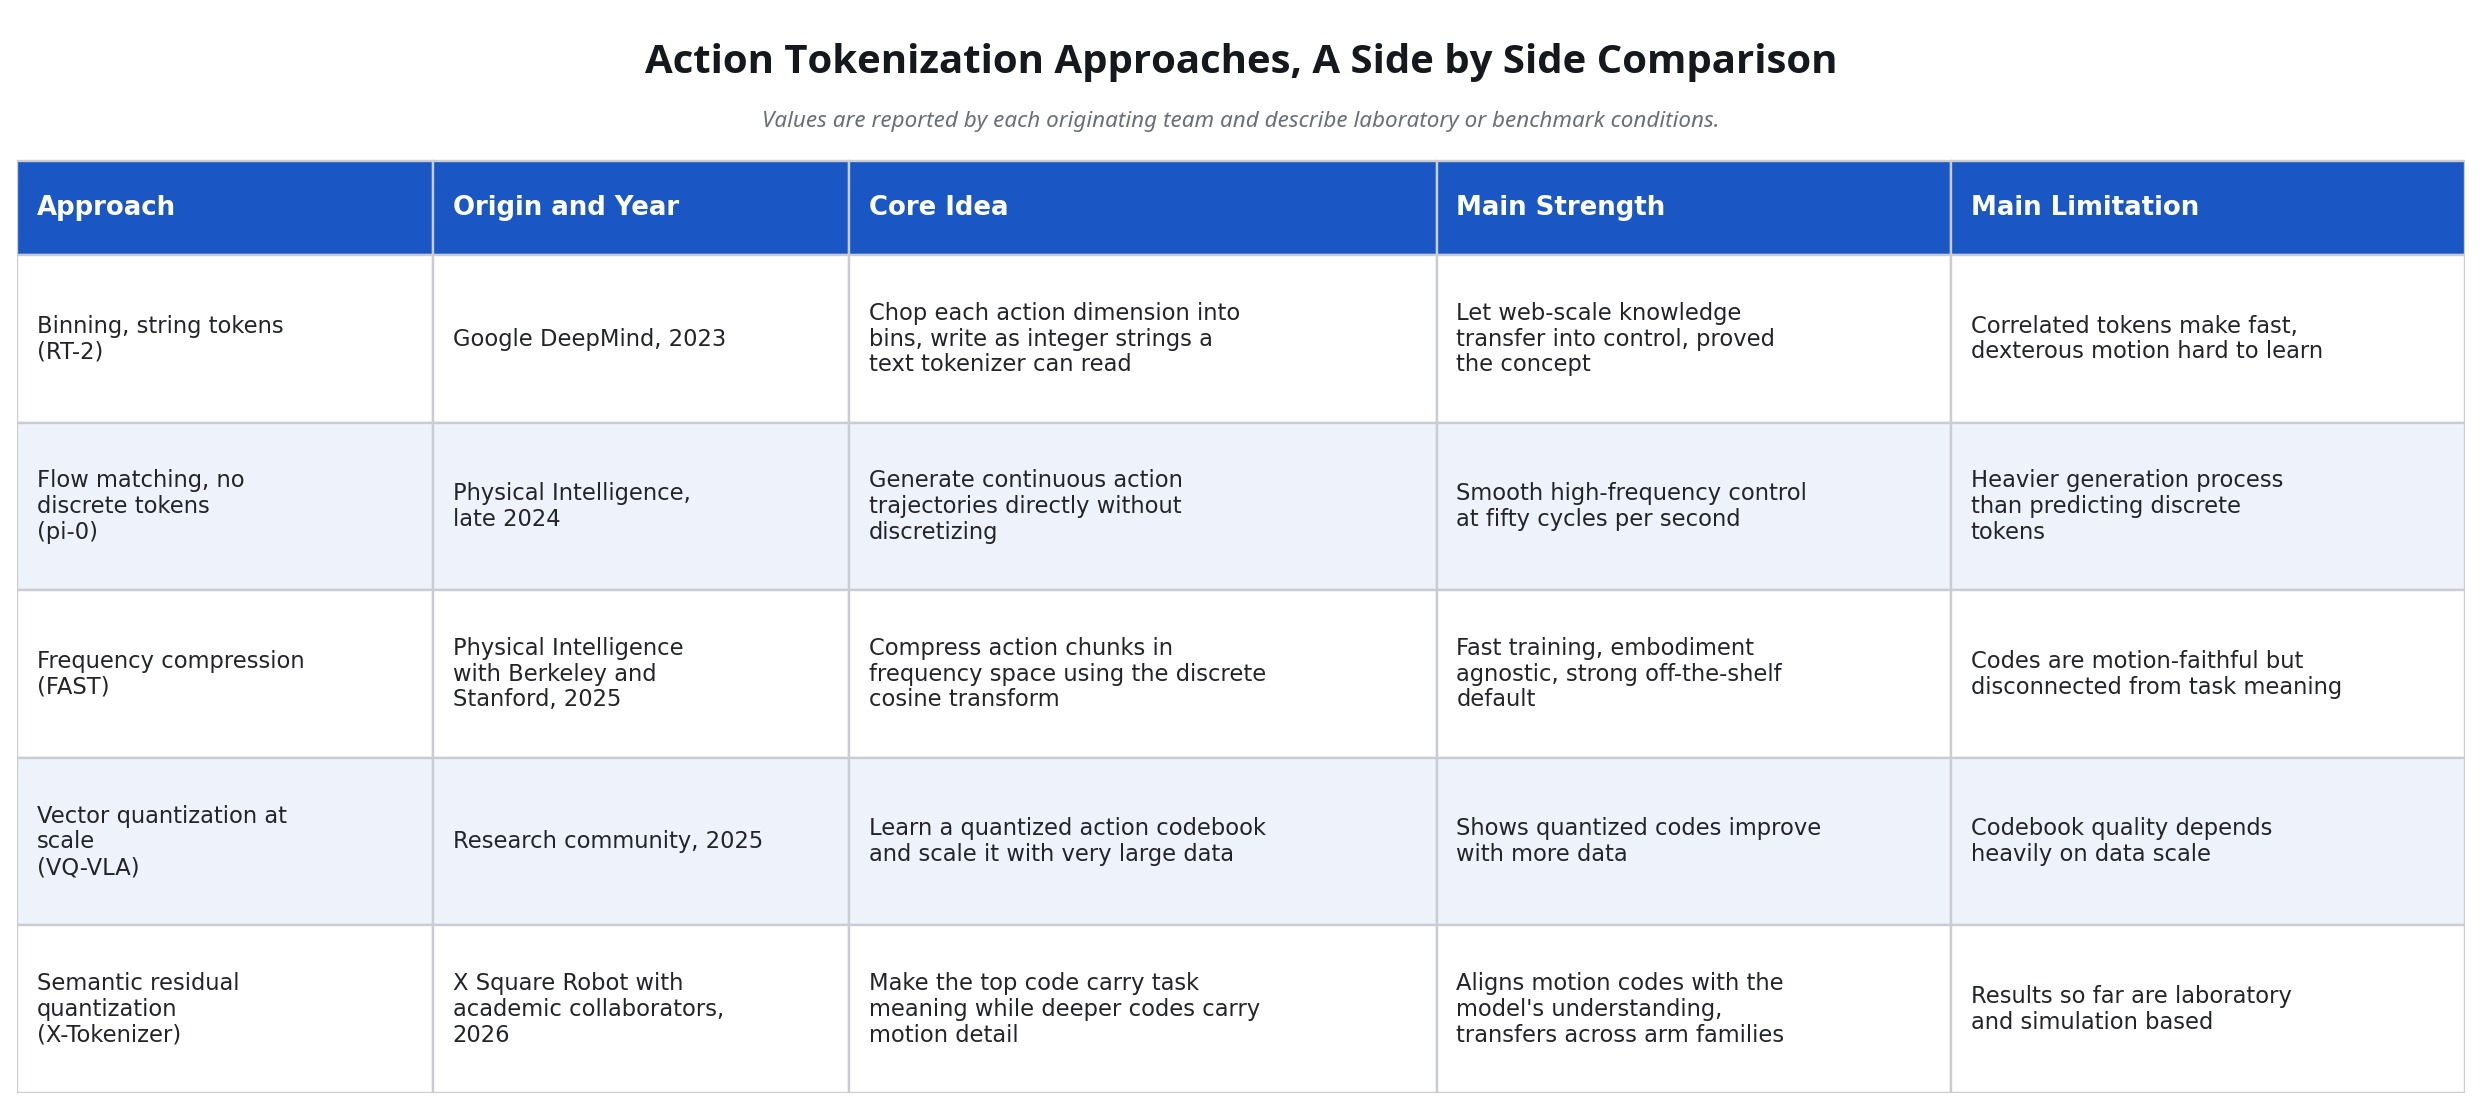
下表彙整了領先的方法及其各自代表的设计权衡。所列數值均依據各原始研究團隊的報告。
一語道破前沿爭論
若撇開工程細節不談,該領域的爭論其實聚焦於一個核心問題。 動作標記器應否成為保持簡單、快速且不關心語義的中立壓縮器(即「頻率壓縮觀點」),抑或應成為將動作與語言綁定、使機器人的理解與動作共享同一詞彙表的主動參與者(即「語義介面觀點」)? 第三種陣營則完全迴避這個問題,直接透過「流動匹配」生成連續動作,完全不使用離散代碼。目前尚無定論,最可能的結果是:不同的部署需求將傾向於不同的解決方案。
給採購人員的自動化、機器人技術與物理智慧閱讀指南
對於營運人員或採購團隊而言,這看似只是一場學術辯論,直到將其與成本及
風險確實存在,且兩者之間確實存在關聯。部署機器人時,成本最高的環節極少是機械臂本身,而是資料蒐集、針對各任務的調校,以及當一個場域運行多種類型的機器時所需的整合工作。 動作分詞技術恰恰位於這些成本中心之上,因為它決定了已訓練好的策略能多輕鬆地從基準環境轉移到實際生產環境,以及從一個機器人機體轉移到另一個機器人機體。採購方應從中汲取三項實務要點。首先,標記器是轉移的槓桿。一種不依賴具體機體、或能在無需重新訓練的情況下跨多種機械臂家族進行轉移的標記器,能直接降低混合機隊的整合成本,因為團隊無需為每台機器重新建構運動層。 其次,訓練速度是預算考量關鍵。能將訓練時間縮短數倍的頻率壓縮成果絕非小事,這意味著部署迭代週期可從數週縮短至數天。第三,也是最重要的,實驗室宣稱的提升效果不等同於實際現場表現。 本文討論的每種方法,其最佳數據皆來自基準測試與實驗室任務;因此,買方在評估供應商時,應要求對方提供在擬購的特定機器人上、執行與預期工作相似的任務,並在現實的干擾與週期時間條件下所獲得的實際結果,而非僅接受標榜的基準測試數字。
未來兩年更深層的訊號在於:在實體智慧領域中,行動層——而不僅是背後語言模型的規模——正逐漸成為競爭的戰場。 那些能將動作與語義整合為同一套詞彙體系,並能讓單一訓練好的策略在不同機器間無縫移植的團隊,將在部署經濟性上擁有實質優勢。這正是採購團隊應追蹤的指標,因為唯有此指標才能將實驗室成果轉化為營運預算中的具體項目。
來源
證據說明本解說文所參考的主要及權威來源:
• Google DeepMind,《RT-2 公告與方法說明》,2023 年 7 月 28 日,以及相關論文《RT-2:視覺語言動作模型將網路知識轉移至機器人控制》,arXiv 2307.15818。
• Pertsch 及其同事,FAST:《視覺語言動作模型的高效動作分詞》,與加州大學柏克萊分校及史丹佛大學合作的「物理智能」計畫,arXiv 2501.09747,2025年1月。
• Physical Intelligence pi-0 及 pi-0-FAST 技術說明,包含流程匹配動作生成機制,詳見 Hugging Face LeRobot 模型發布文件,2025年2月。
• VQ-VLA,《透過可擴展向量量化動作分詞器改進視覺語言動作模型》,arXiv 2507.01016,2025年。
• X-Tokenizer,由 X Square Robot 與學術合作夥伴共同開發的跨模態具身動作分詞器,arXiv 2606.14752,2026 年 6 月提交,附有相關專案頁面、程式碼儲存庫及模型卡。 技術主張(包括相較於頻率壓縮基準模型所報告的 13.5% 多模態錨定增益及 8.25 點的長時域增益)均已根據原始研究資料進行驗證。
本文中所有比較數據均採用原始研究團隊所發表的數值,除非另有說明,否則均描述實驗室或基準測試條件。












