
机器人如何学习运动,以及为何动作分段是物理智能中一个被忽视的瓶颈
Vision Language Action 模型能够解读场景并执行指令,但它们仍需将这种理解转化为流畅、连续的动作。这种连接语言与运动控制的方法被称为“动作分段”,它已悄然成为机器人学习领域最具影响力的设计选择之一。
隐藏在每台智能机器人内部的问题
如今,那些能通过自然语言指令完成折叠衬衫或工作台上零件分拣等任务的现代机器人,其运行基础是一种被称为“视觉-语言-动作”(VLA)模型的类。这个名称恰如其分地描述了其功能。该模型首先接收视觉信息,即场景的摄像头图像。 它还接收语言输入,即指令及相关上下文信息。随后,它需要生成动作,即驱动关节和机械手实际运行的运动控制指令流。
该处理流程的前两部分大量借鉴了现有的成熟人工智能技术。VLA模型复用了视觉语言基础架构——这与驱动图像理解和聊天功能的模型属于同一家族,且这些基础架构都是在海量的互联网文本和图像数据上训练而成的。而第三部分,才是机器人技术真正面临挑战的地方。 语言天生是离散的,由称为“令牌”的有限词汇片段构成,而Transformer模型会根据前面的令牌来预测下一个令牌。机器人的运动则截然不同。它是连续的、高频的,且具有物理特性。关节角度、末端执行器位置以及夹爪指令以平滑的实数值信号流的形式传输,通常每秒数十次。
因此,在每一台功能强大的机器人背后,都潜藏着一个问题,而研究界以外的大多数人从未听说过这个问题:如何将连续运动转化为令令牌预测模型能够学习和生成的形式? 答案在于一个名为“动作分词”的步骤,而团队解决这一问题的方案,将决定机器人训练的速度、其能达到的灵巧程度,以及单一模型在不同机器间迁移的效果。
动作分段化究竟起什么作用
分词是指将连续的动作片段(即未来运动的短时间窗口)转换为一串离散符号的过程,模型可以依次预测这些符号。在模型预测完这些
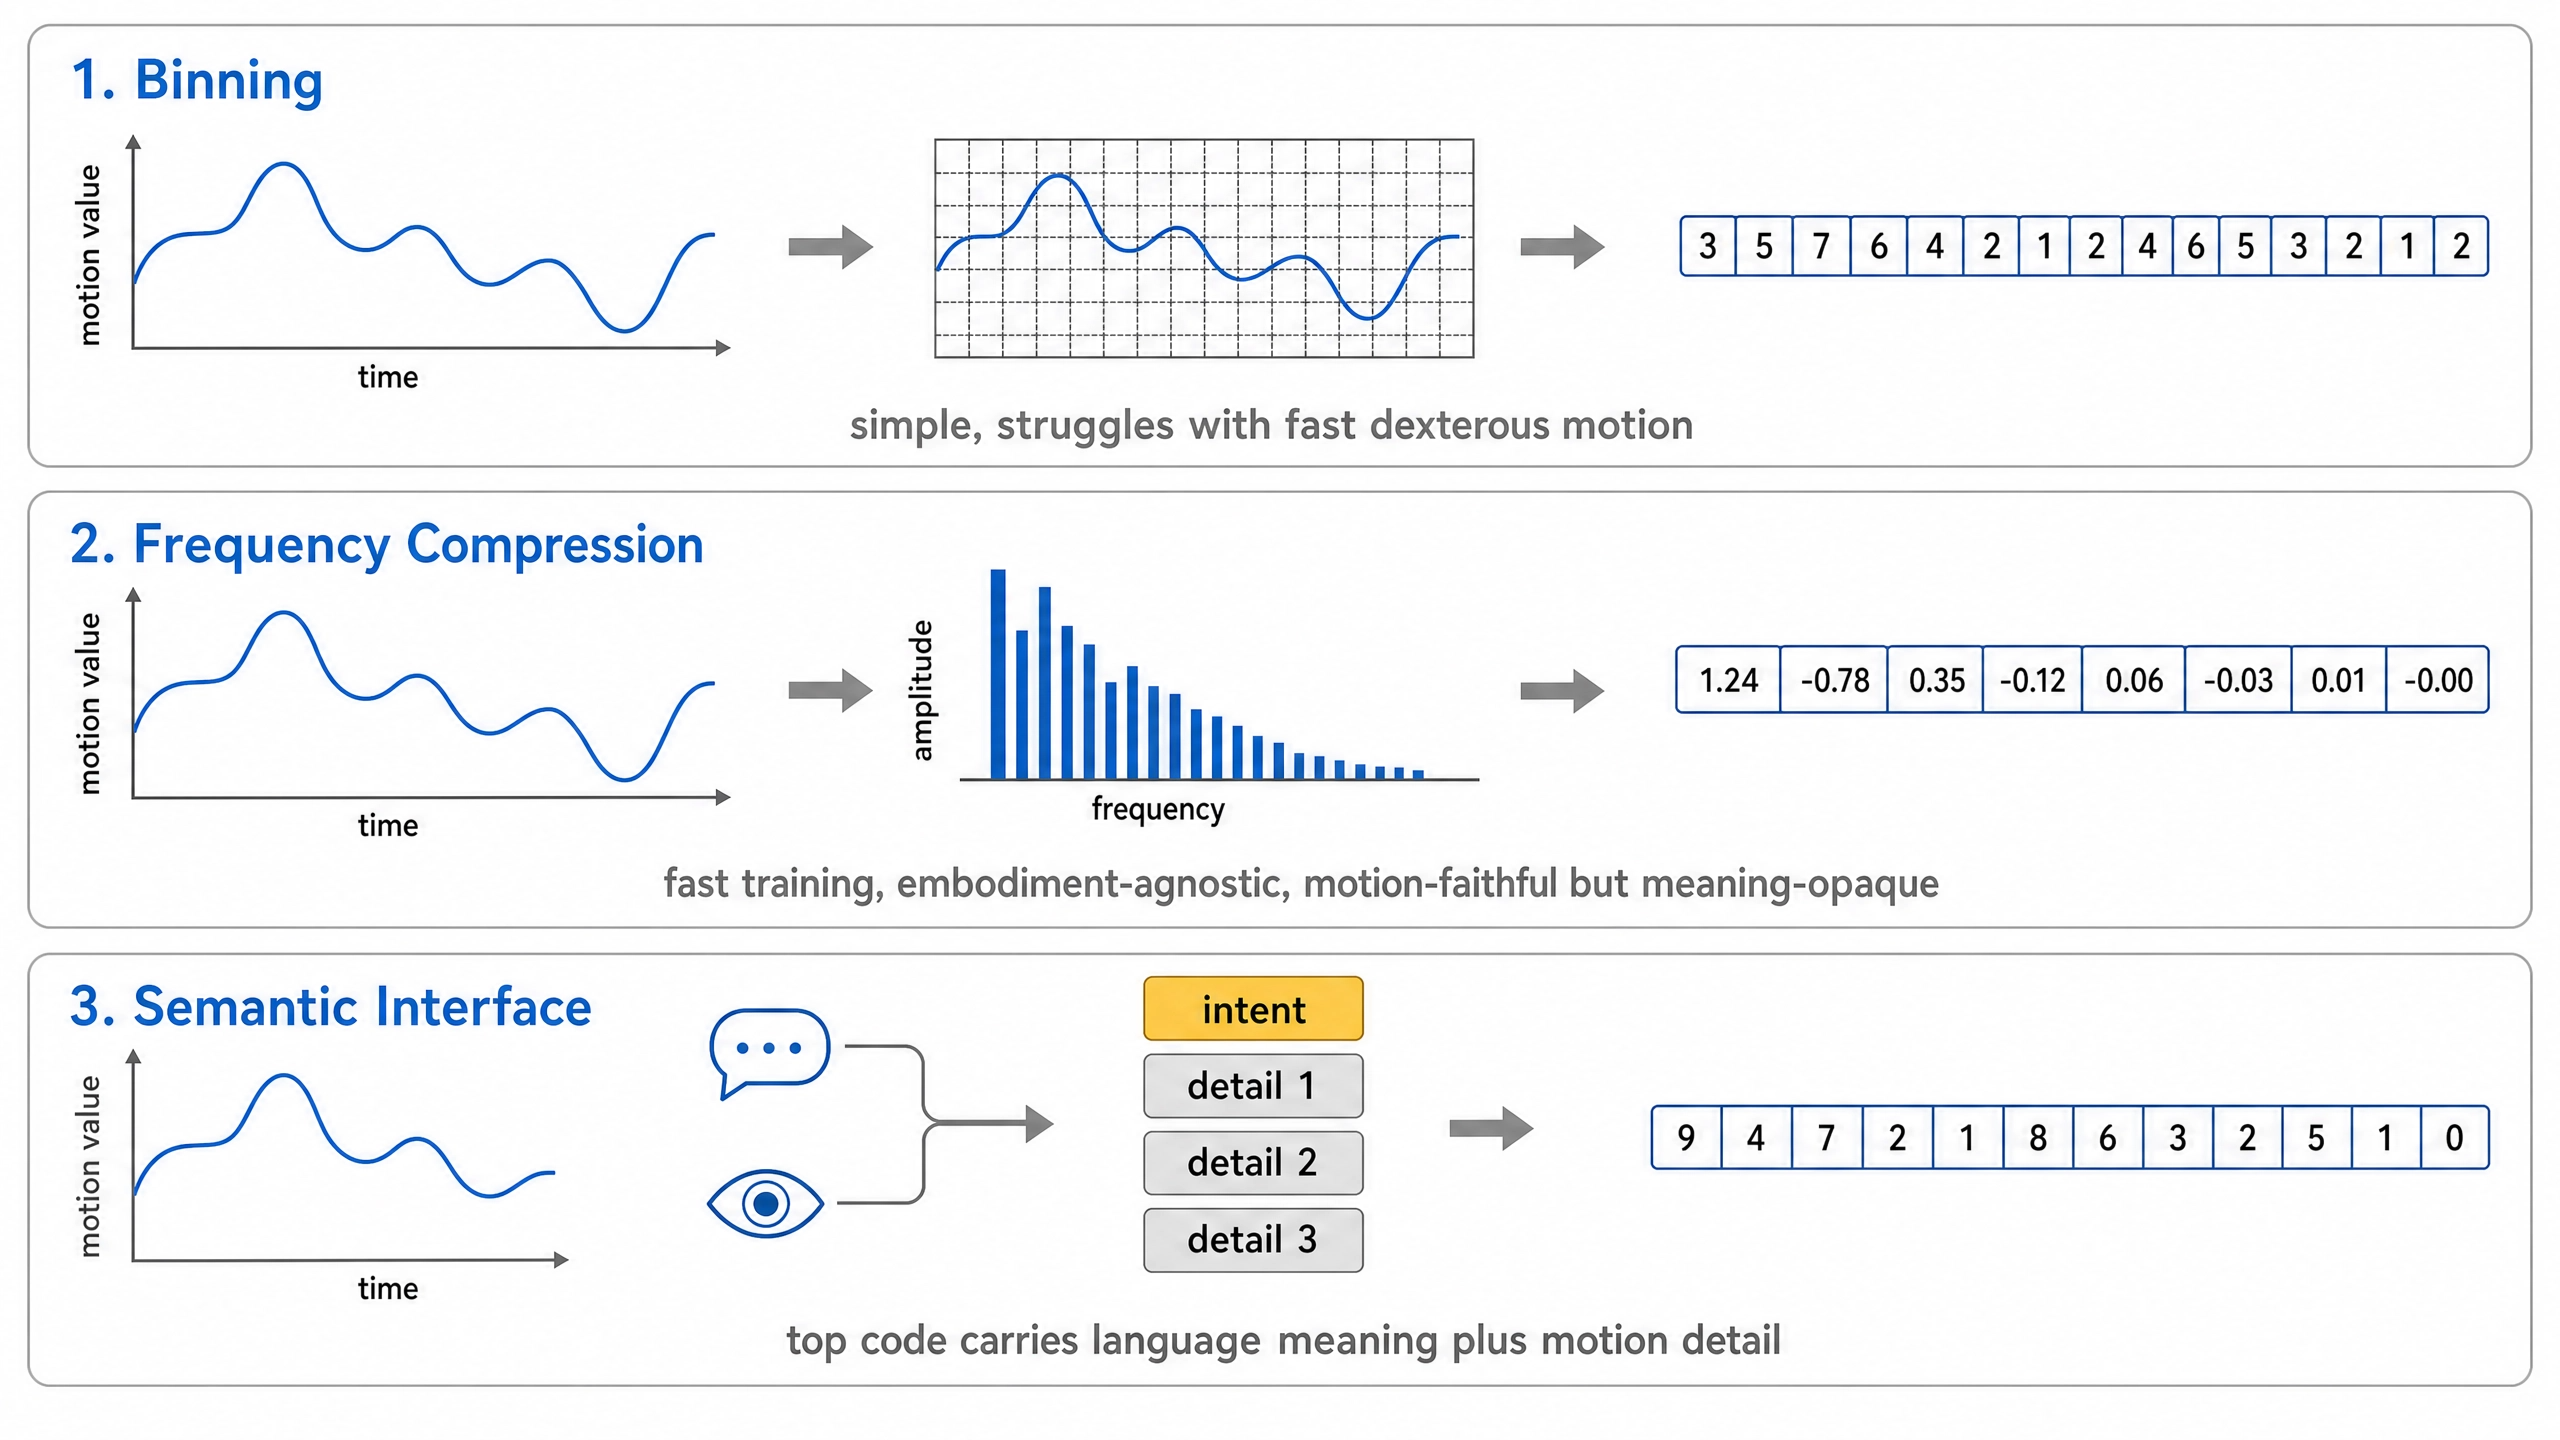
解码器会将这些符号重新转换为机器人可执行的连续指令。如果你听说过语言模型如何将文本拆分为亚词级令牌,那么这在运动控制领域就是其对应机制,这种类比绝非牵强。顶尖的机器人研究人员直接借鉴了使文本和图像令牌化器得以运行的压缩理念。这种选择之所以重要,是因为分词器并非中立的管道。它决定了哪些信息被保留,哪些被舍弃。一种能够忠实捕捉动作但打乱连续时刻之间关系的分词器,可能会导致训练速度变慢或不稳定;而压缩过于激进的分词器,则会模糊灵巧任务所需的精细控制。 而一种虽然便于模型预测、却与任务含义脱节的分词器,可能会导致机器人动作流畅,却难以理解并执行操作意图。下图展示了目前已形成的三大主要理念,本文后续部分将按顺序逐一剖析。
方法一:分桶法——这一方法证明了其可行性
首个广为人知的、证明单一模型能够读取网络信息并控制机器人的演示,来自谷歌DeepMind于2023年推出的名为“机器人变压器2”(Robotic Transformer 2,简称RT-2)的模型。该模型处理动作的方法非常直接:它将机器人动作—— 即末端执行器的位置和旋转变化以及夹爪指令,将每个维度划分为离散的区间,然后将这些区间写成一串看起来像普通文本的整数,例如序列 1 128 91 241 5 101 127 217。 随后,标准文本分词器对该字符串进行处理,这意味着机器人动作和网络数据无需重新设计模型即可通过同一模型进行处理。
这在
能力。RT-2在未见场景中的表现从前代模型的32%提升至62%,且在涌现技能的泛化能力方面,相较于早期基线模型实现了超过三倍的飞跃。这证明了网络规模的知识能够转移到物理控制领域。 回过头来看,这同时也揭示了简单分桶方法的弱点。当动作快速且灵巧时,连续的动作令牌之间会呈现高度相关性,而预测下一个令牌的模型只需通过复制前一个令牌这种简单操作就能获得较高分数。这会使模型陷入次优解,也解释了为何简单的分桶方法往往仅局限于速度较慢、较为简单的控制任务。方法二:频率压缩——实现高速处理的关键
2025年初,Physical Intelligence团队与加州大学伯克利分校及斯坦福大学的合作伙伴共同推出了一种名为“频域动作序列分词”(FAST)的方法,从根源上解决了相关性问题。 他们的洞见在于:应在训练前对动作信号进行压缩,使令牌携带独立信息而非相互重复。他们采用的技术是离散余弦变换(DCT)——这与JPEG图像文件中使用的压缩技术属于同一类,它将平滑信号表示为一小组频率分量。
这一方法在实践中成效显著。该团队发布了一个通用分词器,该分词器基于100万条真实机器人动作轨迹(涵盖单臂、双臂及移动机器人)进行训练,并证明其可作为现成的、与具体实现形式无关的组件使用。 当与他们的旗舰策略结合使用时,该基于频率分词的自回归模型可处理多达一万小时的机器人数据,其性能可媲美更复杂的基于扩散的方法,而训练速度却快达五倍。频率压缩技术几乎已成为各团队的默认选择
希望进行自回归训练,同时避免分桶带来的不稳定性。这里存在一个微妙的局限性,这也为接下来的思路奠定了基础。 频率令牌虽然能忠实反映动作,但在语义上却不透明。这些代码描述的是手臂如何移动,而非该动作相对于模型所接收指令的含义。视觉语言骨干网络在语义空间中进行推理,而动作代码则存在于信号压缩空间中,且没有任何机制能迫使二者对齐。
第三种方法——语义接口,旨在弥合这一鸿沟
这就是最新研究成果——也是本文撰写原因——的切入点。中国机器人公司X Square Robot旗下的一支团队与学术合作者共同努力,于2026年年中发布了一个名为X-Tokenizer的分词器。其核心观点在于思维框架的转变。 它不再将分词视为纯粹的压缩过程,而是将分词器视为一个语义接口——一个共享层,在该层中,动作编码会与视觉语言模型已理解的语义进行有意识的对齐。
其机制是一个具有非对称功能的四层残差量化器。顶层代码经过训练,形成与模型对场景和指令的理解相一致的粗略、离散的动作词汇表,而更深层则专注于重建精细的动作细节。 实际上,第一个符号被赋予特定含义(例如动作的总体意图),而后续符号则填补精确的执行细节。编码器被引导将每个动作片段与骨干网络对同一时刻的视图进行匹配——该视图综合了多机位视角和任务语言信息,从而使动作编码与感知特征能够“同频共振”。
报告中的结果是与频率压缩基线进行对比,而非与分桶法进行对比,这对2026方法而言是恰当的比较方式。
该方法在240万条运动轨迹和17个机器人手臂系列上进行了训练,随后将分词器固定并重复使用(无需针对每个任务进行调优),与频率基线相比,在多模态锚定方面提升了13.5%,在长时限执行方面提高了8.25分。 在高难度双臂基准测试中,当难度增加时,其性能退化程度小于领先的对比策略;且通过在不同机器人机体上联合训练一个模型,不仅未导致最难任务的得分被稀释,反而提升了这些任务的得分。这些结果目前仍仅限于模拟和桌面实验室环境,因此它们指明了一个有前景的方向,而非已确定的实际应用优势,这一点值得留意。并列比较
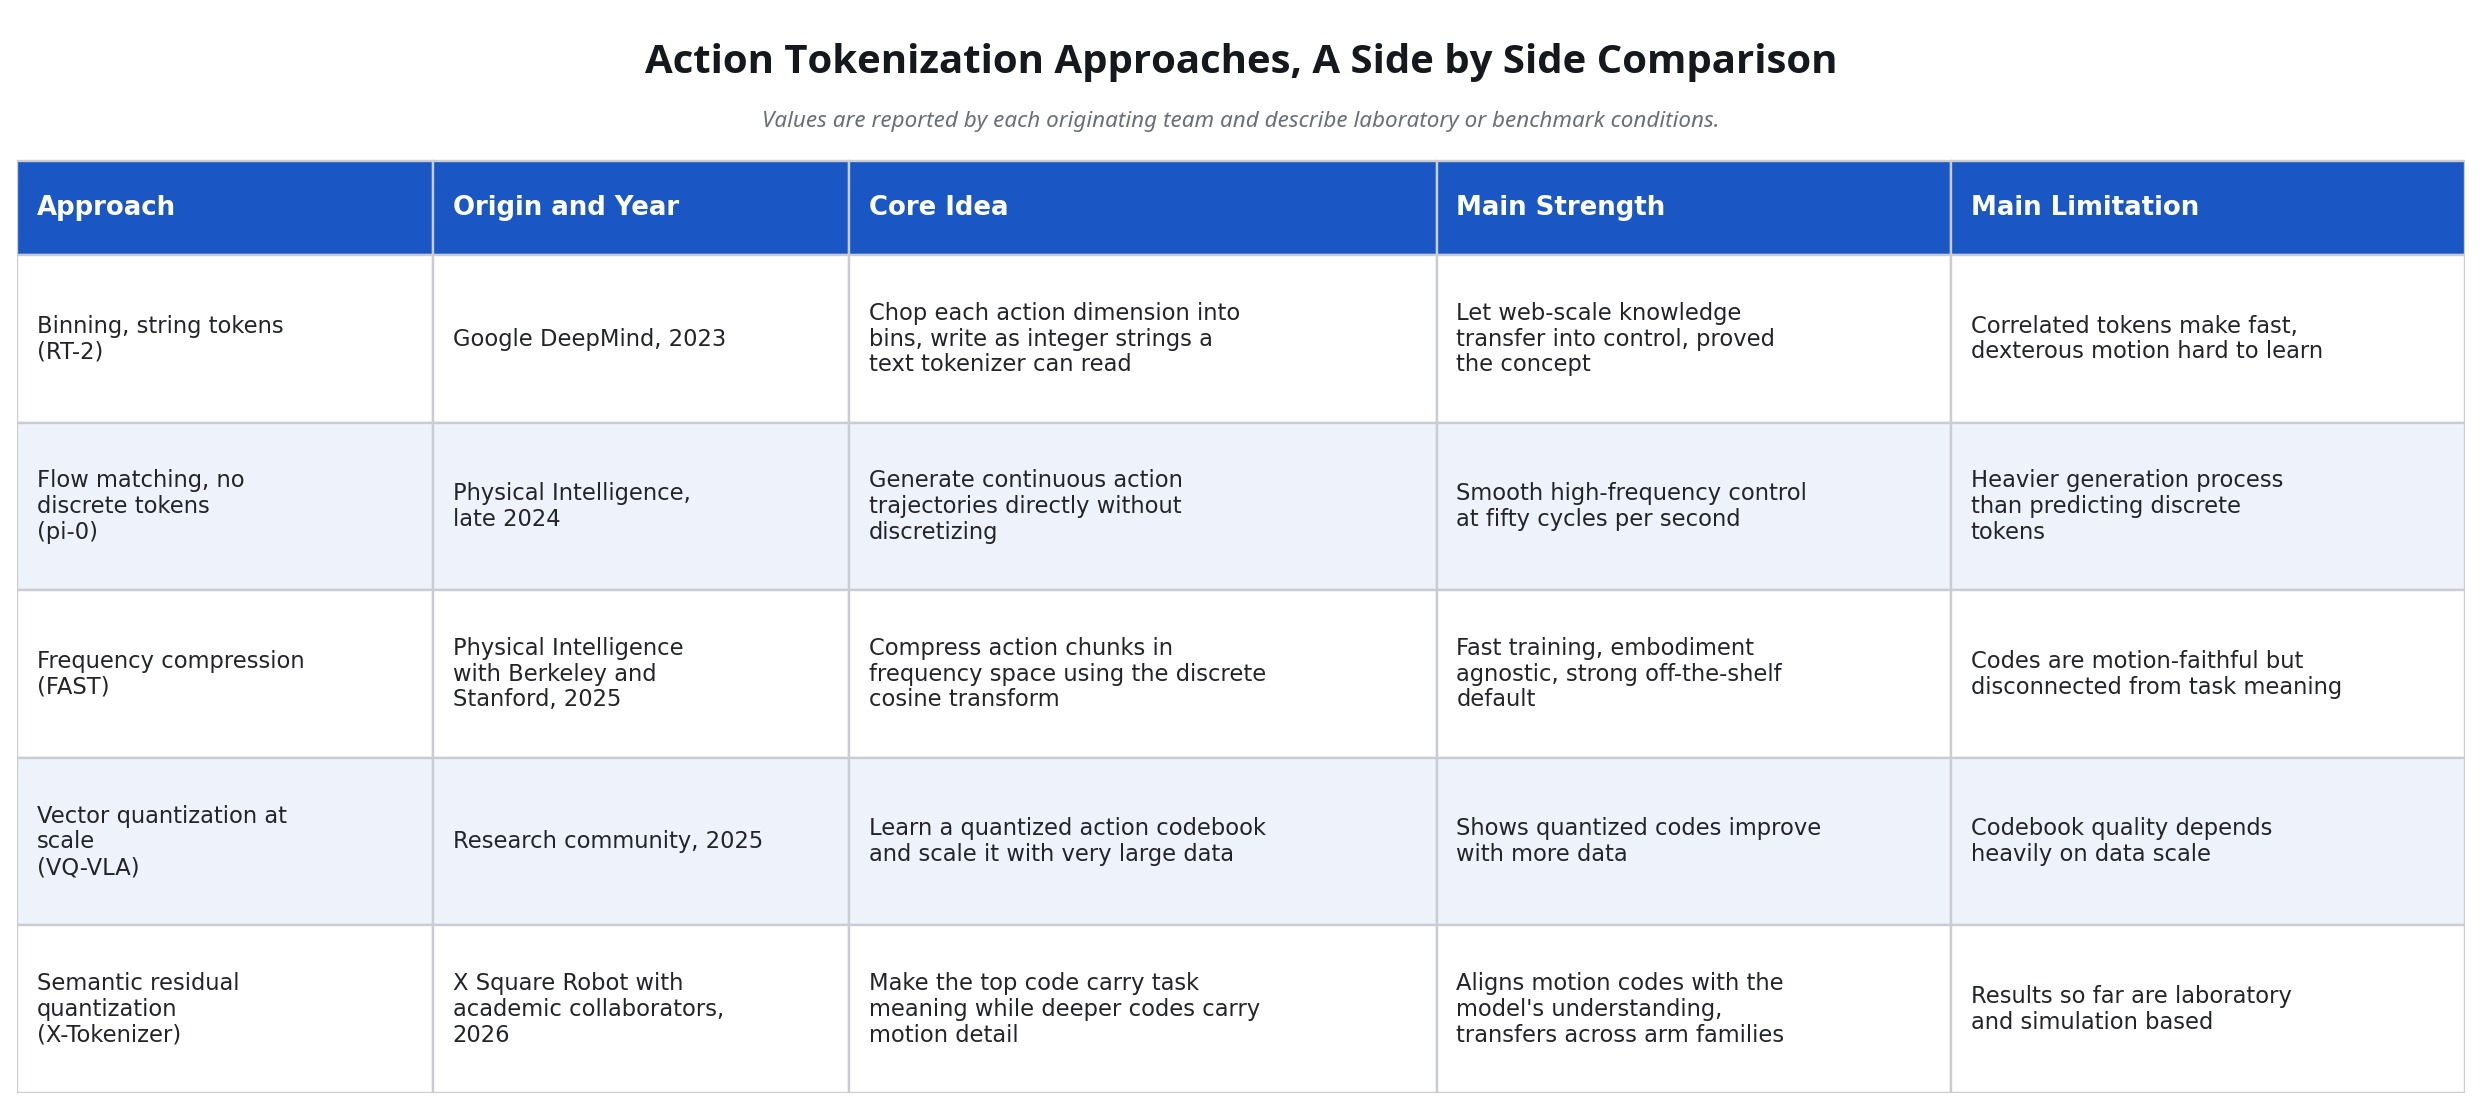
下表总结了领先的方法及其各自代表的设计权衡。所列数值均基于各研究团队报告的结果。
前沿争论的一句话概括
抛开工程细节不谈,该领域的争论其实集中在一个核心问题上。 动作分词器应该是一个保持简单、快速且对语义无所谓的“中立压缩器”(即频率压缩观点),还是应该是一个将动作与语言绑定、使机器人的理解与其动作共享同一词汇表的“主动参与者”(即语义接口观点)? 第三种观点则完全避开了这一问题,通过流匹配直接生成连续运动,完全不使用离散令牌。目前尚无定论,最可能的结果是不同的部署需求将倾向于不同的解决方案。
面向采购方的自动化、机器人技术与物理智能阅读指南
对于运营商或采购团队而言,这看起来像是一场学术争论,直到将其与成本和
风险确实存在,而且这种关联是真实存在的。部署机器人时成本最高的环节很少是机械臂本身,而是数据采集、针对每项任务的调优,以及当一个现场运行多种机器时所需的集成工作。 动作分词技术恰恰位于这些成本中心之上,因为它决定了经过训练的策略能多轻松地从基准环境迁移到实际工作环境,以及从一个机器人机身迁移到另一个机器人机身。采购方应从中汲取三个实用要点。首先,令牌化器是迁移的杠杆。一种与具体机体无关的令牌化器,或者一种无需重新训练即可在多种机械臂系列间迁移的令牌化器,能直接降低混合机队集成成本,因为团队无需为每台机器重新构建运动控制层。 其次,训练速度是预算的关键指标。将训练时间缩短数倍的频率压缩成果绝非小事,它意味着部署迭代周期从数周缩短至数天。第三,也是最重要的一点,实验室宣称的性能提升并不等同于实际现场表现。 本文讨论的每种方法所报告的最佳数据均来自基准测试和桌面任务,因此,采购方在评估供应商时,应要求其提供在拟采购的特定机器人上、在与实际工作场景相似的任务条件下、在现实的干扰和循环时间环境下的测试结果,而非仅接受那些引人注目的基准测试数据。
未来两年更深层次的信号是,在物理智能领域,行动层——而不仅仅是其背后的语言模型规模——正逐渐成为竞争的战场。 那些能够将动作与语义结合、并能让单一训练好的策略在不同机器间无缝移植的团队,将在部署经济性方面占据真正优势。这正是采购团队应重点关注的指标,因为唯有它能将实验室成果转化为运营预算中的实际支出。
来源
证据说明本文所参考的主要权威来源:
• Google DeepMind,RT-2 公告及方法说明,2023年7月28日,以及相关论文《RT-2:视觉语言动作模型将网络知识迁移至机器人控制》(RT-2, Vision Language Action Models Transfer Web Knowledge to Robotic Control),arXiv 2307.15818。
• Pertsch 及其同事,FAST:《视觉语言动作模型的高效动作分词》,与加州大学伯克利分校及斯坦福大学合作的“物理智能”项目,arXiv 2501.09747,2025年1月。
• Physical Intelligence pi-0 和 pi-0-FAST 技术说明,包括流程匹配动作生成,详见 Hugging Face LeRobot 模型发布文档,2025年2月。
• VQ-VLA,《通过可扩展向量量化动作分词器改进视觉语言动作模型》,arXiv 2507.01016,2025年。
• X-Tokenizer,由 X Square Robot 与学术合作者共同开发的跨模态具身动作分词器,arXiv 2606.14752,2026 年 6 月提交,附有相关项目页面、代码仓库和模型卡片。 技术主张(包括相较于频率压缩基线所报告的13.5%多模态锚定提升和8.25点的长时域提升)均已根据原始数据进行了验证。
本文中所有对比数据均按原始团队公布的数据呈现,除非另有说明,否则均描述实验室或基准测试条件下的结果。












