
ロボットはどのように動きを学習するのか、そしてなぜ「動作のトークン化」が身体知能における目立たないボトルネックとなっているのか
Vision Language Actionモデルは、シーンを読み取り、指示に従うことはできますが、その理解を滑らかで連続的な動きに変換する必要があります。言語と運動制御を結びつけるこの手法は「アクション・トークナイゼーション」と呼ばれ、ロボットの学習において、ひっそりと最も重要な設計上の選択の一つとなっています。
あらゆるスマートロボットに潜む問題
平易な言葉で「シャツを畳む」や「作業台の上の部品を仕分ける」といった指示を受けられる現代のロボットは、「ビジョン・言語・アクション(VLA)」モデルと呼ばれる種類のモデルに基づいて動作しています。この名称は、その役割を如実に表しています。このモデルは、ビジョン、つまりシーンのカメラ画像を取り込みます。 さらに、言語、つまり指示や文脈情報を取り込みます。そして、アクション、つまり関節やグリッパーを動かす実際のモーターコマンドのストリームを生成しなければなりません。
このパイプラインの最初の2つの部分は、すでに実用化されている人工知能から大きく借用している。VLAモデルは、画像理解やチャットを支えるのと同じモデルファミリーである「ビジョン・言語バックボーン」を再利用しており、これらのバックボーンは膨大な量のインターネット上のテキストや画像を用いて学習されている。3番目の部分こそが、ロボティクスが真に困難になる点である。 言語は本質的に離散的であり、トークンと呼ばれる有限の語彙から構成されています。トランスフォーマーは、それまでのトークンから次のトークンを予測します。しかし、ロボットの動きはそうではありません。それは連続的で、高頻度であり、物理的なものです。関節角度、エンドエフェクタの位置、グリッパーへの指令は、滑らかな実数値の信号として流れ、多くの場合、1秒間に数十回も更新されます。
したがって、高性能なロボットの根底にはある疑問が潜んでいますが、研究コミュニティ以外の人々のほとんどは、その疑問が提起されることさえ耳にしません。連続的な動きを、どのようにしてトークン予測モデルが学習・生成できる形に変換するのか。 その答えとなるのが「アクション・トークナイゼーション」と呼ばれるプロセスであり、チームがこの課題にどう取り組むかによって、ロボットの学習速度、達成可能な器用さ、そして単一のモデルが異なる機械間でどれだけうまく転移できるかが決まります。
アクション・トークナイゼーションが実際に行うこと
トークン化とは、連続した動作のチャンク(将来の動作の短いウィンドウ)を、モデルが次々と予測できる離散的な記号のシーケンスに変換する行為です。モデルがそれらを予測した後、
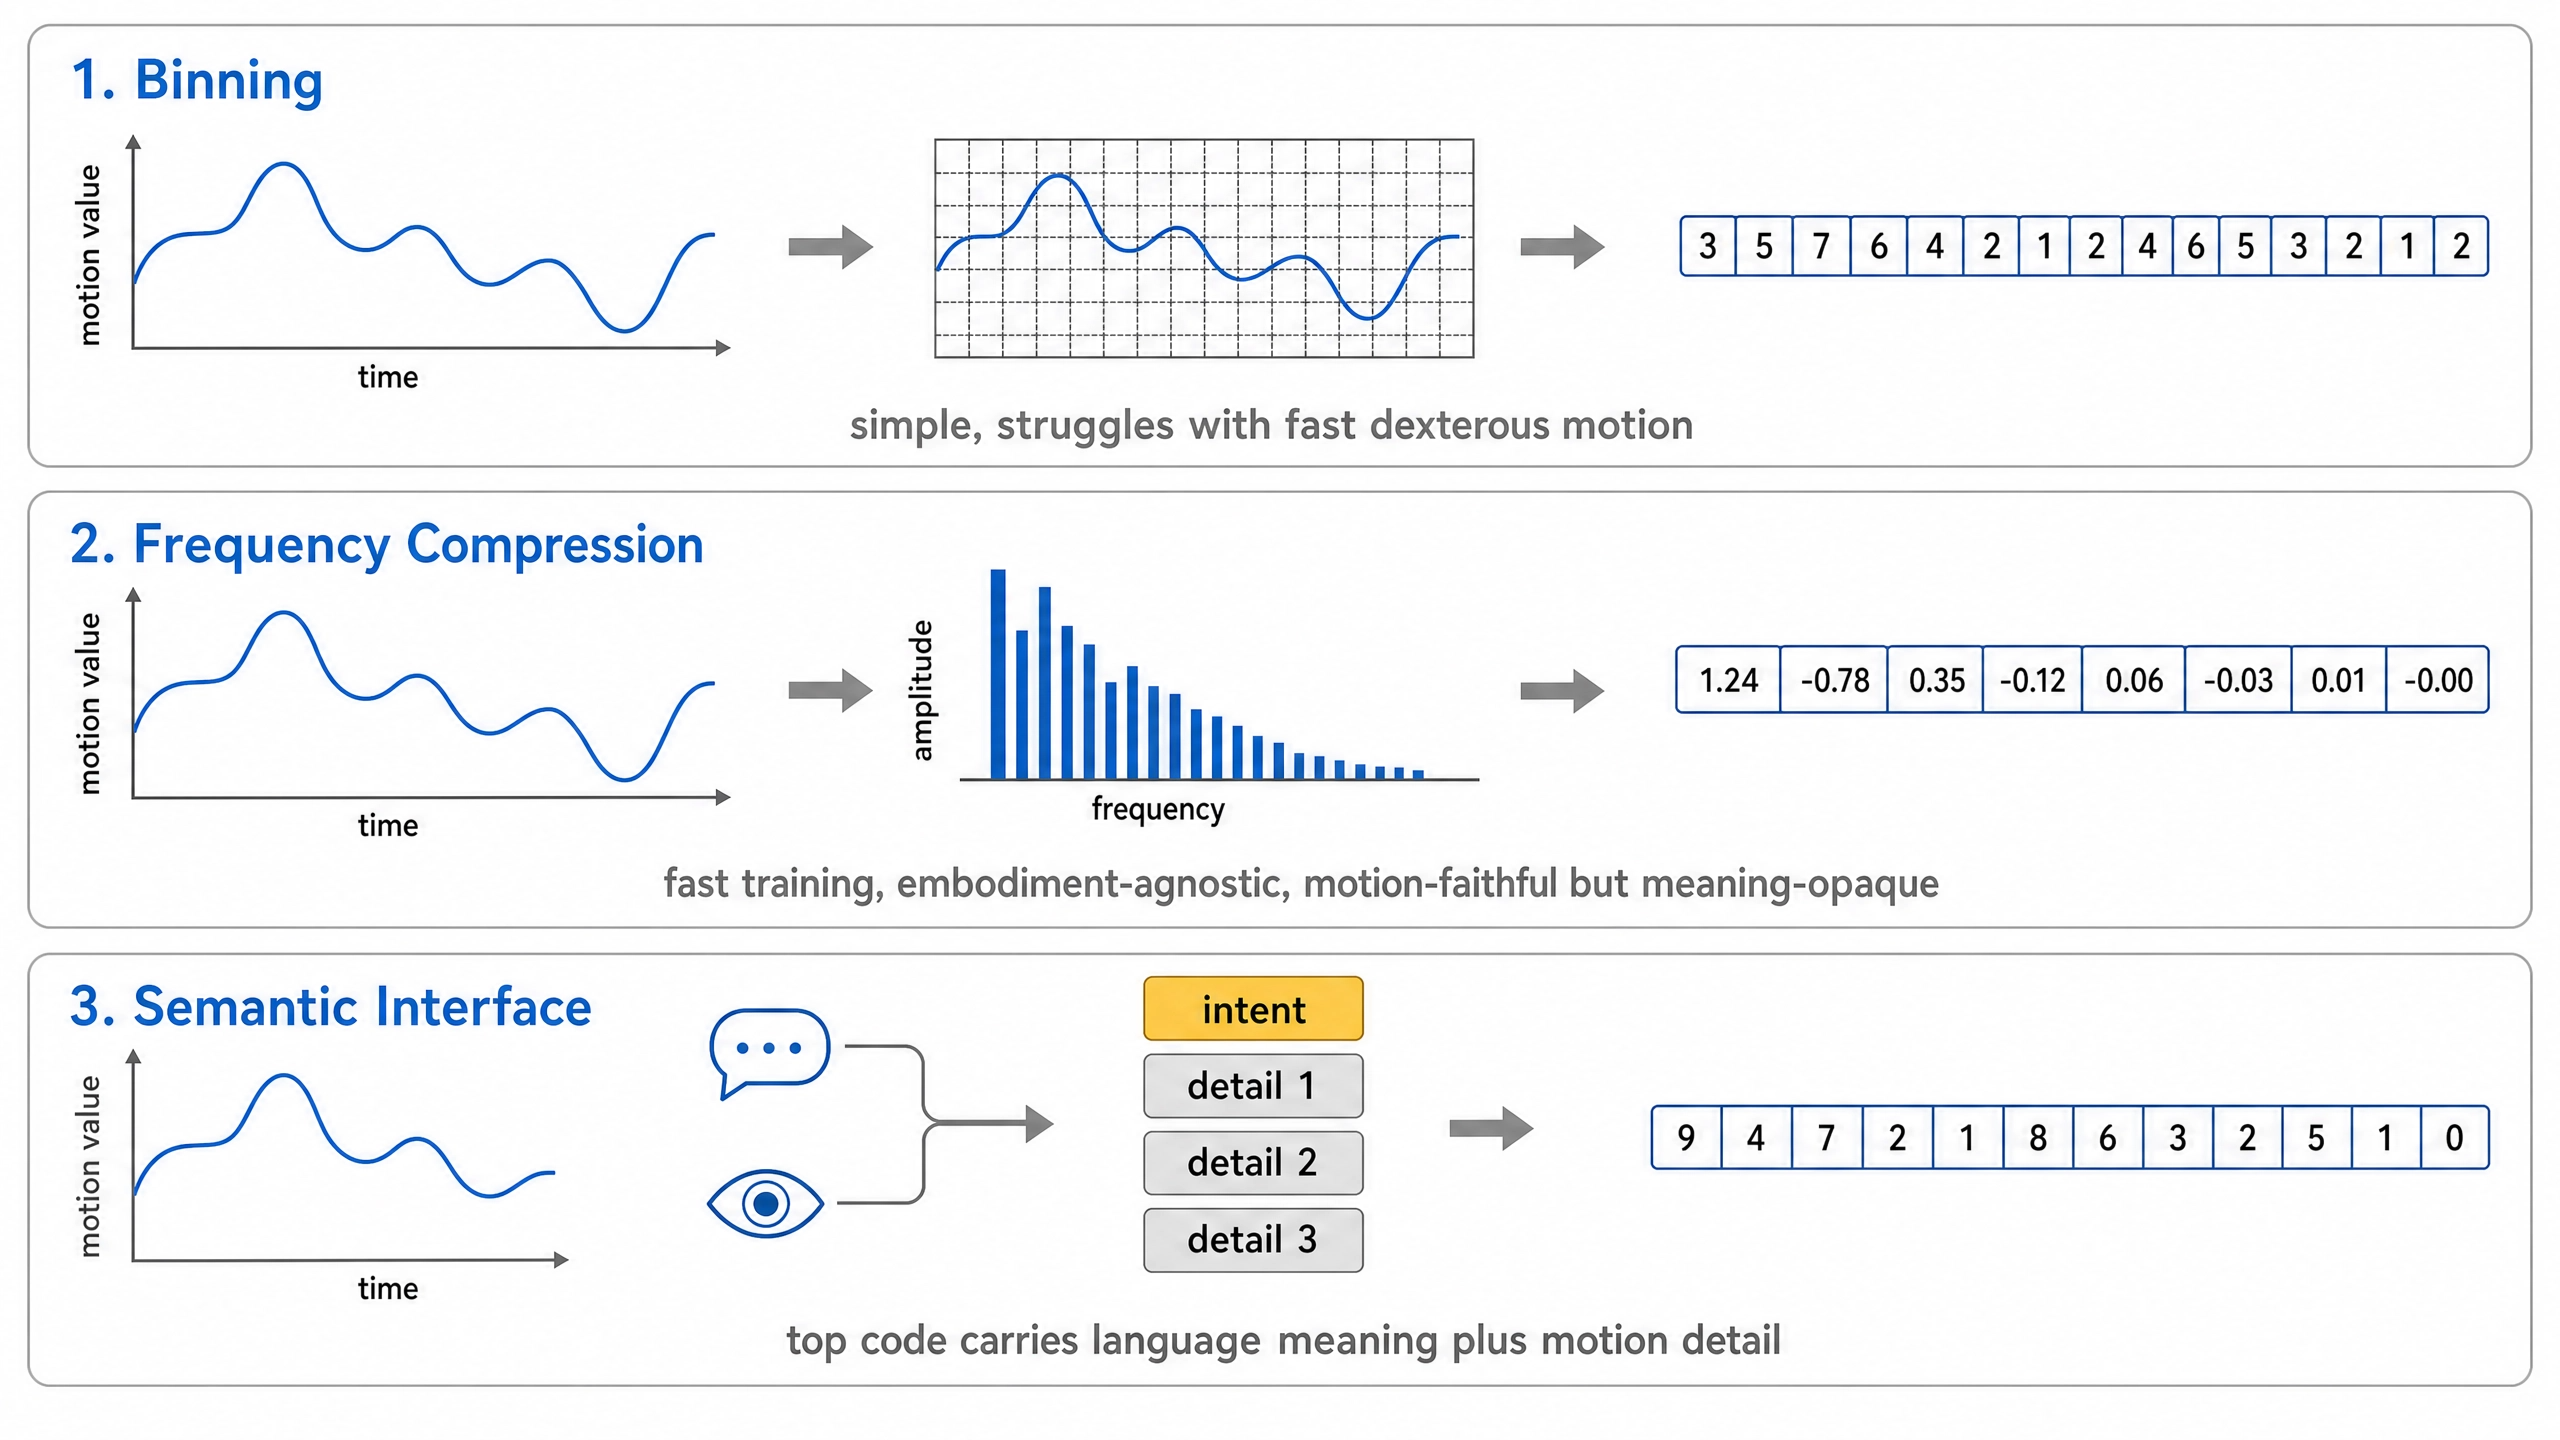
シンボルを、デコーダがロボットが実行可能な連続したコマンドへと再び変換します。言語モデルがテキストをサブワードのトークンに分割する方法について聞いたことがあるかもしれませんが、これは運動制御におけるそれと同等の仕組みであり、この比較は決して大げさなものではありません。ロボット工学の第一人者たちは、テキストや画像のトークナイザーを機能させた圧縮のアイデアを直接取り入れています。この選択が重要な理由は、トークナイザーが単なる中立的なパイプではないからです。トークナイザーは、どの情報を残し、どの情報を切り捨てるかを決定します。動きを忠実に捉えるものの、連続する瞬間の間の関係を乱してしまうトークナイザーは、学習を遅くしたり不安定にしたりする可能性があります。逆に、過度に強力に圧縮するトークナイザーは、巧みな作業に必要な微細な制御を曖昧にしてしまう恐れがあります。 また、モデルが予測しやすいものの、タスクの意味から切り離されたトークナイザーは、ロボットに滑らかな動きをもたらす一方で、意図に従う能力を損なう可能性がある。下の図は、これまでに浮上してきた3つの大きな哲学を示しており、本記事の残りの部分ではこれらを順に解説していく。
アプローチ1:ビニング――実現可能性を証明した手法
単一のモデルがウェブを読み取り、ロボットを制御できることを示した最初の広く知られる実証例は、2023年にGoogle DeepMindが「Robotic Transformer 2(RT-2)」と呼ばれるモデルを用いて行ったものである。その動作処理の手法は直接的なものであった。ロボットの動作、 エンドエフェクタの位置と回転の変化、およびグリッパーのコマンドを受け取り、各次元を離散的なビンに分割し、それらを通常のテキストのように見える整数の文字列として出力しました。例えば、「1 128 91 241 5 101 127 217」のようなシーケンスです。 その後、標準的なテキストトークナイザーがその文字列を処理したため、モデルを再設計することなく、ロボットの動作とウェブデータを同じモデルを通じて処理することが可能になった。
これは、
能力。RT-2は、これまでに見たことのないシナリオにおける性能を、前世代モデルの32%から62%へと向上させ、また、新たなスキルの汎化能力においても、以前のベースラインと比較して3倍以上の飛躍的な向上を示した。これにより、ウェブ規模の知識が物理的な制御へと転移し得ることが実証された。 また、後知恵ではあるが、単純なビニングの弱点も明らかになった。動きが速く器用な場合、連続する動作トークン間の相関が高くなり、次のトークンを予測するモデルは、前のトークンをコピーするといった単純な処理を行うだけで高いスコアを得てしまう。これによりモデルは劣った解に閉じ込められ、単純なビニングが、より遅く単純な制御に限定されがちな理由が説明される。アプローチ2:周波数圧縮――高速化を実現した手法
Physical Intelligenceのチームは、カリフォルニア大学バークレー校およびスタンフォード大学の共同研究者らと協力し、2025年初頭、Frequency-space Action Sequence Tokenization(FAST)と呼ばれる手法を用いて、相関問題の根本的な解決に取り組みました。 彼らの洞察は、アクション信号を学習前に圧縮すべきであり、そうすることでトークンが互いに繰り返すのではなく、独立した情報を担うようになるというものでした。彼らが採用した技術は離散コサイン変換(DCT)であり、これはJPEG画像ファイルでも使用されているのと同じ圧縮手法の一種で、滑らかな信号を少数の周波数成分として表現します。
実用面での成果は顕著だった。チームは、単腕ロボット、双腕ロボット、移動ロボットにまたがる100万件の実ロボット動作軌跡で学習された汎用トークナイザーを公開し、これが「そのまま使える」、実装形態に依存しないコンポーネントとして活用できることを示した。 彼らの主力ポリシーと組み合わせた場合、周波数トークン化された自己回帰モデルは1万時間分のロボットデータに対応し、よりリソースを消費する拡散ベースのアプローチと同等の性能を発揮しつつ、トレーニング速度は最大5倍高速でした。周波数圧縮は、各チームにとってほぼデフォルトの選択肢となりました。
ビニングによる不安定さを伴わずに、自己回帰学習を行いたい場合。ここには微妙な制限があり、それが次のアイデアへとつながる。 周波数トークンは動作を忠実に反映していますが、意味的には不透明です。コードは腕がどのように動くかを記述するものであり、モデルに与えられた指示との関係でその動きが何を意味するかは記述していません。ビジョン言語バックボーンは意味の空間で推論を行うのに対し、動作コードは信号圧縮の空間に存在しており、この2つを一致させる強制力は何もないのです。
アプローチ3:セマンティック・インターフェース――このギャップを埋める試み
ここで、最新の取り組み、そして本解説記事の理由となるものが登場します。中国のロボット企業X Square Robotに関連するチームが、学術機関の協力者らと共に、2026年半ばに「X-Tokenizer」と呼ばれるトークナイザーを発表しました。その主張は、枠組みの転換にあります。 トークナイゼーションを単なる圧縮として扱うのではなく、トークナイザーを「意味的インターフェース」——つまり、動作コードが、ビジョン言語モデルがすでに理解している意味と意図的に整合される共有層——として扱うのである。
その仕組みは、非対称な役割を持つ4段階の残差量子化器である。最上位レベルのコードは、モデルがシーンや指示をどのように理解しているかに沿った、粗く離散的な動作語彙を形成するように学習される一方、より深いレベルは、細かい動作の詳細を再構築することに焦点を当て続ける。 事実上、最初のシンボルには、動作の大まかな意図といった意味が割り当てられ、後続のシンボルが正確な実行内容を補完します。エンコーダは、各アクションチャンクを、複数のカメラアングルとタスク言語から導き出されたバックボーンのその瞬間の視点と一致させるよう調整されるため、アクションコードと知覚特徴は共通の言語で通信することになります。
報告された結果は、ビンニングではなく周波数圧縮のベースラインと比較して測定されており、これは2026法にとって適切な比較基準である。
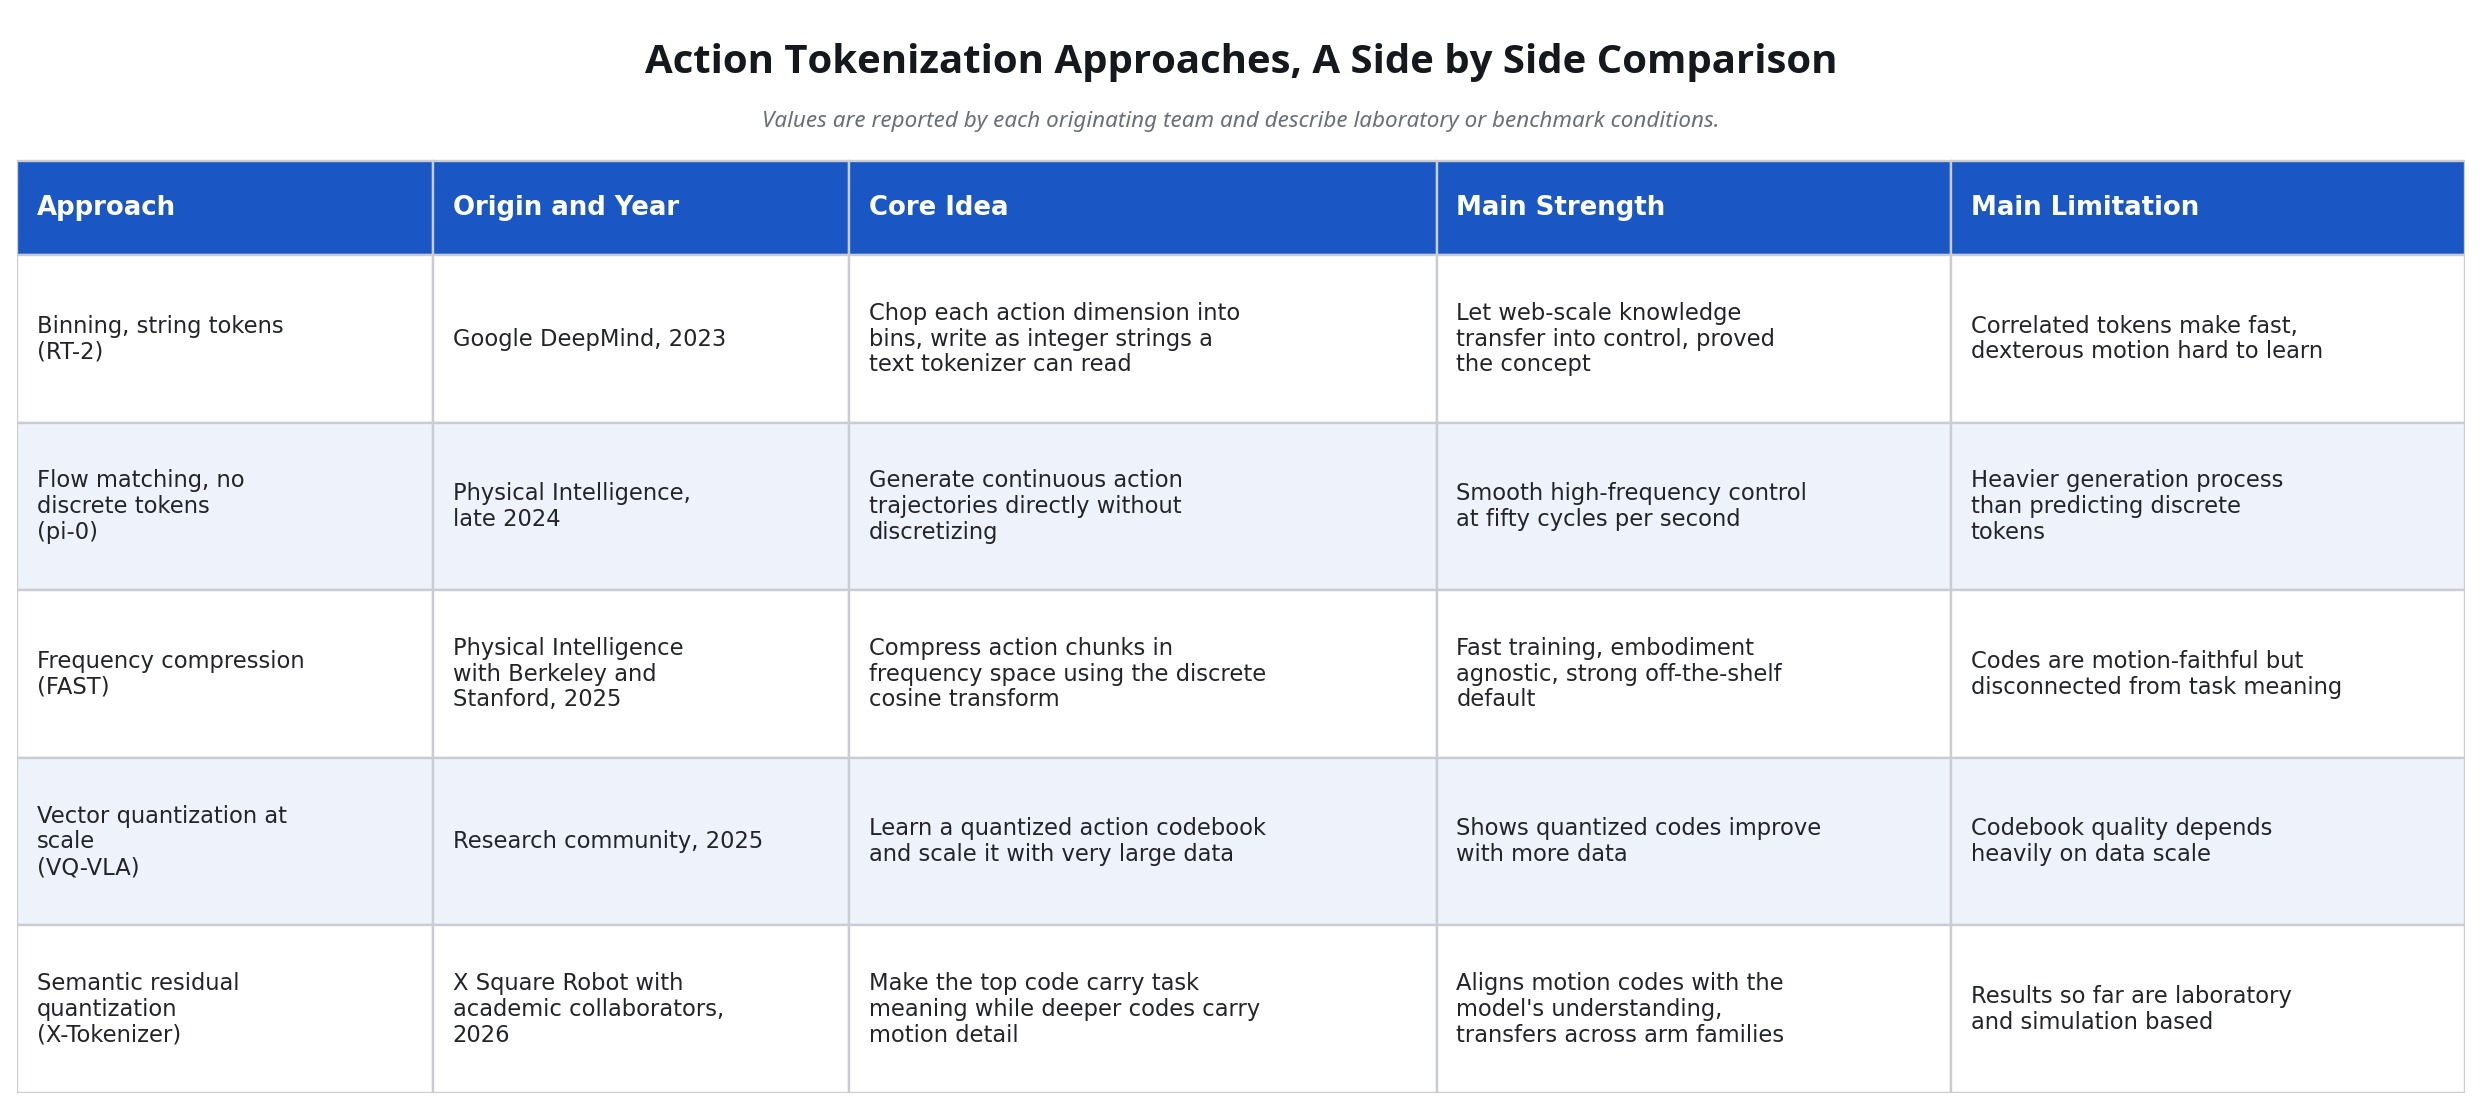
240万本の軌跡と17種類のロボットアームファミリーを用いて学習を行い、その後トークナイザーを固定してタスクごとの微調整なしに再利用したところ、このアプローチは、周波数ベースラインと比較して、マルチモーダル・グラウンディングにおいて13.5%の改善、長期実行において8.25ポイントの向上を達成したと報告されている。 難易度の高いデュアルアームベンチマークにおいて、難易度が上昇してもその性能の低下は、主要な比較対象ポリシーよりも小さかった。また、異なるロボットボディ間で1つのモデルを共同で学習させた結果、スコアが希薄化するどころか、最も難易度の高いスコアが向上した。これらはあくまでシミュレーションおよび卓上実験室での結果であるため、確立された実用上の利点というよりは、有望な方向性を示しているに過ぎない。この区別を念頭に置いておく価値がある。並列比較
以下の表は、主要なアプローチと、それぞれが表す設計上のトレードオフをまとめたものです。数値は、各手法の開発チームが報告した内容に基づいています。
最先端の議論を一言で言えば
技術的な詳細を省けば、この分野での議論は一つの問いに集約される。 動作トークナイザーは、シンプルで高速であり、意味に無関心な中立的な圧縮器であるべきか(これが「頻度圧縮」の視点である)、あるいは、動作と言語を結びつけ、ロボットの理解とその動きが共通の語彙を共有するようにする能動的な参加者であるべきか(これが「意味的インターフェース」の視点である)。 第三の陣営は、フローマッチングを用いて連続的な動作を直接生成し、離散的なトークンを一切使用しないことで、この問いを完全に回避している。決定的な勝者は存在せず、最も可能性の高い結果は、導入時のニーズの違いによって異なる答えが選ばれるということだろう。
購買担当者向けの自動化、ロボティクス、物理知能に関する解説
運用担当者や調達チームにとって、これをコストや
リスクは確かに存在し、その関連性は現実のものだ。ロボットを導入する際にコストがかかる部分は、アームそのものであることはめったにない。むしろ、データ収集、タスクごとの微調整、そして1つの現場で複数の種類の機械が稼働している場合の統合作業にコストがかかるのだ。 アクションのトークナイゼーションは、まさにこれらのコスト要因の核心に位置する。なぜなら、トレーニング済みのポリシーが、ベンチマークから実稼働環境へ、またあるロボット本体から別のロボット本体へと、どれほど容易に移行できるかを左右するからだ。購入者は、ここから3つの実用的なポイントを引き出すべきです。第一に、トークナイザーは転移のレバーです。実装形態に依存しないトークナイザー、あるいは再トレーニングなしで多くのアームファミリー間で転移可能なトークナイザーは、混合フリートの統合コストを直接的に低減します。なぜなら、チームが機械ごとにモーション層を再構築する必要がなくなるからです。 第二に、トレーニング速度は予算の鍵となる要素です。トレーニング時間を数倍に短縮した周波数圧縮の結果は、些細な点ではなく、デプロイメントの反復を「数週間」ではなく「数日」で完了できるかどうかの分かれ目となります。第三に、そして最も重要な点として、実験室で報告された性能向上は、現場での実稼働時の性能とは一致しないということです。 ここで論じたあらゆるアプローチは、ベンチマークや机上のタスクにおける最良の数値を報告しているに過ぎない。したがって、ベンダーを評価する購入者が取るべき正しい姿勢は、見出しとなるベンチマーク数値を鵜呑みにするのではなく、購入予定の特定のロボットを用いて、実際の作業に類似したタスクにおいて、現実的な外乱やサイクルタイムの下で得られた結果を要求することである。
今後2年間におけるより深い示唆は、物理知能の分野において、その背後にある言語モデルの規模だけでなく、「アクション層」こそが競争の激戦場になりつつあるということです。 動作と意味を結びつけ、単一の学習済みポリシーを異なるマシン間でシームレスに移植できるチームこそが、導入コストの面で真の優位性を握ることになる。調達チームが追跡すべき指標はこれである。なぜなら、これこそが実験室での成果を運営予算上の項目へと変換する指標だからだ。
出典
参考資料本解説記事で参照した主要かつ信頼性の高い情報源:
• Google DeepMind、「RT-2」の発表および手法の説明(2023年7月28日)、および関連論文「RT-2: Vision Language Action Models Transfer Web Knowledge to Robotic Control」(arXiv 2307.15818)。
• Pertschら、「FAST: ビジョン・言語・アクションモデル向けの効率的なアクショントークン化」、Physical Intelligence(カリフォルニア大学バークレー校およびスタンフォード大学)、arXiv 2501.09747、2025年1月。
• フローマッチングによるアクション生成を含む、Physical Intelligenceのpi-0およびpi-0-FASTの技術的説明。Hugging FaceのLeRobotモデルリリース(2025年2月)に記載されている。
• VQ-VLA、「スケーリングベクトル量子化アクショントークナイザーによるビジョン・言語・アクションモデルの改善」、arXiv 2507.01016、2025年。
• X-Tokenizer:X Square Robotが学術機関の共同研究者らと開発した、モダリティ横断型の体現型アクション・トークナイザー。arXiv 2606.14752、2026年6月投稿。関連するプロジェクトページ、コードリポジトリ、モデルカードあり。 報告された「周波数圧縮ベースラインと比較して13.5%のマルチモーダル・グラウンディング向上」および「8.25ポイントのロングホライズン向上」を含む技術的主張は、主要な成果物に対して検証された。
本記事におけるすべての比較図は、出典チームが公表したものをそのまま掲載しており、特に断りがない限り、実験室またはベンチマークの条件に基づいて記述されている。












