
中國剛為機器人配備了一套運算緩慢的「大腦」,隨後便免費將其公開
上海創新研究院與 AgiBot 共同發布了 τ0-VLA,這是一款長時域視覺-語言-動作模型,聲稱其表現優於 Google 和 Physical Intelligence 的基準模型,達到當前最先進水準,據稱是基於 40,115 小時的真實機器人數據集進行訓練,並隨模型一併公開了權重與訓練配方。 該模型被定位為具身人工智慧(embodied AI)領域潛在的「DeepSeek 時刻」;採用指標(分叉數、下載量)被視為值得關注的驗證標準。
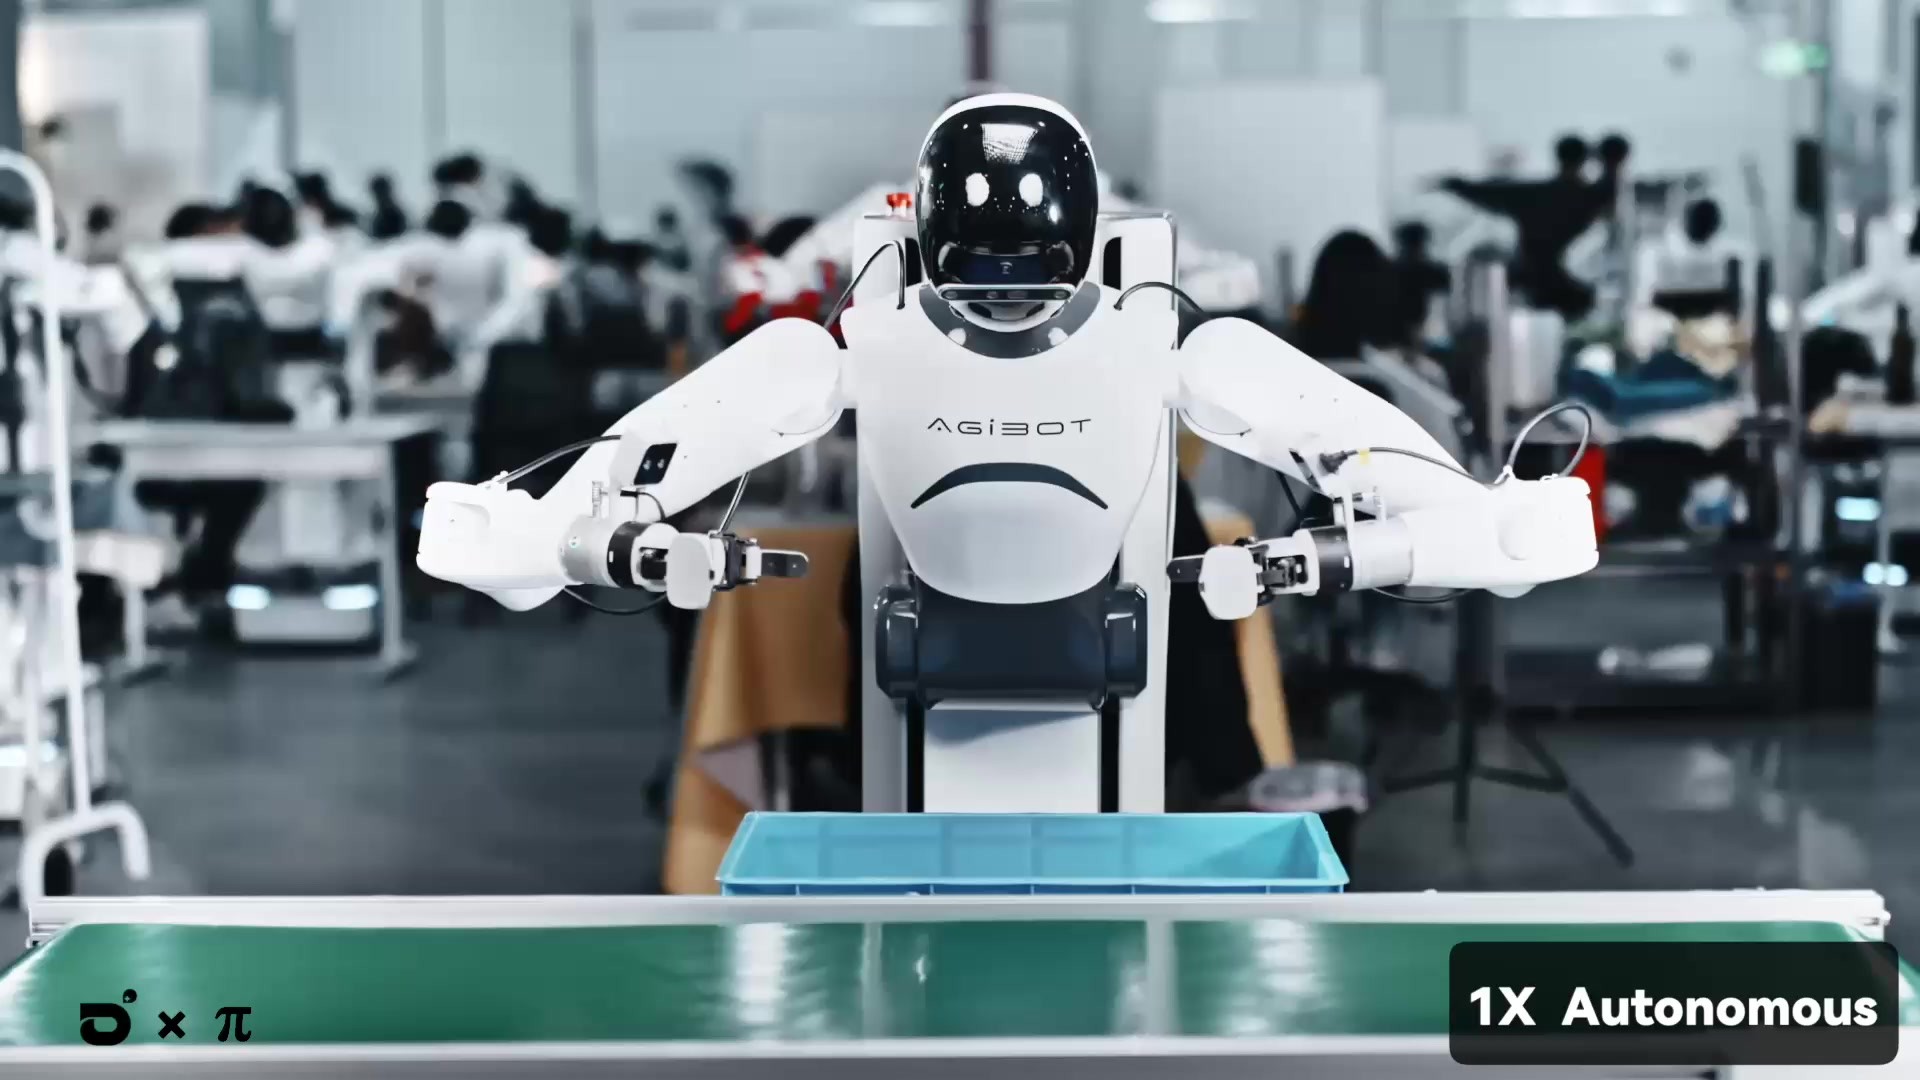
那場改變聊天機器人的推理革命,如今已延伸至機器人軀體,而中國正免費推廣這項技術。 上海創新研究院與 AgiBot 的「具身研究中心」於 7 月 27 日發布了 τ0-VLA——這是一款在任務遇到難關時會暫停思考的機器人基礎模型,並將相關論文、程式碼及權重以開源形式發布於 GitHub 和 Hugging Face 上。
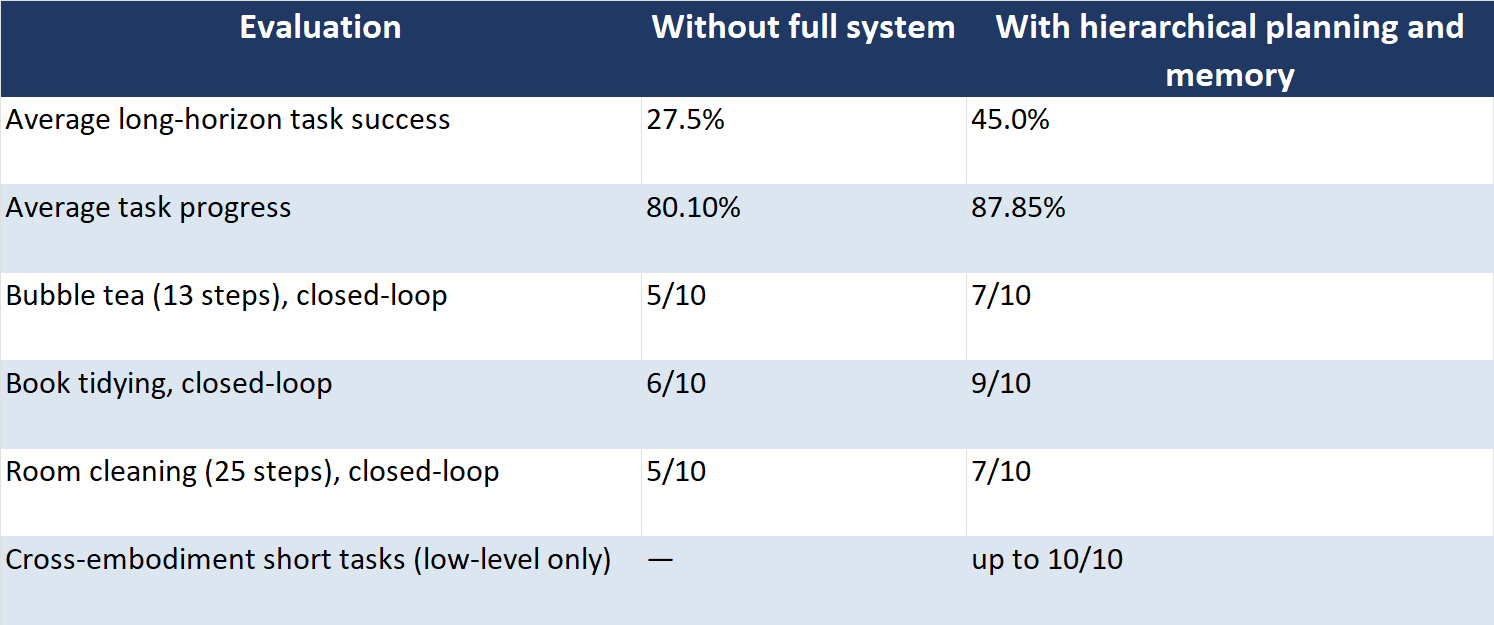
此次發布提出了兩項主張,將在具身人工智慧實驗室中引起迴響。 首先,據開發者所述,τ0-VLA 是首個在子任務決策層級上明確對測試時計算資源進行彈性調度的視覺-語言-動作系統,將 OpenAI 的 o1 和 DeepSeek 的 R1 等推理模型所採用的「慢思考」範式引入實體操作領域。 其次,該系統是基於 40,115 小時的異質性真實世界機器人資料進行預訓練的,其中包括超過 20,000 小時的真實機器人互動資料,研究團隊稱其為迄今為止彙整規模最大的真實機器人預訓練資料庫。 在頭對頭的長時程評估中,該完整系統將平均任務成功率從 27.5% 提升至 45.0%,並在團隊的測試環境中擊敗了 Nvidia 的 GR00T N1.7、LingBot-VLA 以及 Physical Intelligence 的 π0.5。
該架構採用「雙速大腦」設計。底層策略系統建構於視覺-語言骨幹之上,結合「變壓器混合」(Mixture-of-Transformers)動作專家與條件流匹配機制,能快速且反射性地執行連續動作片段。 其上層則設有於子任務邊界觸發的高階決策系統:提案模型(Propose Model)生成候選的下一步動作、世界模型(World Model)預測每個候選動作的視覺終態、價值模型(Value Model)對其進行評分,而反思模型(Reflective Model)則透過束搜索(beam search)合成最終選擇。 實際上,機器人會預想多種未來情境、對其進行評分,並在完成上述步驟後才驅動其馬達。
思考
關鍵時刻更持久對一般讀者而言,這可以比喻為棋盤前的棋手。大多數棋步源於既定模式與習慣,僅需數秒即可完成;而中局關鍵的決策,則會耗費十分鐘進行專注的推算。τ0-VLA 便是以同樣的方式分配其運算資源。 團隊發現,若在每一步驟上都耗費過多時間深思熟慮,效益會遞減;因此,動態路由機制僅在困難節點觸發深度思考,既確保機器人反應靈敏,又將最耗費心力的推理保留給決定成敗的關鍵時刻。
對於這個慣於挑選精華片段展示的領域而言,該設計所呈現的數據格外具體。 在下一子任務預測方面,該系統在 13 步驟的珍珠奶茶製作任務中達 87.3% 的準確率,在分布內的書籍整理任務中達 88.0%,在分布外的變體任務中達 74.0%,而在 25 步驟的房間清潔任務中達 87.0%。 一旦啟用測試時推理功能,真實機器人上的閉環成功率便從 10 次試驗中的 5 次提升至 7 次(珍珠奶茶任務)、從 10 次中的 6 次提升至 9 次(書籍整理任務),以及從 10 次中的 5 次提升至 7 次(房間清潔任務)。 這套評估方案本身便展現了雄心壯志:包含 25 步驟的房間清掃、14 步驟的食物準備,以及 22 步驟的番茄炒蛋;這些任務執行時間介於 3 至 12 分鐘,每項任務進行 10 次試驗,並分別在 AGIBOT G1、ARX AC One 以及雙臂 Franka Research 3 平台上進行測試。 透過統一的 40 維狀態與動作空間(涵蓋末端執行器姿態、關節、夾爪、腰部及移動底座,並對未使用維度進行遮罩),單一模型即可驅動不同的機器人體; 在短期的跨具身任務中,僅憑低階系統便取得了近乎完美的成績,包括在「收集衣物」任務中取得 10 題全對的成績。
這些主要成果彙整成一份異常易於驗證的成績表,因為其背後的實驗資料均已公開。
這些數字背後的數據集,其重要性不亞於系統架構本身。這四萬小時的真實機器人操作經驗並非從網路上抓取而來,而是由人工操作員在專用設施中,一小時一小時地透過遠端操控機器人執行家庭與工業常規任務所累積而成,並輔以 UMI 手持夾爪及公開數據集。 自 2024 年起,AgiBot 便一直在打造這類「數據工廠」,此次發布實質上公開了這項工業投資所帶來的成果,同時仍將工廠本身視為專有資產。這相當於在具身人工智慧領域中,一家煉油廠免費提供汽油樣本,以證明其獨有的原油供應品質。
還有第三個組件將受到實務工作者密切關注:一種可修正的執行記憶體,它會在機器人運作時記錄已完成的階段、限制條件以及局部失敗。團隊透過刻意瑕疵的樣本對其進行訓練——例如記憶體延遲、超前或遺漏失敗記錄——使部署後的系統能在無需額外人工標註的情況下,學會質疑並修復自身的記錄。 任何看過機器人無止盡地重複失敗抓取動作的人,都會明白這解決了什麼問題:冗長的任務並非在第一步失敗,而是在第十一步失敗——當機器遺忘自己已經完成與尚未完成的事項時。
慷慨背後的策略
為何要公開這項成果?此次發布既承襲了研究脈絡,也形成了一種正向循環。 上海創新研究院的羅建蘭團隊此前於六月發表了世界模型 τ0-WM,以及真實世界強化學習後訓練系統 LWD;τ0-VLA 則完善了大規模預訓練加上後訓練數據飛輪的完整流程。至於 AgiBot——這家公司聘請了
本月稍早,阿里巴巴委任三家銀行籌備香港首次公開募股(IPO);將前沿研究開源化,正是阿里巴巴當年對待「Qwen」時採用的策略:將模型層商品化,並透過其上層的硬體、數據服務及部署堆疊來獲利,同時讓成千上萬的外部團隊驗證其架構,而其上市敘事則能藉此吸納相關引用。 這份 40,000 小時的語料庫正是這項免費活動所宣傳的護城河,因為權重可以複製,但由遠端操作平台、UMI 裝置及有人員駐守的資料蒐集設施所組成的資料引擎卻無法被複製。對於持懷疑態度的解讀,值得單獨闡述一段。在長時程任務上平均 45% 的成功率,雖是研究上的里程碑,但還不是可部署的產品;沒有哪家飯店會接受一台會把一半炒菜搞砸的機器人。 在 GR00T、LingBot-VLA 和 π0.5 上的基準測試勝利,源於該團隊自行設計的評估方案——這項限制條件適用於該領域所有自行報告的比較結果, 而《Physical Intelligence》期刊中較新的 π0.7 模型,則是從訓練資料端而非推論端來攻克同一項長時程問題,這是一種範式之爭,單憑某個實驗室的基準測試無法定論。 測試時的審慎思考也會消耗延遲和機器人本機運算資源,而論文中關於收益遞減的發現也暗示,更深入的思考並非「免費午餐」。此次發布所證實的內容範圍雖較狹窄,但仍具重要意義:那些曾徹底改變語言模型的推論時間擴展定律,如今已延伸至操作任務,且相關方法現已公開。
產業背景更突顯了這項成果的重要性。智奇智信將此次發布定位為對懸而未決問題的解答——即在 WAIC 之後的產業中,機器人能否從單一技能展示升級至完成完整任務。 這種定位與買家們不斷向本刊反映的情況相符:採購停滯並非因為機器人無法抓取物件,而是因為無法信任它們能完成任務。一款能將完整任務完成率提升一倍、且任何系統整合商都能下載的模型
今晚,這段影片對信任度的影響,是其他任何後空翻影片都無法比擬的。一場僅有一方在競速的開源競賽
更宏觀的趨勢才是西方實驗室應該關注的。 僅在七月這一個月內,中國機構便已將人形機器人硬體設計、Ecovacs 的家用機器人平台,以及如今這套由國家支持的前沿 VLA 及其訓練配方開源;與此同時,美國領先的機器人「大腦」公司——Physical Intelligence、Skild、Figure——卻將其最佳模型封閉,並維持著數十億的估值。 一種策略是建立生態系統與標準;另一種則是追求利潤。兩者皆可行,但其複利效應截然不同:今年秋季每間對 τ0-VLA 進行微調的大學實驗室,都將成為以中文機器人為基準、隸屬於中文研究生態系的一環,並將改進成果回饋至中國的數據飛輪中。
值得關注的是採用率,而開源技術使這項指標變得可量化。未來一個月內的 GitHub 分支數與 Hugging Face 下載量,將揭示 τ0-VLA 究竟會成為具身人工智慧的「Qwen 時刻」,抑或僅是備受討論的奇聞軼事。 同時也需觀察,這項宣稱的「真實機器人數據紀錄」是否會促使競爭對手公開數據;數據集規模已成為一項競爭指標,而 40,115 小時現已成為眾人爭相超越的標竿。 至於 AgiBot 的投資銀行家們,時機本身便是一種訊息:在強制要求進行首次公開募股(IPO)的三週後,該公司證明其研究部門不僅能設定前沿議程,更有能力將研究成果無償公開。這絕非日曆上的巧合。 這是一家公司向公開市場投資者宣告,它打算主導機器人經濟哪一層面的聲音。對於該領域的其他參與者而言,實際的啟示更為簡單:截至本週,針對長期機器人操作最有效的公開方案來自中國,且是開放且免費的;而所有曾假設相反情況的路線圖,現在都需要加上註腳。 上次有……
中國某實驗室將這項尖端技術公諸於世,該技術名為 DeepSeek R1,隨後六個月內,整個產業都不得不針對其帶來的影響進行重整。本文僅供參考,並不構成投資建議。讀者應在作出投資決策前自行進行研究。











