
中国刚刚为机器人配备了一颗“思维缓慢”的大脑,随后便将其免费提供给了外界
上海创新研究院与AgiBot联合发布了τ0-VLA,这是一种长时域视觉-语言-动作模型,据称其性能优于Google和Physical Intelligence的基线模型,达到了最先进水平。该模型据称是在40,115小时的真实机器人数据集上训练而成,发布时附带了权重和训练方案。 该项目被定位为具身人工智能领域可能出现的“DeepSeek时刻”;其采用指标(分叉数、下载量)被视为值得关注的验证标准。
那场彻底改变了聊天机器人的推理革命,如今已延伸至机器人躯体,而中国正将其免费推广。 7月27日,上海创新研究院与AgiBot的具身研究中心发布了τ0-VLA——一款在任务遇到难点时会暂停思考的机器人基础模型,并将相关论文、代码和权重作为开源项目发布在GitHub和Hugging Face上。
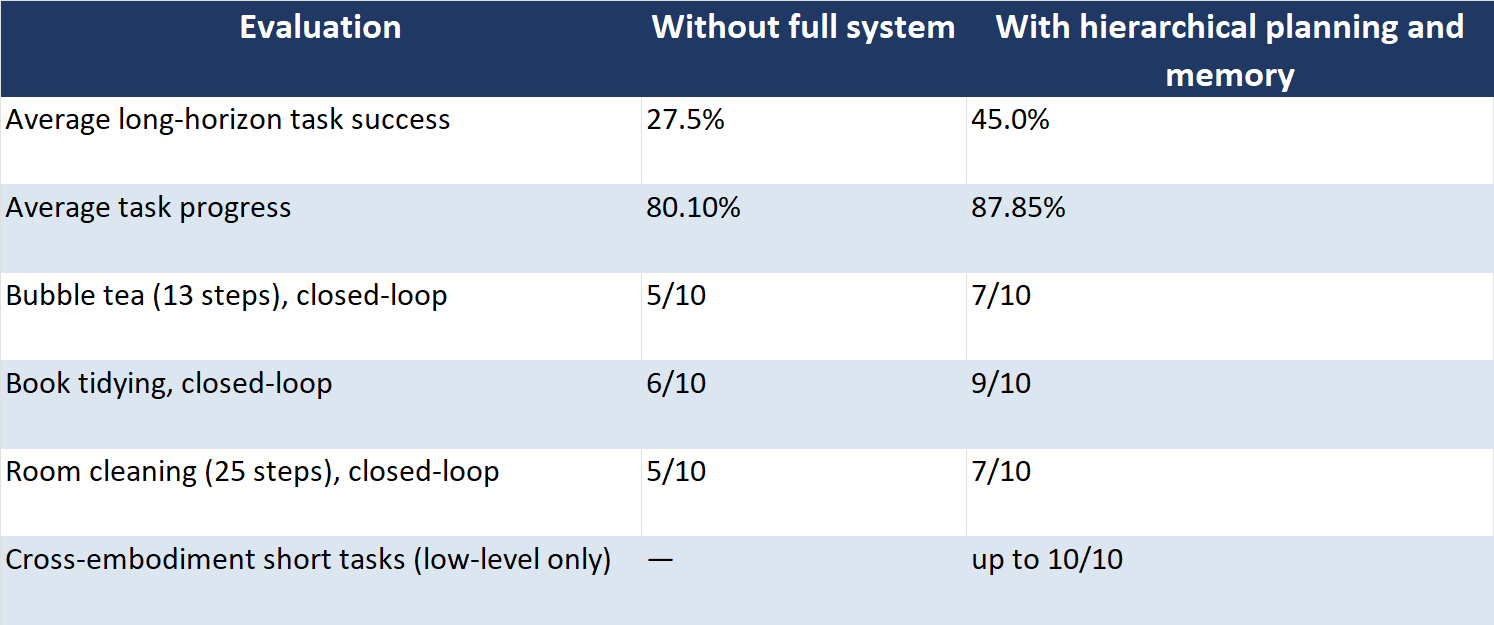
此次发布提出了两项主张,将在具身人工智能实验室中引发广泛反响。 首先,据开发者称,τ0-VLA是首个在子任务决策层面明确对测试时计算进行扩展的视觉-语言-动作系统,将OpenAI的o1和DeepSeek的R1等推理模型所采用的“慢思考”范式引入了物理操作领域。 其次,该系统在40,115小时的异构真实世界机器人数据上进行了预训练,其中包括超过20,000小时的真实机器人交互数据,研究团队称这是迄今为止汇集的最大规模真实机器人预训练数据集。 在头对头的长时域评估中,该完整系统将平均任务成功率从27.5%提升至45.0%,并在团队的测试环境中击败了Nvidia的GR00T N1.7、LingBot-VLA以及Physical Intelligence的π0.5。
该架构采用“双速大脑”设计。低层策略系统基于视觉-语言 backbone 构建,包含混合变压器(Mixture-of-Transformers)动作专家和条件流匹配机制,能够快速且反射性地执行连续的动作片段。 在其之上是一个在子任务边界处激活的高级决策系统:提案模型(Propose Model)生成下一步行动候选方案,世界模型(World Model)预测每个候选方案的视觉终态,价值模型(Value Model)对它们进行评分,而反思模型(Reflective Model)则通过束搜索合成最终选择。 实际上,机器人会预想多种未来状态,对其进行评分,然后才驱动其电机。
思考
关键时刻,时间更充裕对于普通读者来说,这可以类比为棋盘前的国际象棋选手。大多数走法源于既定模式和习惯,几秒钟内即可完成;而中局的关键决策则需要花费十分钟进行集中推演。τ0-VLA 也是以同样的方式分配其计算资源的。 团队发现,若在每个步骤上都耗费过多时间进行深思熟虑,收益将逐渐递减;因此,动态路由机制仅在困难节点上才调用深度思考,既保持机器人的响应能力,又将最耗费精力的推理留给决定成败的关键时刻。
对于一个热衷于展示精心挑选的演示片段的领域而言,该设计所呈现的数据格外具体。 在下一子任务预测方面,该系统在13步的珍珠奶茶制作任务中得分87.3%,在分布内的书籍整理任务中得分88.0%,在分布外的变体任务中得分74.0%,在25步的房间打扫任务中得分87.0%。 在启用测试时推理功能后,真实机器人上的闭环成功率在珍珠奶茶任务中从10次试验中的5次提升至7次,在整理书籍任务中从6次提升至9次,在房间清洁任务中从5次提升至7次。 评估套件本身就彰显了雄心:25步房间清洁、14步食物准备、22步番茄炒蛋;任务运行时长为3至12分钟,每项任务进行10次试验,分别在AGIBOT G1、ARX AC One以及双臂Franka Research 3平台上进行。 一个统一的40维状态和动作空间,涵盖末端执行器姿态、关节、抓手、腰部和移动底座,并对未使用的维度进行屏蔽,从而使一个模型能够驱动不同的机器人机体; 在短时跨具体任务中,仅靠该低级系统便取得了近乎完美的成绩,包括在衣物收集任务中10次全对。
这些主要成果被浓缩成一份评分榜,其可验证性尤为突出,因为其背后的实现细节均已公开。
支撑这些数字的数据集与架构本身同样值得关注。这4万小时的真实机器人操作经验并非从互联网上抓取而来,而是由人工操作员在配备专职人员的设施中,通过远程操控机器人在家庭和工业场景中执行常规任务,一小时一小时地积累而成,并辅以手持式UMI夹爪和公开数据集。 自2024年以来,AgiBot一直在构建正是这种“数据工厂”,此次发布实际上是将这一工业投资的红利公之于众,同时将工厂本身作为专有资产保留下来。这相当于在具身人工智能领域,一家炼油厂免费提供汽油样品,以此证明其拥有其他任何人都没有的原油供应的质量。
还有一个关键组件值得从业者密切关注:可修正的执行内存,它会在机器人工作时记录已完成的阶段、约束条件以及局部故障。团队使用故意篡改的样本对其进行训练——这些样本的内存记录会滞后、超前或遗漏故障——从而使部署后的系统学会在不依赖额外人工标注的情况下,对自身记录产生怀疑并进行修复。 任何看过机器人无休止地重复失败抓取动作的人,都会明白这解决了什么问题:长任务的失败并非发生在第一步,而是发生在第十一步——当机器无法追踪自己已经完成和尚未完成的操作时。
慷慨背后的策略
为何要公开这一成果?此次发布既延续了研究脉络,也形成了良性循环。 上海创新研究院的罗建兰团队此前于6月发布了世界模型τ0-WM,以及现实世界强化学习后训练系统LWD;τ0-VLA则完善了大规模预训练加后训练数据飞轮的完整管道。对于AgiBot来说,该公司聘请了
本月早些时候,阿里巴巴选定了三家投行筹备在香港上市;而将前沿研究开源,正是阿里巴巴此前在“Qwen”项目中采取的策略:将模型层商品化,通过其上层的硬件、数据服务及部署栈实现变现,同时让成千上万的外部团队验证其架构,而上市叙事则从中汲取引用价值。 这4万小时的语料库正是该活动宣传中所强调的护城河,因为权重可以被复制,但由远程操作平台、UMI设备及有人值守的数据采集设施组成的数据引擎却无法被复制。对于持怀疑态度的解读,值得单独成段探讨。在长时任务上45%的平均成功率虽是一项研究里程碑,却并非可部署的产品;没有哪家酒店会接受一个会搞砸一半炒菜的机器人。 在基准测试中战胜GR00T、LingBot-VLA和π0.5的成绩源于该团队自设的评估方案——这一限制条件适用于该领域所有自我报告的对比结果, 而《Physical Intelligence》期刊中较新的π0.7模型则是从训练数据层面而非推理层面攻克同一长时域问题,这种范式之争无法仅凭一个实验室的基准测试结果来定论。 测试时的深思熟虑也会消耗延迟和机器人端的计算资源,而论文中关于收益递减的发现表明,更深入的思考并非“免费午餐”。此次发布所证明的结论范围虽更窄,但依然意义重大:那些曾彻底改变语言模型的推理时间扩展定律,如今已转移到操作任务领域,且其实现方法现已公开。
工业背景进一步凸显了其重要性。智奇智信将此次发布定位为对WAIC后行业悬而未决问题的解答——即机器人能否从单一技能演示升级到完成整项任务。 这种表述与买家们反复向本刊反映的情况一致:采购停滞并非因为机器人无法抓取,而是因为无法信赖它们能完成任务。一个能将整体任务完成率提高一倍、且任何系统集成商都能下载的模型
今晚,这部视频对信任度的影响,是其他任何后空翻视频都无法比拟的。一场单方面进行的开源竞赛
更值得西方实验室关注的是这一更广泛的趋势。 仅在七月这一月内,中国机构就开源了类人机器人硬件设计、Ecovacs的家用机器人平台,如今又开源了由国家支持的前沿VLA及其训练方案;而美国领先的机器人“大脑”公司——Physical Intelligence、Skild、Figure——却将它们最优秀的模型封存起来,估值仍高达数十亿美元。 一种策略是构建生态系统和标准;另一种则是追求利润。两者皆可奏效,但其累积效应截然不同:今年秋季,每一家对 τ0-VLA 进行微调的大学实验室,都将成为以中文机器人为基准、中文研究栈的一部分,并将改进成果回馈至中国数据飞轮之中。
值得关注的是应用情况,而开源技术使这一指标变得可量化。未来一个月内的GitHub分叉数量和Hugging Face下载量,将揭示τ0-VLA究竟会成为具身AI领域的“Qwen时刻”,还是沦为一份有据可查的奇闻轶事。 同时也要关注,其宣称的真实机器人数据记录是否会促使竞争对手披露相关数据;数据集规模刚刚成为一项竞争性指标,而40,115小时如今已成为需要超越的数字。 对于AgiBot的投资人而言,时机本身就是一种信号:在宣布进行首次公开募股(IPO)的三周后,该公司证明其研发部门不仅能够引领前沿议程,更有能力将研究成果公之于众。这绝非日程安排上的巧合。 这是该公司向公开市场投资者宣告,它意图在机器人经济的哪个层级占据主导地位。对于该领域中的其他参与者而言,实际的启示则更为简单:截至本周,针对长期机器人操控领域最强大的公开方案来自中国,且是开放、免费的;而所有曾对此持不同假设的路线图,如今都需要加上脚注了。 上次有……
中国某实验室公开了这一级别的尖端技术,该技术被称为“DeepSeek R1”,此后六个月里,整个行业都在围绕这一事件带来的影响进行调整。本文仅供参考,不构成投资建议。读者在做出投资决策前应自行进行研究。











