
China hat Robotern gerade ein langsam denkendes Gehirn spendiert – und dieses dann kostenlos zur Verfügung gestellt
Das Shanghai Innovation Institute hat gemeinsam mit AgiBot „τ0-VLA“ veröffentlicht, ein Vision-Language-Action-Modell mit langem Zeithorizont, das nach eigenen Angaben Ergebnisse auf dem neuesten Stand der Technik liefert und die Baseline-Werte von Google sowie von Physical Intelligence übertrifft. Das Modell wurde auf einem Korpus aus 40.115 Stunden Echtroboter-Daten trainiert und zusammen mit den Gewichten sowie dem Trainingsrezept veröffentlicht. Es wird als potenzieller „DeepSeek-Moment“ der verkörperten KI positioniert; als entscheidender Indikator für die Verifizierung werden die Akzeptanzkennzahlen (Forks, Downloads) genannt.
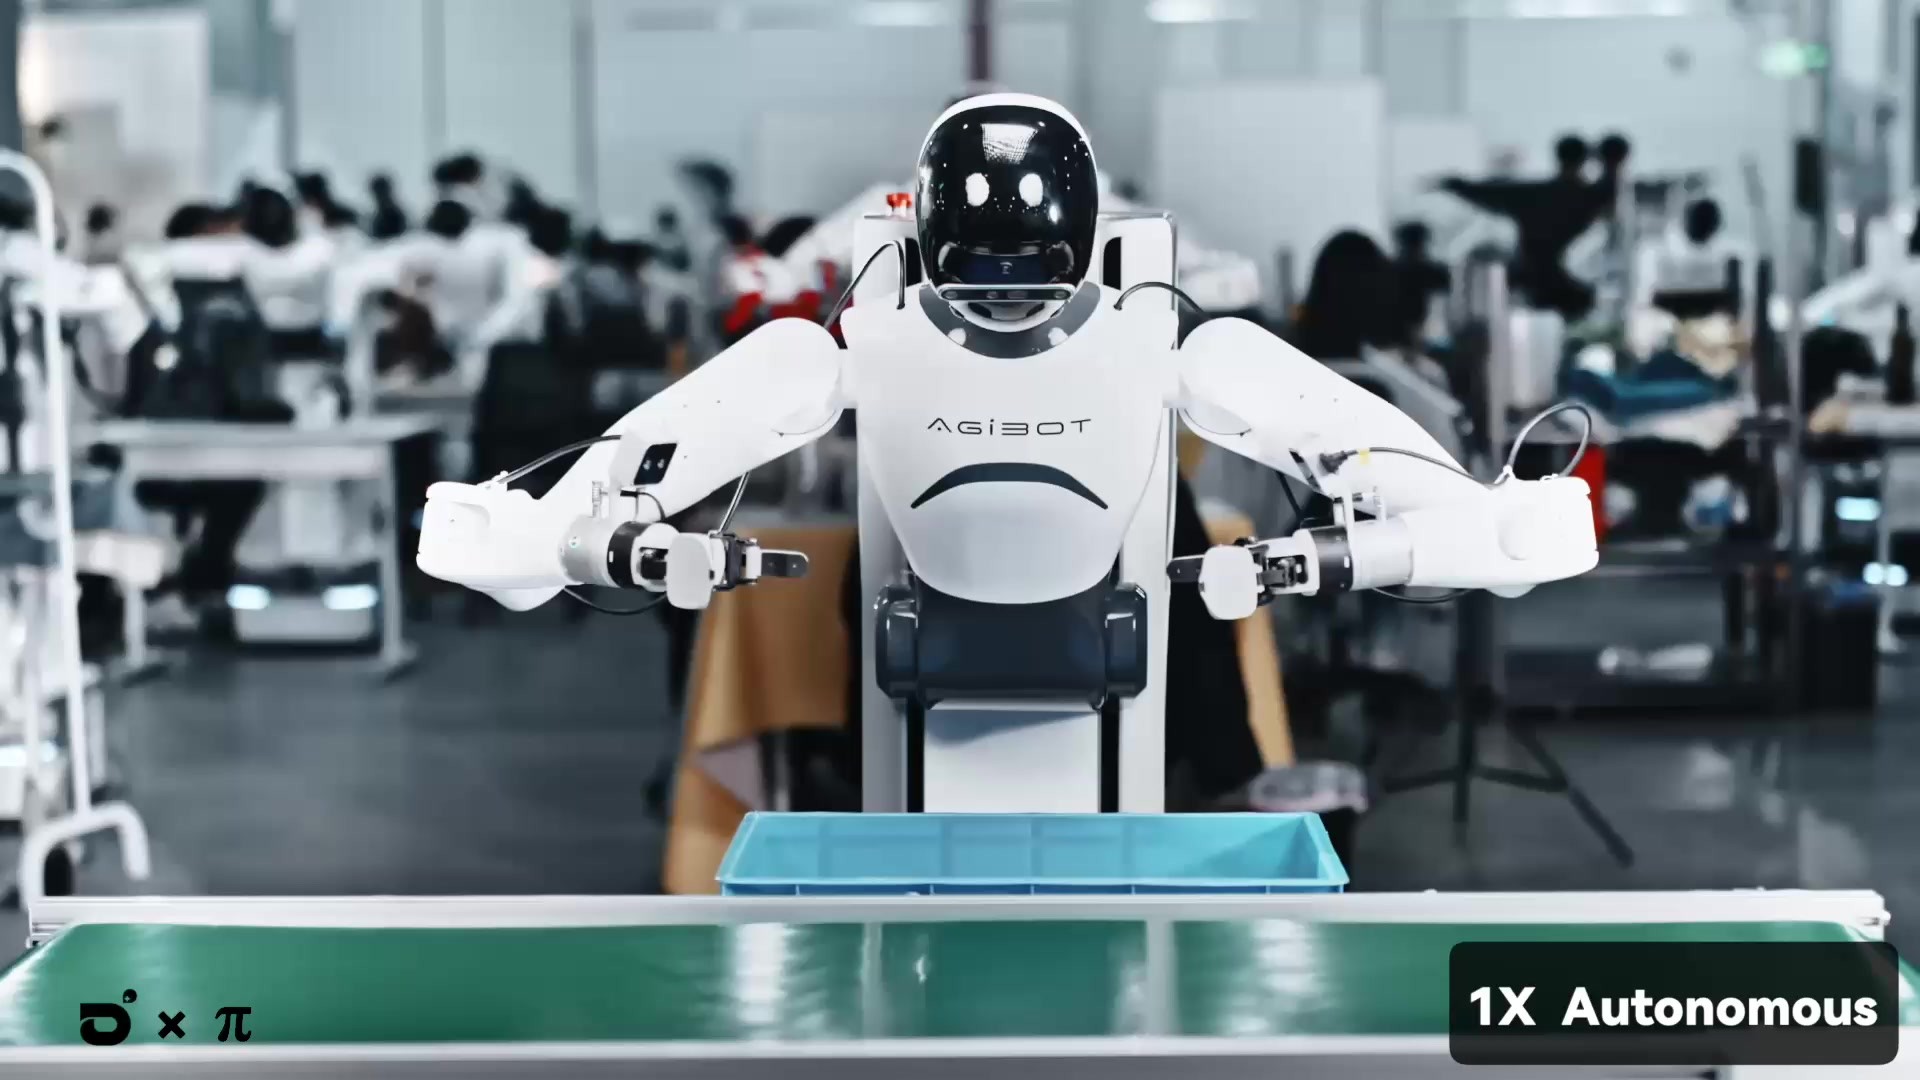
Die Revolution im Bereich des logischen Denkens, die Chatbots grundlegend verändert hat, hat nun auch Roboter erreicht, und China stellt sie kostenlos zur Verfügung. Das Shanghai Innovation Institute und das Embodied Research Center von AgiBot haben am 27. Juli „τ0-VLA“ veröffentlicht – ein Roboter-Grundmodell, das in schwierigen Momenten einer Aufgabe innehält, um zu überlegen – und die Forschungsarbeit, den Quellcode sowie die Gewichte als Open Source auf GitHub und Hugging Face bereitgestellt.
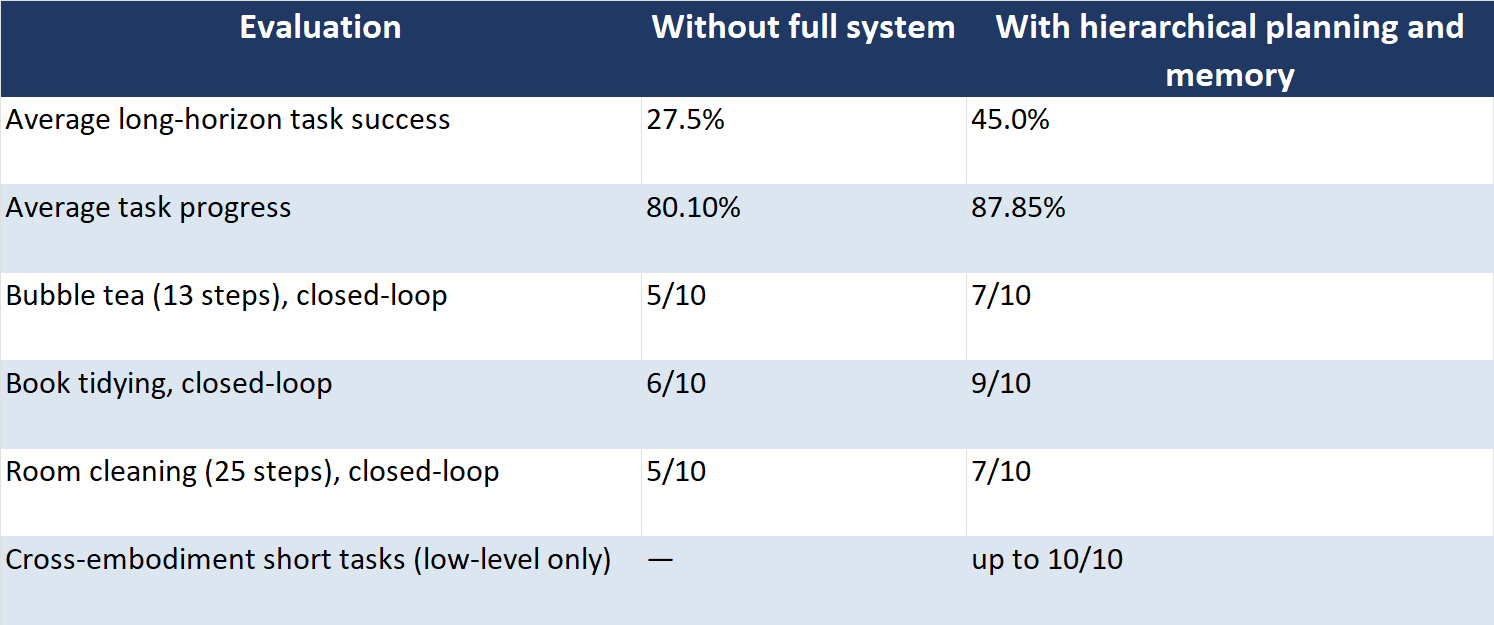
Die Veröffentlichung enthält zwei Aussagen, die in den Forschungslabors für verkörperte KI große Resonanz finden werden. Erstens ist τ0-VLA nach Angaben seiner Entwickler das erste Vision-Language-Action-System, das die Rechenleistung zur Testzeit explizit auf der Ebene von Teilaufgabenentscheidungen skaliert und damit das Paradigma des langsamen Denkens von Schlussfolgerungsmodellen wie OpenAI’s o1 und DeepSeek’s R1 in die physische Manipulation überträgt. Zweitens wurde es auf der Grundlage von 40.115 Stunden heterogener, realer Roboterdaten vortrainiert, darunter mehr als 20.000 Stunden Interaktionsdaten mit echten Robotern – ein Korpus, den das Team als den bislang größten zusammengestellten Vortrainingskorpus mit echten Robotern bezeichnet. In direkten Vergleichstests mit langem Zeithorizont steigerte das Gesamtsystem die durchschnittliche Aufgabenerfolgsquote von 27,5 Prozent auf 45,0 Prozent und schlug in der Testumgebung des Teams Nvidias GR00T N1.7, LingBot-VLA sowie π0.5 von Physical Intelligence.
Die Architektur besteht aus einem „Zwei-Geschwindigkeits-Gehirn“. Ein Low-Level-Policy-System, das auf einem Vision-Language-Backbone mit einem „Mixture-of-Transformers“-Aktions-Experten und bedingtem Flow-Matching aufbaut, führt fortlaufende Aktionsblöcke schnell und reflexartig aus. Darüber befindet sich ein hochrangiges Entscheidungssystem, das an den Grenzen von Teilaufgaben aktiviert wird: Ein „Propose Model“ generiert mögliche nächste Schritte, ein „World Model“ prognostiziert den visuellen Endzustand jedes Kandidaten, ein „Value Model“ bewertet diese, und ein „Reflective Model“ synthetisiert die endgültige Wahl mittels Beam-Search. Der Roboter stellt sich also gewissermaßen mehrere Zukunftsszenarien vor, bewertet sie und steuert erst dann seine Motoren an.
Denken
Länger, wenn es darauf ankommtFür den Laien lässt sich dies mit einem Schachspieler am Brett vergleichen. Die meisten Züge erfolgen nach Mustern und Gewohnheiten und sind in Sekundenschnelle ausgeführt; die entscheidende Entscheidung im Mittelspiel erfordert hingegen zehn Minuten konzentrierten Kalküls. τ0-VLA teilt seine Rechenzeit auf dieselbe Weise ein. Das Team stellte fest, dass sich der Aufwand für ausführliche Überlegungen bei jedem einzelnen Schritt nicht mehr lohnte; daher greift ein dynamischer Routing-Mechanismus nur an schwierigen Knotenpunkten auf tiefgreifendes Denken zurück, wodurch der Roboter reaktionsfähig bleibt, während er seine aufwendigsten Denkprozesse für die Momente reserviert, die über den Erfolg entscheiden.
Die Zahlen, die diesem Entwurf zugrunde liegen, sind ungewöhnlich konkret für ein Fachgebiet, das dazu neigt, nur handverlesene Demovideos zu präsentieren. Bei der Vorhersage der nächsten Teilaufgabe erzielte das System 87,3 Prozent bei einer 13-stufigen Bubble-Tea-Zubereitung, 88,0 Prozent beim Aufräumen von Büchern innerhalb der Verteilung, 74,0 Prozent bei Varianten außerhalb der Verteilung und 87,0 Prozent bei einer 25-stufigen Zimmerreinigung. Die Erfolgsquote im geschlossenen Regelkreis auf echten Robotern stieg bei der Bubble-Tea-Zubereitung von 5 von 10 auf 7 von 10 Versuchen, beim Aufräumen von Büchern von 6 von 10 auf 9 von 10 und bei der Zimmerreinigung von 5 von 10 auf 7 von 10, sobald das Schlussfolgern während des Tests aktiviert wurde. Die Evaluierungssuite selbst zeugt von hohen Ambitionen: eine 25-stufige Zimmerreinigung, eine 14-stufige Speisezubereitung, ein 22-stufiges Tomaten-Ei-Pfannengericht, Aufgaben mit einer Laufzeit von drei bis zwölf Minuten, jeweils zehn Versuche, auf den Plattformen AGIBOT G1, ARX AC One und dem zweiarmen Franka Research 3. Ein einheitlicher 40-dimensionaler Zustands- und Aktionsraum, der die Endeffektor-Pose, Gelenke, Greifer, Taille und mobile Basis abdeckt – wobei nicht verwendete Dimensionen maskiert werden –, ermöglicht es, mit einem einzigen Modell verschiedene Roboterkörper anzusteuern; Bei kurzen Aufgaben mit unterschiedlichen Verkörperungen erzielte das Low-Level-System allein nahezu perfekte Ergebnisse, darunter 10 von 10 Punkten beim Sammeln von Kleidungsstücken.
Die wichtigsten Ergebnisse lassen sich in einer Ergebnisübersicht zusammenfassen, die ungewöhnlich gut überprüfbar ist, da die zugrunde liegenden Daten öffentlich zugänglich sind.
Der hinter diesen Zahlen stehende Datenbestand verdient ebenso viel Aufmerksamkeit wie die Architektur. Vierzigtausend Stunden Erfahrung mit echten Robotern werden nicht aus dem Internet zusammengetragen; sie werden Stunde für Stunde in bemannten Einrichtungen erzeugt, in denen menschliche Bediener Roboter bei Haushalts- und Industrieaufgaben fernsteuern, ergänzt durch tragbare UMI-Greifer und öffentliche Datensätze. AgiBot baut seit 2024 genau diese Art von Datenfabrik auf, und mit dieser Veröffentlichung werden die Früchte dieser industriellen Investition effektiv veröffentlicht, während die Fabrik selbst proprietär bleibt. Es ist das verkörperte KI-Äquivalent einer Raffinerie, die Benzinproben verschenkt, um die Qualität einer Rohölquelle zu beweisen, über die sonst niemand verfügt.
Es gibt eine dritte Komponente, die Fachleute genau unter die Lupe nehmen werden: ein korrigierbares Ausführungsspeicher, der abgeschlossene Phasen, Einschränkungen und lokale Fehler während der Arbeit des Roboters aufzeichnet. Das Team trainierte ihn mit absichtlich verfälschten Beispielen – Speicher, der Fehler verzögert, vorwegnimmt oder auslässt –, sodass das eingesetzte System lernt, seinen eigenen Aufzeichnungen zu misstrauen und diese ohne zusätzliche manuelle Anmerkungen zu korrigieren. Jeder, der schon einmal beobachtet hat, wie ein Roboter einen fehlgeschlagenen Greifvorgang endlos wiederholt, wird erkennen, welches Problem damit gelöst wird: Lange Aufgaben scheitern nicht im ersten Schritt, sondern im elften, wenn die Maschine den Überblick darüber verliert, was sie bereits erledigt hat und was noch nicht.
Die Strategie hinter der Großzügigkeit
Warum wird dies preisgegeben? Die Veröffentlichung fügt sich in eine Tradition und einen Dynamikzyklus ein. Das Team um Luo Jianlan am Shanghai Innovation Institute veröffentlichte bereits im Juni τ0-WM, ein Weltmodell, zusammen mit LWD, einem realitätsnahen System für das verstärkende Lernen nach dem Training; τ0-VLA vervollständigt eine Pipeline aus groß angelegter Vorausbildung sowie einem Daten-Flywheel für das Nachtraining. Für AgiBot, das
Drei Banken für einen Börsengang in Hongkong Anfang dieses Monats: Die Open-Source-Veröffentlichung von Pionierforschung ist dieselbe Strategie, die Alibaba mit Qwen verfolgt hat: Die Modellschicht als Standardprodukt etablieren, die darüber liegende Hardware, die Datendienste und den Bereitstellungsstack monetarisieren und tausend externe Teams Ihre Architektur validieren lassen, während Ihr Börsenprospekt die Zitate aufgreift. Der 40.000-Stunden-Korpus ist der Wettbewerbsvorteil, mit dem in der Werbeanzeige geworben wird, denn Gewichte lassen sich kopieren, eine Daten-Engine aus Fernsteuerungsanlagen, UMI-Geräten und mit Personal besetzten Erfassungszentren hingegen nicht.Die skeptische Sichtweise verdient einen eigenen Absatz. Eine durchschnittliche Erfolgsquote von 45 Prozent bei Aufgaben mit langfristigem Zeithorizont ist ein Meilenstein in der Forschung, kein einsetzbares Produkt; kein Hotel wird einen Roboter akzeptieren, der die Hälfte seiner Pfannengerichte ruiniert. Die Benchmark-Erfolge gegenüber GR00T, LingBot-VLA und π0,5 beruhen auf dem teaminternen Bewertungsdesign – ein Vorbehalt, der für jeden selbst gemeldeten Vergleich in diesem Bereich gilt, und der neuere π0.7 von Physical Intelligence geht dasselbe Problem mit langem Zeithorizont eher von der Seite der Trainingsdaten als von der Seite der Inferenz an – ein Paradigmenkonflikt, den der Benchmark eines einzelnen Labors nicht klären kann. Das Nachdenken während der Testphase verursacht zudem Latenz und Rechenaufwand auf dem Roboter, und die in der Veröffentlichung selbst festgestellten abnehmenden Erträge deuten darauf hin, dass intensiveres Nachdenken keinen kostenlosen Vorteil bietet. Was die Veröffentlichung belegt, ist zwar enger gefasst, aber dennoch bedeutsam: Die Skalierungsgesetze für die Inferenzzeit, die Sprachmodelle revolutioniert haben, lassen sich auf die Manipulation übertragen, und das Rezept ist nun öffentlich zugänglich.
Der industrielle Kontext unterstreicht die Bedeutung. Jiqizhixin stellte die Veröffentlichung als Antwort auf die Frage dar, die seit der WAIC über der Branche schwebt: ob Roboter den Sprung von Demonstrationen einzelner Fähigkeiten hin zur Ausführung ganzer Aufgaben schaffen können. Diese Darstellung deckt sich mit dem, was Käufer dieser Publikation immer wieder mitteilen: Die Beschaffung stockt nicht, weil Roboter nicht greifen können, sondern weil man ihnen nicht zutraut, Aufgaben zu Ende zu führen. Ein Modell, das die Erledigung ganzer Aufgaben verdoppelt und das jeder Integrator herunterladen kann
Heute Abend bewegt es die Vertrauensskala auf eine Weise, wie es kein anderes Backflip-Video jemals vermögen wird.Ein Open-Source-Wettlauf, bei dem nur eine Seite antritt
Es ist das übergeordnete Muster, das westlichen Forschungslabors Anlass zur Sorge geben sollte. Innerhalb eines einzigen Julis haben chinesische Institutionen humanoide Hardware-Entwürfe, eine Heimroboterplattform von Ecovacs und nun ein staatlich gefördertes Pionier-VLA mit dessen Trainingsrezept als Open-Source veröffentlicht, während die führenden amerikanischen Unternehmen für Robotergehirne – Physical Intelligence, Skild und Figure – ihre besten Modelle unter Verschluss halten und ihre Unternehmensbewertungen im Milliardenbereich liegen. Die eine Strategie schafft Ökosysteme und Standards; die andere sorgt für Gewinnmargen. Beide können funktionieren, wirken sich jedoch unterschiedlich aus: Jedes Universitätslabor, das τ0-VLA in diesem Herbst optimiert, wird Teil eines chinesischsprachigen Forschungsökosystems, das sich an chinesischen Robotern orientiert und Verbesserungen zurück in ein chinesisches Daten-Flywheel einspeist.
Im Fokus steht die Akzeptanz, die durch Open Source messbar wird. GitHub-Forks und Hugging-Face-Downloads im kommenden Monat werden zeigen, ob τ0-VLA zum „Qwen-Moment“ der verkörperten KI wird oder eine gut dokumentierte Kuriosität bleibt. Beobachten Sie zudem, ob der behauptete Datensatz mit echten Robotern die Konkurrenten zu Offenlegungen veranlasst; die Korpusgröße ist gerade zu einer wettbewerbsrelevanten Kennzahl geworden, und 40.115 Stunden sind nun die zu schlagende Marke. Und für die Geldgeber von AgiBot ist der Zeitpunkt eine Botschaft für sich: Drei Wochen nach der Anordnung eines Börsengangs hat das Unternehmen gezeigt, dass sein Forschungszweig die Agenda an der Spitze bestimmen und es sich leisten kann, das Ergebnis preiszugeben. Das ist kein Zufall des Zeitplans. Es ist das Signal eines Unternehmens, das den Anlegern am öffentlichen Markt mitteilt, welche Ebene der Roboterwirtschaft es zu beherrschen gedenkt. Für alle anderen in der Branche ist die praktische Erkenntnis einfacher: Seit dieser Woche ist das leistungsstärkste öffentlich zugängliche Konzept für die Robotermanipulation mit langfristiger Perspektive chinesisch, offen und kostenlos, und jede Roadmap, die von etwas anderem ausging, benötigt nun eine Fußnote. Das letzte Mal, als ein
Ein chinesisches Labor gab eine bahnbrechende Technologie auf diesem Niveau preis – sie hieß „DeepSeek R1“ –, und die Branche verbrachte die folgenden sechs Monate damit, sich auf die daraus resultierenden Konsequenzen einzustellen.Dieser Artikel dient ausschließlich zu Informationszwecken und stellt keine Anlageberatung dar. Leser sollten eigene Recherchen anstellen, bevor sie Anlageentscheidungen treffen.











