
从后空翻到叠衣服:X Square Robot 如何为具身人工智能构建缺失的“大脑”
中国机器人初创公司X Square Robot已将三项具身人工智能技术开源,这些技术旨在提升机器人的智能水平、物理推理能力及数据利用效率。该公司认为,该行业面临的主要挑战已不再是硬件,而是如何让机器人更好地理解现实世界并与之互动。
当全球各地的机器人公司仍在不断展示人形机器人后空翻、穿越障碍赛道以及在舞台上跳舞时,一家中国公司却正在追求一个更困难——甚至可以说更具深远意义——的目标:教会机器人在人们实际生活和工作的杂乱无章、难以预测的环境中运作。
据X Square Robot创始人兼首席执行官王倩介绍,该行业的硬件基础已基本具备。类人机器人的行走能力、灵巧的手部动作以及力控系统都取得了快速进步。剩下的挑战在于智能。
“硬件方面基本已经到位,”王倩表示,“真正的瓶颈在于‘大脑’。”
为弥合这一差距,X Square Robot在过去几周内开源了三项技术:Wall-OSS-0.5,一个视觉-语言-动作(VLA)模型; WALL-WM,一种旨在理解物理事件的世界动作模型;以及XRZero-G0,一个旨在大幅降低数据成本的无需机器人的数据采集和训练框架。
预训练能教会机器人真正的技能吗?
VLA模型已成为具身人工智能的主要方法之一,但一个根本性问题依然存在:预训练本身能否教会机器人有用的技能,还是仅仅为特定任务的微调做准备?
Wall-OSS-0.5 的设计初衷正是为了解答这一问题。X Square Robot 并未对微调后的模型进行评估,而是将预训练模型直接部署在实体机器人上,并在 17 项真实世界任务中进行了测试。该系统在物体分类、环形堆叠,甚至可变形物体操作方面都展现出了出色的零样本性能。
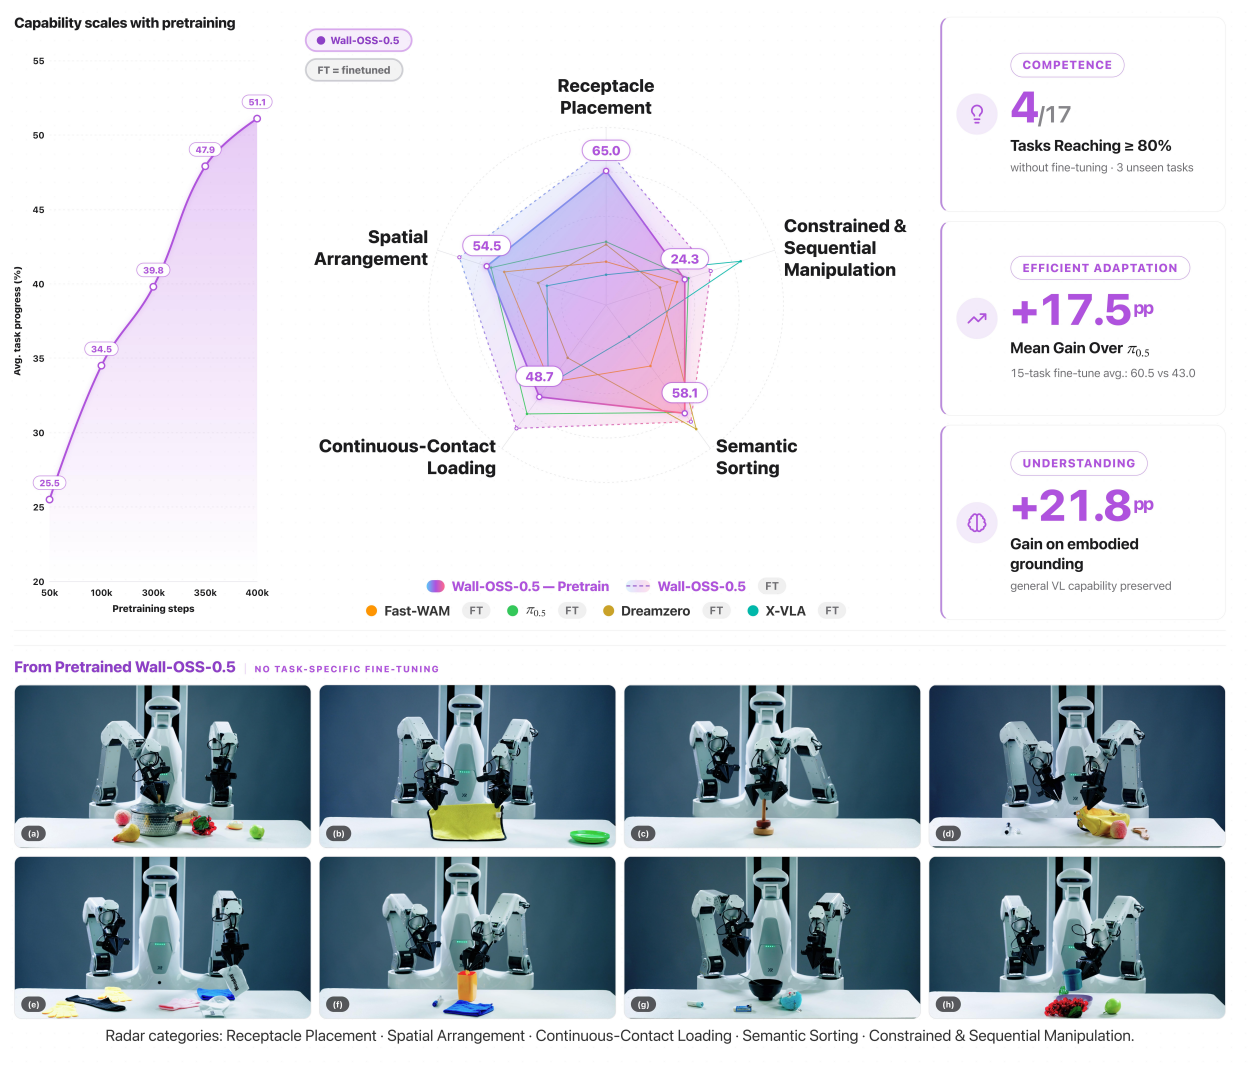
该模型的核心是一个“梯度桥接”训练框架。Wall-OSS-0.5 没有将感知和控制分离为不同的模块,而是将机器人动作转换为动作令牌,这些令牌
在预训练阶段与语言和视觉表征一同学习。这使得感知、语言理解和动作生成能够在统一的模型中协同发展。该公司发现,动作训练不仅提升了操作能力,还增强了视觉锚定性能,这表明物理交互可以强化模型对世界的理解。
教机器人了解世界如何运作
尽管 Wall-OSS-0.5 展示了 VLA 预训练的潜力,但 X Square Robot 认为仅靠模仿还远远不够。
大多数VLA系统虽然能学习动作轨迹,却未能真正理解物理层面的因果关系。它们可以重复训练中观察到的行为,但在面对陌生情境时往往难以应对。
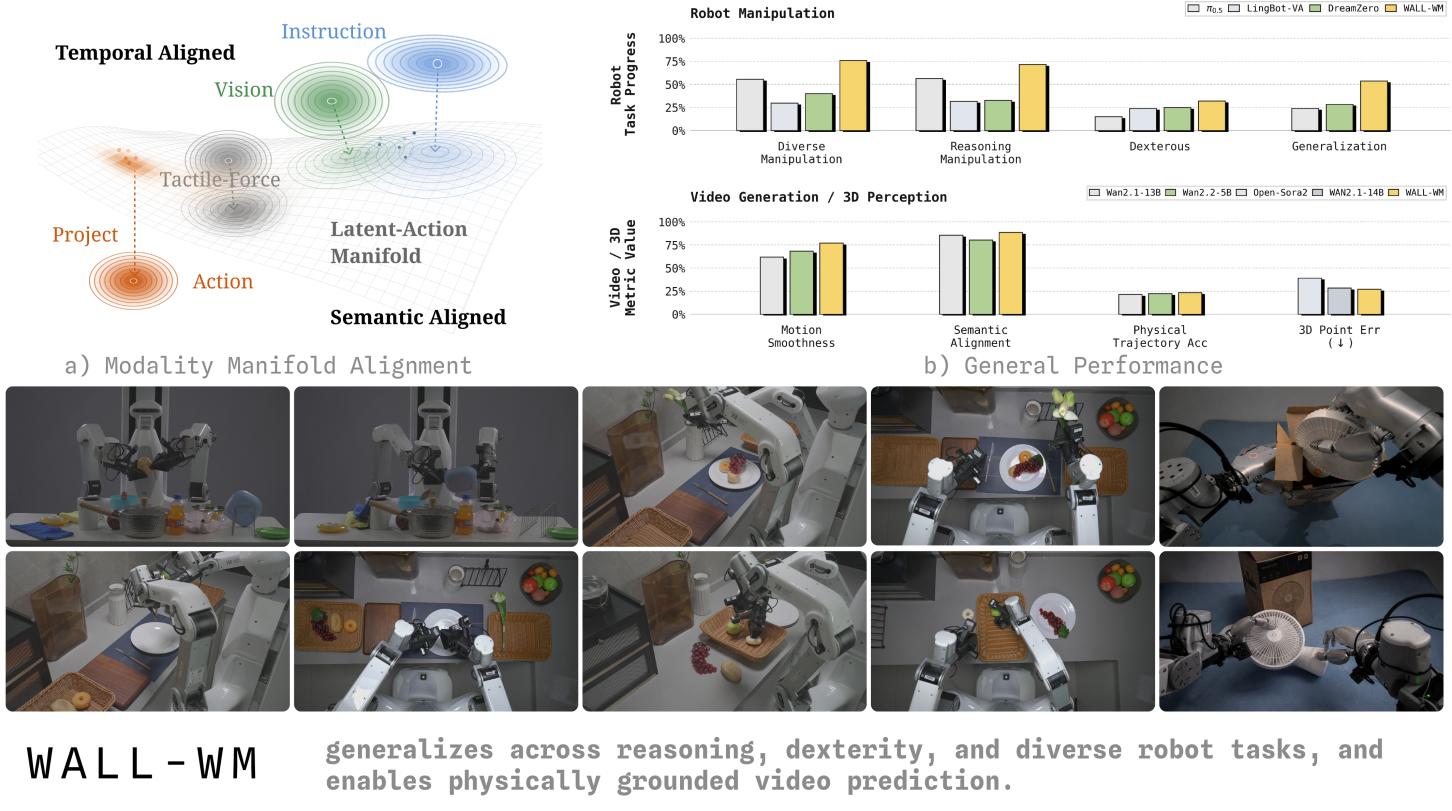
为解决这一局限,该公司推出了WALL-WM(世界动作模型),该模型将学习重点从固定的动作序列转向具有实际意义的物理事件,例如伸手、抓取、抬起和放置。
与将感知、语言和控制分离的传统架构不同,WALL-WM 围绕现实世界事件将视觉观察、语言描述和动作统一起来。其目标是使机器人不仅能够采取行动,还能预测结果、对物理变化进行推理,并在计划失败时进行适应。
据该公司称,这一方法标志着机器人向能够从经验中学习并持续提升对物理世界理解能力迈出了重要一步。
解决具身人工智能的数据瓶颈
如果说世界模型是大脑,那么数据就是燃料。
收集高质量的机器人演示数据成本高昂、耗时且难以实现规模化。X
Square Robot 的解决方案是 XRZero-G0,这是一个用于无需机器人即可进行数据采集和训练的软硬件框架。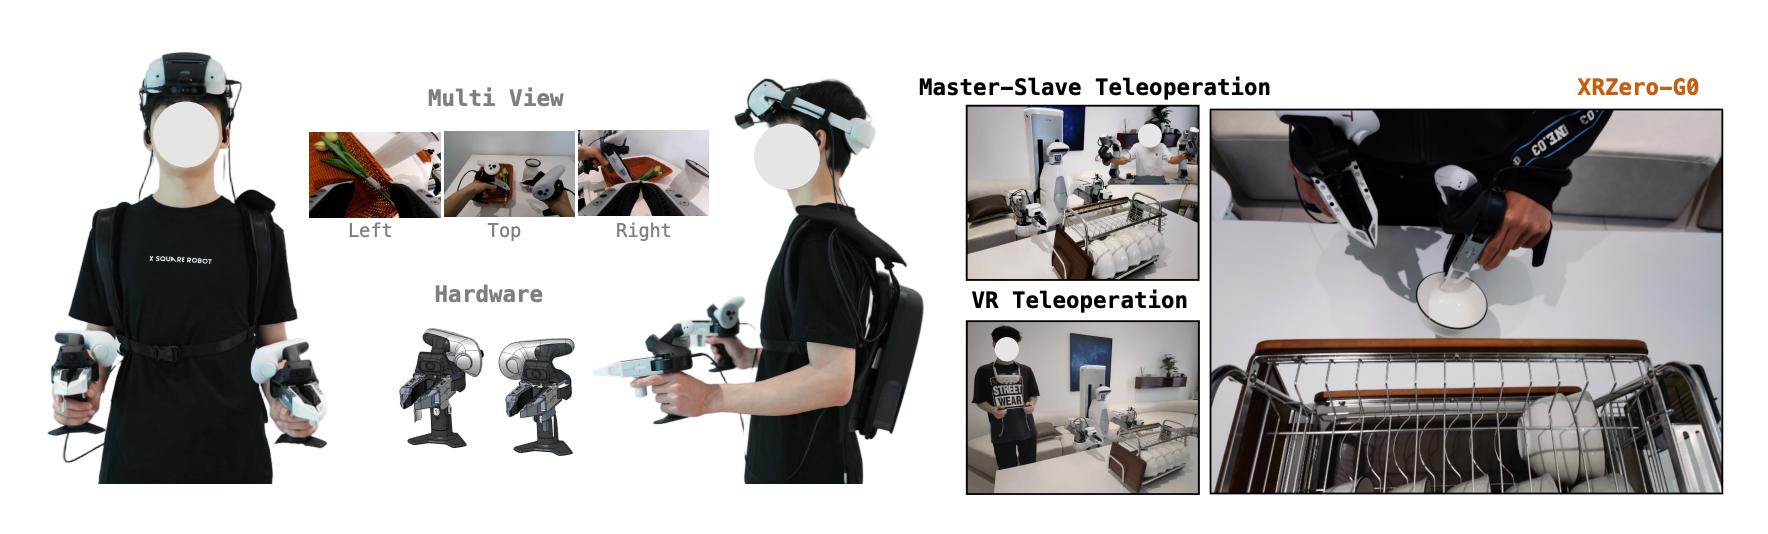
该系统融合了可穿戴接口、多视角感知、自动化质量检测以及真实机器人验证技术,在提升数据质量的同时降低了采集成本。通过受控实验,Square Robot发现,将十次无需机器人的演示与一次真实机器人演示相结合,其性能可媲美完全由真实机器人数据构建的数据集。
该公司还发布了超过2,000小时、涵盖约3,000项任务的多模态数据,以支持具身人工智能领域的更广泛研究。
构建具身智能的基础设施
这三项发布共同解决了具身人工智能面临的一些最重要挑战。
Wall-OSS-0.5 探索了预训练能否直接产生可迁移的机器人技能;WALL-WM 研究了机器人如何对物理世界进行建模和推理;XRZero-G0 则致力于解决支撑这两种方法的数据瓶颈问题。
综合来看,它们共同构成了一个涵盖数据、世界模型和机器人基础模型的全栈框架。
对于首席执行官王先生而言,该行业的转折点可能比许多人预期的要近得多。挑战已不再是教机器人如何移动,而是教它们如何理解所处的世界。
“具身智能的‘顿悟时刻’,”他说,“可能比人们想象的要近得多。”
GitHub 页面:
Wall-OSS-0.5:
https://github.com/X-Square-Robot/wall-x











