
通用型機器人的現實檢驗:RoboDojo 基準測試揭示了關於具身人工智慧的什麼?
新發布的 RoboDojo 基準測試揭露了當前通用型機器人操作模型的嚴酷現實,顯示其成功率僅為個位數,並對業界在短期內實現可投入量產的具身人工智慧的時程表構成挑戰。
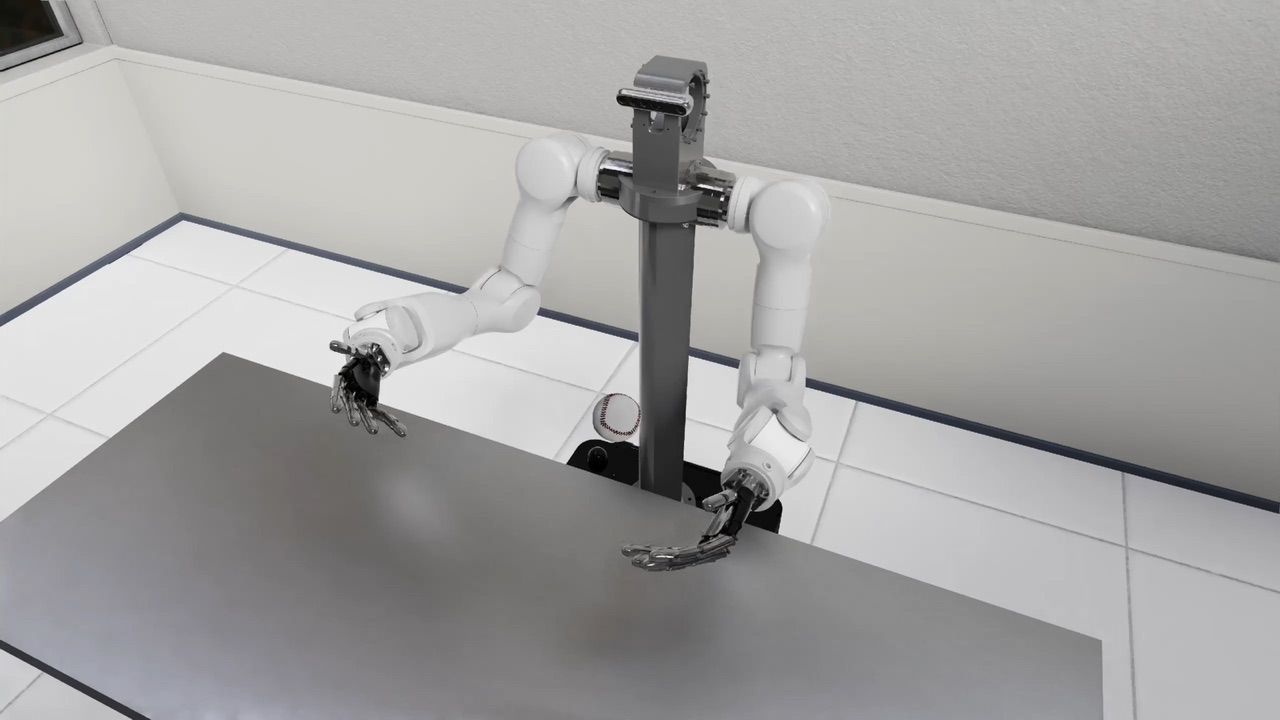
多年來,機器人產業一直籠罩在一种令人安心且極具視覺衝擊力的錯覺之中。各家公司經常展示經過大量剪輯、令人印象深刻的影片,內容呈現類人型機器人摺疊衣物、分類物品或沖泡咖啡等場景,這讓人誤以為通用型機器人的操作技術已瀕臨廣泛商業部署的階段。 投資者與大眾皆被這些展示深深吸引,紛紛將資金投入那些承諾「通用人工智慧」即將以實體形式問世的初創企業。然而,若仔細檢視其背後的評估方法,便會發現測試環境既零散,且往往過於寬容。剝去行銷包裝後的現實是:當前模型距離可靠、可泛化及可部署的標準仍相去甚遠。 一項嶄新且嚴謹的測試標準的推出,剛才精確量化了我們還有多遠的路要走,而這些數字對整個產業而言,無疑是一記刺耳的警鐘。
何謂 RoboDojo 基準測試?
RoboDojo 是一套統一的模擬與真實世界基準測試,旨在全面評估通用型機器人操作策略。該基準於 2026 年 7 月發布,透過三種不同的機器人實體,針對 42 項模擬任務和 18 項真實世界任務對模型進行測試,提供了一個標準化的框架,用以精確衡量具身人工智慧的進展。
發布的核心要點
2026年7月初,由全球頂尖大學研究人員組成的龐大聯盟向機器人學界推出了 RoboDojo。 相關的基礎研究論文於 2026 年 7 月 5 日提交至 arXiv,並在 2026 年 7 月 8 日發布詳細報告後,該專案獲得了業界更廣泛的關注。此基準測試整合並評估了 30 種具代表性的機器人操作策略,對當前的最先進技術現狀進行了廣泛評估。 經測試的模型包括 Hy-Embodied-0.5-VLA、Spatial Forcing、Pi_05、X-VLA、X-WAM、Xiaomi-Robotics-0、StarVLA、GigaWorld-Policy 等知名模型,
GalaxeaVLA 以及 LingBot-VLA。這些評估的主要結果令人警醒,並直接挑戰了業界普遍存在的樂觀論調。在模擬環境中,表現最佳的模型 Hy-Embodied-0.5-VLA 平均成功率僅有 8.80%。 在真實世界測試階段,有單一來源的報告聲稱表現最佳的模型 π0.5 達到了 12.8% 的成功率。 為了讓這些數字更有參考價值,同一份報告指出,人類專家在真實世界中能達到 100% 的成功率,而在模擬環境中則為 76.03%。這些 AI 模型僅有個位數或低雙位數的成功率,凸顯了當前能力與生產就緒型通用機器人所需標準之間存在巨大差距。
具身人工智慧的「進步」幻象
機器人領域長期以來一直面臨著評估標準的問題。人工智慧的進展通常由嚴謹且標準化的基準測試所驅動。在自然語言處理領域,MMLU 或 HumanEval 等基準測試提供了明確的目標,從而推動了快速的迭代與改進。然而,在機器人領域,評估歷來存在孤島化、不一致且容易過度擬合的問題。
許多研究團隊和企業依賴專有測試環境或僅評估狹窄功能範圍的基準測試。常見的做法是僅在模擬環境中測試模型,因為在模擬中可以簡化物理法則並排除意外變數。 另一方面,真實環境測試往往在高度受限的實驗室條件下進行,物體被放置在精確的起始位置,光線也經過仔細控制。當機器人在這些特定且經過排練的場景中成功運作時,人們很容易將這種成功推論為其具備通用能力。
這種支離破碎的做法營造出快速進步的假象。倘若每家公司都使用自己的尺子來衡量成功,那麼每個人都能聲稱自己在競賽中勝出。RoboDojo 顛覆了這種局面
透過引入一套統一的「模擬與實體」基準測試,用以評估適用於廣泛任務與機體的通用機器人操作策略,從而闡明此一動態。透過迫使模型在模擬與實體環境中,以及不同類型的機器人硬體上皆須展現表現,RoboDojo 剝離了過擬合所帶來的優勢,並揭示當前技術的真實基準。剖析評估維度
要理解成功率為何如此之低,必須檢視 RoboDojo 評估的具體維度。該模擬基準測試旨在檢驗機器人操作的五個關鍵領域,每個領域皆代表實際部署的基本要求。
首先,「泛化能力」用以測試模型處理訓練期間未曾接觸過的新穎物體、環境及任務的能力。 真正的通用型機器人必須能夠在從未見過的廚房中運作,並操作形狀和大小各異的廚具。RoboDojo 中的低分顯示,當模型超出其訓練分佈範圍時,現行模型會面臨顯著的困難。
其次,「記憶」評估機器人能否隨時間推移保留資訊,並運用這些資訊來指導未來的行動。例如,若機器人打開抽屜尋找工具,當日後再次需要該工具時,它應能記住抽屜是打開的,以及工具所在的位置。當前的策略往往缺乏執行複雜、多步驟任務所需的持久記憶能力。
第三,精準度對於需要精細動作技能的任務至關重要,例如將木釘插入孔中,或抓取易碎物體而不使其損毀。雖然大型視覺-語言-動作模型擅長理解高階指令,但將這些指令轉化為毫米級精準的物理動作,仍是一項極大的挑戰。
第四,長期執行能力考驗機器人能否在較長期間內,完成需要一連串相互依存動作的任務。
沖泡一杯咖啡的過程包括:找出一個馬克杯、將其放在咖啡機下方、放入咖啡膠囊,然後按下按鈕。如果模型在任何一個步驟中失敗,整個任務就會失敗。在長期觀察中,錯誤的累積機率是整體成功率偏低的主要原因。最後,開放詞彙指令測試旨在評估機器人能否理解並執行以自然、非結構化語言表達的指令。 機器人不能僅依賴預先編程的指令,而必須從多樣化的表述中解讀使用者的意圖。儘管大型語言模型已提升了這項能力,但如何將這種語言理解轉化為具體的物理動作,仍是尚未解決的問題。
對量產時程的現實檢驗
RoboDojo 基準測試的啟示遠不止於學術好奇;它們直接影響具身人工智慧的商業化時程。過去兩年來,業界普遍認為,將大型語言模型與機器人控制系統整合,將能迅速解決操作問題,進而促使通用機器人即將在家庭和工廠中部署。
RoboDojo 的數據對此時間表提供了必要的修正。 模擬環境中 8.80% 的成功率,以及實境環境中據報 12.8% 的成功率,皆顯示當前模型仍處於基礎研究的初期階段,而非產品化的最後階段。基準測試結果表明,當前模型距離實現可靠、可泛化且可部署的通用機器人操作能力,仍有相當大的差距。
這意味著,具備量產條件的通用型機器人仍有一段相當長的距離。那些承諾在未來一兩年內推出供消費者使用的自主通用型類人機器人的公司,很可能低估了尚待克服的技術障礙。通往商業化的道路,將需要在模型架構、資料蒐集以及物理層面取得根本性的突破。
應著重於建立新的推理框架,而非僅是將現有方法擴大應用。評估框架的標準化
在 RoboDojo 問世之前,業界依賴著一組零散的基準測試,每項基準都有其優點與局限。理解這項現狀對於體認這項新統一標準的貢獻至關重要。
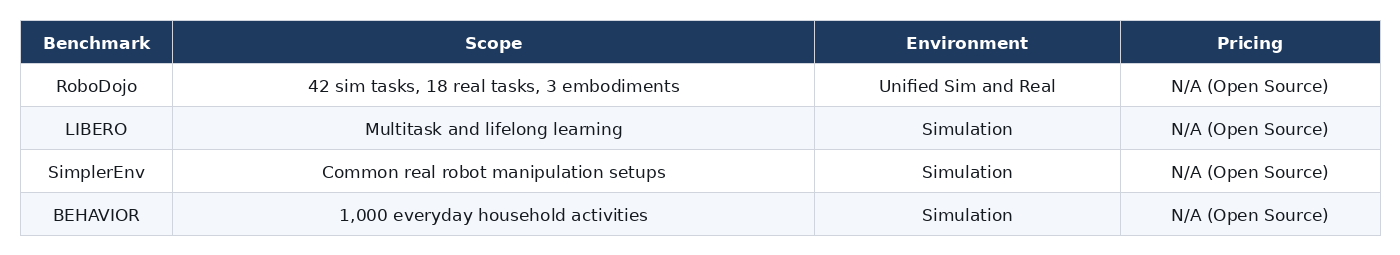
現有的基準測試在系統性地評估通才型機器人操作策略方面往往有所局限。它們通常依賴簡單的任務,且通常僅在模擬環境中進行,或僅在真實世界中進行。 舉例來說,LIBERO 是一套廣受推崇的基準測試,專門用於研究多任務與終身機器人學習問題中的知識轉移。儘管其特定研究重點極具價值,但該基準測試完全在模擬環境中運作。
同樣地,SimplerEnv 提供了一套針對常見真實機器人操作配置的開源模擬評估環境。它在讓研究人員能在標準化的虛擬環境中測試策略方面發揮了關鍵作用,但並未彌合與實體硬體之間的鴻溝。 BEHAVIOR 是另一個針對以人為中心的機器人學所設計的綜合性模擬基準,包含 1,000 項日常家居活動。其規模雖令人印象深刻,但同樣僅侷限於虛擬世界。
RoboDojo 的主要創新之處在於其統一的方法論。透過在 3 種機器人實體上提供 42 項模擬任務和 18 項真實世界任務,它迫使模型必須在兩個領域中皆證明其能力。 這項雙重要求至關重要,因為模擬中的成功極少能直接轉化為現實世界中的成功,此現象被稱為「模擬與現實的鴻溝」。透過同時衡量這兩者,RoboDojo 能更精準地呈現模型的真實實用性。
基準測試現況比較
 策略性採購與
部署考量對於正在評估機器人操作平台的工程主管、採購人員及風險投資者而言,RoboDojo 的測試結果是進行關鍵現實檢驗的重要依據。當供應商展示高成功率或無瑕疵的示範影片時,務必釐清這些指標究竟是在孤立且過度擬合的環境中達成,還是經由 RoboDojo 這類嚴謹且統一的基準測試所驗證。 在通用模擬任務中僅有個位數的成功率,表明當前的視覺-語言-動作模型若要在生產環境中可靠運作,仍需進行大量客製化工程、受限環境,以及廣泛的現場特定訓練。
各組織應據此調整部署時程與預算。過早依賴開箱即用的通用能力不僅為時過早,更伴隨著顯著的營運風險。相反地,策略性投資應聚焦於能提供穩健資料收集、高效微調管道,以及處理邊緣案例明確途徑的平台。 承認通往自主、開放詞彙操作的道路將是反覆迭代的,且需要持續進行大量驗證,這對於建立可持續的機器人計畫至關重要。
專家對該基準測試的觀點
「RoboDojo 的推出迫使業界正視通用操作能力的實際現狀,剝去精心策劃的示範所披上的光鮮外衣,揭露了定義當前技術前沿的原始、僅有個位數的成功率,」一位機器人產業分析師指出。 這種程度的透明度,正是該產業所需,以擺脫炒作週期,專注於解決實體互動中那些艱難且不引人注目的問題。
RoboDojo 背後的協作力量
要建立像 RoboDojo 這樣全面的基準測試,所需的資源與專業知識已超出大多數單一研究實驗室的能力範圍。因此,這項計畫是一項大規模的合作計畫
來自全球頂尖學術機構的研究人員之中。該團隊的組成體現了全球性的合作,成員包括來自香港大學 MMLab、加州大學伯克利分校、清華大學、北京大學、史丹福大學、麻省理工學院、北卡羅來納大學教堂山分校、普林斯頓大學、卡內基梅隆大學、新加坡國立大學、南洋理工大學、香港中文大學、 倫敦帝國學院、上海交通大學、西北大學、香港科技大學(廣州)、浙江大學及耶魯大學。
推動此計畫的核心成員包括香港大學 MMLab 的陳天星與北京大學的陳悅,以及李子軒、唐俊元、蘇凱倫、盧浩然、萬偉傑、陳百軍和劉松玲。 該團隊為本專案帶來豐富的先期經驗,此前曾開發「RoboTwin」系列基準測試。其早期成果「RoboTwin 2.0」作為雙手機器人操作領域中數據生成與基準測試的可擴展框架,為「RoboDojo」所實現的更廣泛「模擬與實機結合」方法奠定了基礎。
此次合作規模之大,正凸顯了該問題的艱鉅性。從搭建實體設備、設計模擬環境、整合 30 種不同的操作策略,到執行評估,皆需要龐大的協調努力。此次竟需動員 18 所頂尖大學共同建構此基準測試,正說明了為何單一企業難以獨力建立客觀的評估標準。
隨著機器人產業持續朝通用型機器人邁進,像 RoboDojo 這樣的基準測試將成為衡量進展的真正指標。 它們提供了標準化、可重現且全面的評估框架,這是準確衡量進展並辨識現行模型缺點所不可或缺的。除非在這些嚴苛測試中的成功率能突破個位數,否則「可部署的通用型機器人」這個夢想
仍堅定地屬於未來。來源
1. RoboDojo 基準測試專案頁面:https://robodojo-benchmark.com/
2. RoboDojo 論文(arXiv 2607.04434):https://arxiv.org/abs/2607.04434
3. RoboDojo GitHub 儲存庫:https://github.com/robodojo-benchmark/RoboDojo
4. 36Kr 對基準測試結果的分析(中文):https://36kr.com/p/3886887316500745
5. RoboTwin 專案頁面:https://robotwin-platform.github.io/
6. LIBERO 基準測試專案頁面:https://libero-project.github.io/main.html
7. SimplerEnv 專案頁面:https://simpler-env.github.io/
8. 史丹佛大學 BEHAVIOR 基準測試:https://behavior.stanford.edu/index.html











