
通用机器人的现实检验:RoboDojo 基准测试揭示了关于具身人工智能的哪些信息
新发布的RoboDojo基准测试揭示了当前通用机器人操作模型的严峻现实,其成功率仅为个位数,这给行业在规定时限内实现可投入生产的具身人工智能带来了挑战。
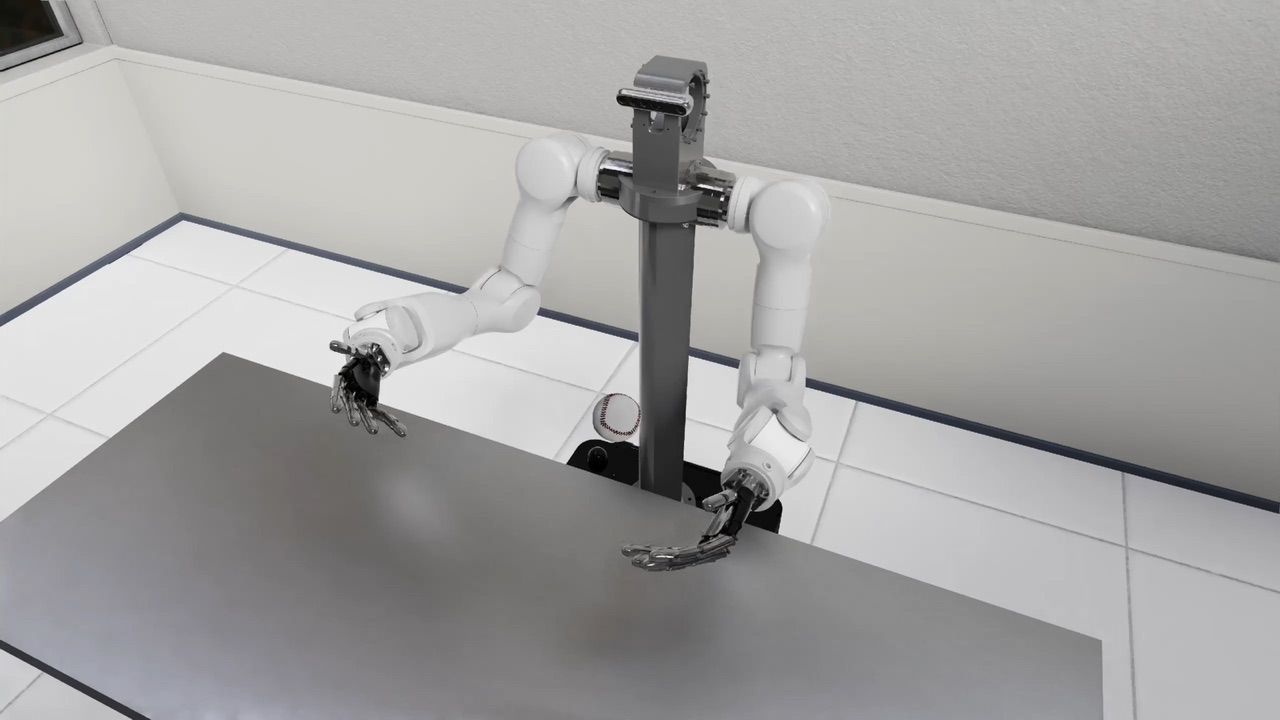
多年来,机器人行业一直沉浸在一种令人舒适且极具视觉冲击力的错觉之中。各家公司惯常展示经过大量后期处理的、令人印象深刻的视频,其中类人机器人正在叠衣服、分类物品或冲泡咖啡,这让人觉得通用机器人操作技术即将实现大规模商业应用。 投资者和公众都被这些演示所吸引,纷纷向那些承诺“通用人工智能即将以实体形式问世”的初创企业注入资金。然而,仔细审视其背后的评估方法,就会发现测试环境支离破碎,且往往标准宽松。抛开营销的华丽包装,现实情况是:当前的模型在可靠性、泛化能力和可部署性方面仍相去甚远。 一项新的、严格的测试标准的推出,恰恰量化了我们还有多远的路要走,而这些数据对整个行业来说是一个严峻的警钟。
什么是 RoboDojo 基准测试?
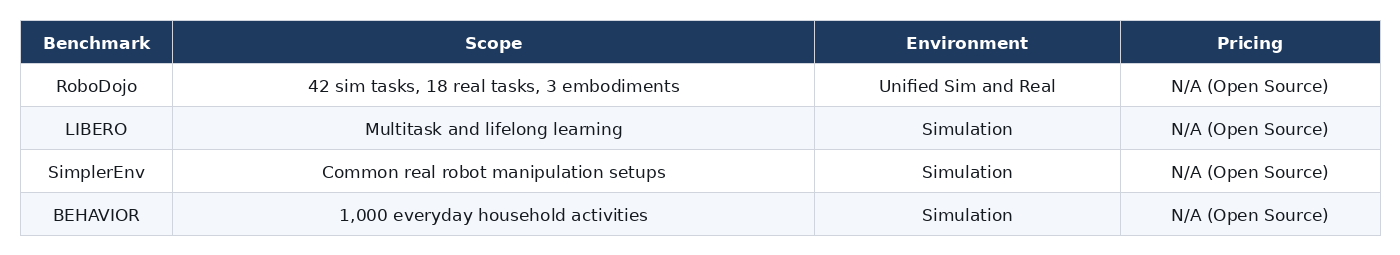
RoboDojo 是一套统一的模拟与真实世界基准测试体系,旨在对通用机器人操作策略进行全面评估。该基准于 2026 年 7 月发布,利用三种不同的机器人实体,针对 42 项模拟任务和 18 项真实世界任务对模型进行测试,为准确衡量具身人工智能的进展提供了标准化框架。
发布的核心要点
2026年7月初,由全球顶尖大学研究人员组成的大型联盟向机器人学界推出了RoboDojo。 相关的基础研究论文于2026年7月5日提交至arXiv,随着2026年7月8日一份详细报告的发布,该项目获得了更广泛的行业关注。该基准测试整合并评估了30种具有代表性的机器人操作策略,对当前的技术前沿状况进行了全面评估。 经过测试的模型包括Hy-Embodied-0.5-VLA、Spatial Forcing、Pi_05、X-VLA、X-WAM、Xiaomi-Robotics-0、StarVLA、GigaWorld-Policy等知名模型,
GalaxeaVLA 和 LingBot-VLA。这些评估的主要结果发人深省,并直接挑战了业内盛行的乐观论调。在模拟环境中,表现最佳的模型 Hy-Embodied-0.5-VLA 平均成功率仅为 8.80%。 在真实世界测试阶段,有单方报告称表现最佳的模型 π0.5 达到了 12.8% 的成功率。 为了更好地理解这些数据,同一份报告指出,人类专家在现实世界中的成功率为100%,在模拟环境中的成功率为76.03%。AI模型这些个位数和低两位数的成功率,凸显了当前能力与投入生产的一般用途机器人要求之间存在的巨大差距。
具身人工智能中的“进步”幻象
机器人领域长期以来一直面临着一个评估难题。人工智能领域的进步通常由严格、标准化的基准测试推动。在自然语言处理领域,MMLU 或 HumanEval 等基准测试提供了明确的目标,从而推动了快速的迭代和改进。然而,在机器人领域,评估历来存在孤立、不一致且容易过拟合的问题。
许多研究团队和企业依赖于专有测试环境或仅评估狭窄能力范围的基准测试。一种常见做法是仅在模拟环境中测试模型,在那里可以简化物理规律并消除意外变量。 另一方面,现实世界测试往往在高度受限的实验室环境中进行,物体被放置在精确的起始位置,光照条件也经过精心控制。当机器人在这些特定且经过排练的场景中取得成功时,人们很容易将这种成功外推为通用能力。
这种支离破碎的方法营造出一种快速进步的假象。如果每家公司都用自己的标尺来衡量成功,那么每个人都可以声称自己正在赢得这场竞赛。RoboDojo 正在颠覆这一局面
通过引入一个统一的模拟与真实环境基准测试,该测试可在广泛的任务和机器人形态下评估通用机器人操作策略,从而揭示这一动态。通过迫使模型在模拟和物理环境中,以及不同类型的机器人硬件上均能表现出色,RoboDojo 消除了过拟合带来的优势,并揭示了当前技术的真实基准水平。剖析评估维度
要理解成功率为何如此之低,必须考察 RoboDojo 评估的具体维度。该仿真基准旨在测试机器人操作的五个关键领域,每个领域都代表了实际部署的基本要求。
首先,泛化能力测试的是模型处理训练期间未曾接触过的新颖物体、环境和任务的能力。 真正的通用型机器人必须能够在从未见过的厨房中操作,并处理形状和大小各异的厨具。RoboDojo中较低的得分表明,当模型超出其训练分布范围时,当前模型会面临显著的困难。
其次,记忆能力评估机器人能否随时间推移保留信息,并利用这些信息指导后续行动。例如,如果机器人打开抽屉寻找工具,当它日后再次需要该工具时,应记得抽屉是打开的以及工具的位置。当前的策略往往缺乏执行复杂多步骤任务所需的持久记忆能力。
第三,精度对于需要精细运动技能的任务至关重要,例如将插销插入孔中,或抓取易碎物体而不将其压碎。尽管大型视觉-语言-动作模型擅长理解高级指令,但将这些指令转化为毫米级精度的物理动作仍然是一项巨大的挑战。
第四,长期执行能力考验着机器人完成那些需要在较长时间内执行一系列相互依赖动作的任务的能力。
冲泡一杯咖啡需要找到一个马克杯,将其放在咖啡机下方,放入咖啡胶囊,然后按下按钮。如果模型在任何一个步骤上出现失误,整个任务就会失败。在较长的时间范围内,错误的累积概率是导致总体成功率较低的主要原因。最后,开放词汇指令测试旨在评估机器人能否理解并执行以自然、无结构语言表达的指令。 机器人不能依赖预先编程的指令,而必须从各种不同的表述中解读用户的意图。尽管大型语言模型已提升了这一能力,但如何将这种语言理解转化为具体的物理动作,仍然是一个未解决的问题。
对量产时间表的现实检验
RoboDojo基准测试的意义远不止于学术好奇;它直接影响着具身人工智能的商业化时间表。过去两年间,业界普遍认为,将大型语言模型与机器人控制系统集成将迅速解决操作问题,从而推动通用机器人在家庭和工厂中的即刻部署。
RoboDojo的数据对此时间表做出了必要的修正。 模拟环境中的8.80%成功率以及现实世界中报告的12.8%成功率表明,当前模型仍处于基础研究的早期阶段,而非产品化的最后阶段。基准测试结果显示,当前模型距离实现可靠、可泛化且可部署的通用机器人操作仍相去甚远。
这意味着,具备量产条件的通用机器人仍遥遥无期。那些承诺在未来一两年内推出面向消费者的自主通用类人机器人的公司,很可能低估了尚待克服的技术障碍。通往商业化的道路需要在模型架构、数据采集和物理层面实现根本性的突破。
推理,而不是仅仅扩大现有方法的规模。评估框架的标准化
在 RoboDojo 出现之前,业界依赖的是一系列各不相同的基准测试,每种基准都有其自身的优势和局限性。了解这一现状对于理解这一新统一标准的贡献至关重要。
现有的基准测试在系统性评估通用机器人操作策略方面往往存在局限。它们通常依赖于简单的任务,且通常仅在模拟环境中或仅在真实世界中进行。 例如,LIBERO 是一个广受好评的基准,专门用于研究多任务和终身机器人学习问题中的知识迁移。尽管其特定研究方向极具价值,但该基准完全在模拟环境中运行。
同样,SimplerEnv 为常见的真实机器人操作设置提供了一套开源的模拟评估环境。它在帮助研究人员在标准化的虚拟环境中测试策略方面发挥了重要作用,但未能弥合与物理硬件之间的鸿沟。 BEHAVIOR是另一个面向以人为中心的机器人学的综合仿真基准,包含1,000项日常家务活动。其规模虽令人印象深刻,但同样仅局限于虚拟世界。
RoboDojo 的主要创新在于其统一的方法论。通过在 3 种机器人形态下提供 42 项模拟任务和 18 项真实世界任务,它迫使模型在两个领域都证明其能力。 这一双重要求至关重要,因为模拟中的成功极少能直接转化为现实世界中的成功——这一现象被称为“模拟到现实的鸿沟”。通过同时衡量这两方面,RoboDojo 能够更准确地反映模型的实际效用。
基准测试格局对比
 战略采购与
部署注意事项对于正在评估机器人操作平台的工程负责人、采购主管和风险投资家而言,RoboDojo的测试结果提供了一次至关重要的现实检验。当供应商展示出高成功率或毫无瑕疵的演示视频时,必须追问这些指标是在孤立的、过度拟合的环境中实现的,还是通过了像RoboDojo这样严格且统一的基准测试。 在通用模拟任务中仅个位数的成功率表明,当前的视觉-语言-动作模型若要在生产环境中可靠运行,仍需大量定制化工程设计、受限环境以及广泛的现场特定训练。
各组织应据此调整部署时间表和预算。依赖开箱即用的通用能力为时过早,且存在重大运营风险。相反,战略投资应侧重于那些能够提供稳健的数据采集、高效的微调管道以及处理边界情况的明确路径的平台。 认识到通往自主、开放词汇操作的道路将是一个迭代过程,且需要持续的大量验证,这对构建可持续的机器人项目至关重要。
专家对该基准测试的见解
“RoboDojo的推出迫使整个行业正视通用操作的实际状况,剥去了精心策划的演示所呈现的光鲜外表,揭示了当前技术前沿所特有的、仅为个位数的原始成功率,”一位机器人行业分析师指出。 这种透明度正是该行业所需要的,它能帮助行业走出炒作周期,专注于解决物理交互中那些艰难且不显眼的问题。
RoboDojo背后的协作力量
创建像RoboDojo这样全面的基准测试,所需的资源和专业知识超出了大多数单个研究实验室的能力范围。因此,该项目是一次大规模的合作
来自全球顶尖学术机构的研究人员。该团队的构成体现了全球性的合作,成员包括来自香港大学MMLab、加州大学伯克利分校、清华大学、北京大学、斯坦福大学、麻省理工学院、北卡罗来纳大学教堂山分校、普林斯顿大学、卡内基梅隆大学、新加坡国立大学、南洋理工大学、香港中文大学、 伦敦帝国理工学院、上海交通大学、西北大学、香港科技大学(广州)、浙江大学和耶鲁大学的研究人员。
推动该计划的核心人员包括香港大学MMLab的陈天星和北京大学的陈悦,以及李子轩、唐俊元、苏凯伦、卢浩然、万伟杰、陈百军和刘松玲。 该团队为该项目带来了丰富的先期经验,此前曾开发了RoboTwin系列基准测试。他们早期的成果RoboTwin 2.0为双臂机器人操作中的数据生成和基准测试提供了一个可扩展的框架,为RoboDojo中实现的更广泛的“模拟与实机”方法奠定了基础。
此次合作的规模凸显了该问题的难度。搭建物理实验装置、设计仿真环境、集成30种不同的操作策略以及运行评估,都需要进行巨大的协调工作。需要18所顶尖大学共同参与才能构建这一基准测试,这一事实恰恰说明了为何单个公司难以独自制定客观的评估标准。
随着机器人行业持续向通用机器人迈进,RoboDojo 这样的基准测试将成为衡量进步的真正标尺。 它们提供了标准化、可重复且全面的评估框架,这是准确衡量技术进步并识别当前模型缺陷所必需的。除非这些严格测试的成功率能突破个位数,否则可部署的通用机器人这一梦想
依然坚定地属于未来。来源
1. RoboDojo 基准测试项目页面:https://robodojo-benchmark.com/
2. RoboDojo 论文(arXiv 2607.04434):https://arxiv.org/abs/2607.04434
3. RoboDojo GitHub 代码库:https://github.com/robodojo-benchmark/RoboDojo
4. 36Kr对基准测试结果的分析(中文):https://36kr.com/p/3886887316500745
5. RoboTwin 项目页面:https://robotwin-platform.github.io/
6. LIBERO 基准测试项目页面:https://libero-project.github.io/main.html
7. SimplerEnv 项目页面:https://simpler-env.github.io/
8. 斯坦福BEHAVIOR基准测试:https://behavior.stanford.edu/index.html











