
機器人能「看見」。這家位於上海的實驗室剛發布了長達 30,000 小時的「教導機器人感知」影片
上海新創公司 NeoteAI(新智具身智能)與復旦大學可信具身人工智慧研究所於 7 月 26 日發布了三份技術報告,這些報告基於他們所稱的超過 30,000 小時的視覺-觸覺互動數據, 涵蓋450項真實長時程任務中約140萬段操作影片。該技術架構包含一套觸覺資料集(NeoData)、一個統一的觸覺表徵模型(NeoForce)、 一個預測性視覺-觸覺-語言-動作模型(VTLA)——該模型在高接觸頻率的任務中成功率達85%至99%——以及一個觸覺世界模型(TWAM),相關數據與模型均承諾以開源形式釋出。 這是迄今為止最激進的公開主張,即觸覺(而非視覺)才是機器人學習的下一個擴展前沿。
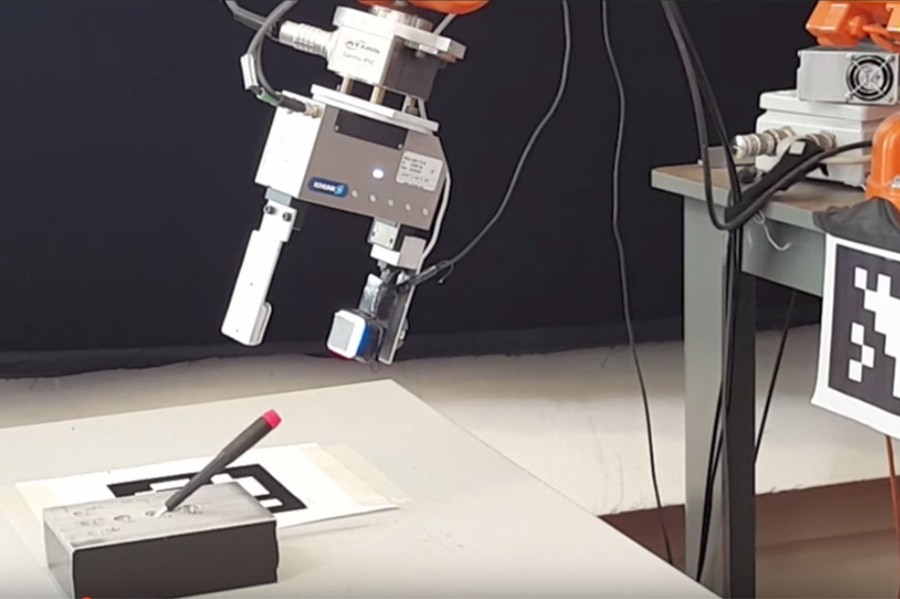
試著讓機器人摺一件襯衫,或將連接器插入插座,你就會發現電腦視覺在過去十年中始終未能解決的問題:關鍵的瞬間發生在相機無法捕捉的範圍內——也就是手指與物體的接觸面,而成功與否取決於力道、滑動與表面質感。 7月26日,一家上海新創公司與中國頂尖大學之一共同發表了針對這個「盲點」的解決方案,而其規模之大正是這則新聞的重點。
新智具身智能科技(英文名:NeoteAI)與復旦大學可信具身人工智慧研究所聯合發布了三份技術報告,這些報告基於合作夥伴稱為「NeoData」的數據集: 超過 30,000 小時的同步視覺-觸覺互動影片,約 140 萬個操作片段,涵蓋從摺疊衣物到插拔連接器等 450 項真實世界中的長時程任務。相關報導指出,此次發布包含數十億幀對齊的 RGB 與觸覺幀。 合作夥伴表示,無論是數據集本身,還是基於該數據集訓練的模型,都將以開源形式釋出。
就校準而言,那些引爆生成式 AI 熱潮的視覺-語言資料集,是從現有的網際網路中彙整而來。觸覺資料卻沒有網際網路可供抓取。每一小時的資料都必須透過配備感測器的機器人及手持式收集裝置,實際接觸物體來產生,這也是為何大多數學術界的觸覺資料集規模頂多只有數十或數百小時。 若 NeoData 的規模經得起檢驗,它將躋身有史以來規模最大的觸覺數據集之列;而這套數據集源自一家成立僅一年的中國新創公司,而非矽谷實驗室,這一點本身便是「具身人工智慧」競賽中的關鍵數據點。
為何觸覺能擊敗十年來的機器人學習
稍作岔題即可說明為何這份語料庫值得探討。現代機器人的行為策略,主要都是透過相機進行訓練的
視角與關節位置,這些資訊對於執行抓取及粗略的拾放動作已足夠。然而,涉及大量接觸的任務會因三項相互疊加的原因而打破這套公式。首先是遮擋:在接觸的瞬間,機器人自身的手指會從所有相機角度遮蔽互動畫面。 其次,動力學:作用力在毫秒內變化,速度比視覺處理管線處理幀的速度還快;因此,當攝影機察覺物體正在滑脫時,在接觸時間的尺度上,失敗已發生數秒之久。第三,不可見性:決定成功與否的特性——摩擦力、順應性、纜線張力——在任何影像中都無法呈現。 人類的雙手憑藉約 17,000 個機械感受器,以及在腦部尚未介入前便能修正抓握力的脊髓反射迴路,便能解決這三項問題。機器人既無相應的機制,也從未存在過足以大規模學習此能力的數據集。這正是 NeoData 聲稱要填補的空白。三個模型與一個論點
本次發布整合了三條技術路徑,共同構成一個核心論點:觸覺應被視為一種擁有自身尺度定律的一等感官模式,而非視覺的附屬裝飾。
首份報告《NeoForce》著手解決多年來導致觸覺研究支離破碎的問題:每個感測器使用的「語言」各不相同。來自不同觸覺硬體的讀數無法互通,因此無法整合資料集。 NeoForce 提出了一種具備時間結構且可跨裝置轉移的統一觸覺表示法,實質上是一種共通的嵌入空間,不同感測器的訊號皆可投射至其中。若能如描述般運作,它將以與共享分詞器促進文本語料庫整合相同的方式,解決該領域的資料融合瓶頸。
第二份報告《VTLA》則增添了預判能力。傳統方法僅能處理當下的觸覺讀數,這會落後於物理現象:當滑動被感測到時,物體其實已經開始移動。VTLA 模型
預測觸控操作未來最多 50 步的發展趨勢,並根據該預測來決定後續動作。 在兩項接觸頻繁的基準測試中,插頭插入成功率達 85%,按鍵拔出成功率達 99%——這類看似不起眼卻極需高精度的任務,往往是僅憑視覺的策略慣常失敗之處,而這些數據也將是競爭對手實驗室最先試圖複製的目標。第三份報告 TWAM 則是一種觸覺世界模型,該系統能在機器人執行動作前,透過在想像中預演操作,同時推演視覺與觸覺的後果,其模擬成功率平均達 84.5%。 世界模型是當前具身人工智慧領域的前沿,從 Nvidia 的 Cosmos 到 Google DeepMind 的 Genie 系列皆然,但其中幾乎所有模型都僅能預測像素。 能同時預測觸覺的反饋的世界模型實屬罕見;若其模擬演練的成效能以接近報告中所述的比率轉化至實體硬體,將能大幅縮短機器人訓練中最昂貴的環節:即在真實物體上、伴隨實際損壞、且需即時處理的失敗過程。
資料庫背後的公司
NeoteAI 是一家年輕、規模小且刻意採取全棧模式的新創公司。該公司由復旦大學可信具身人工智慧研究所孵化, 這家上海公司於五月底宣布完成接近人民幣1億元(約合1,400萬美元)的天使輪融資,其戰略涵蓋自主研發的視覺觸覺感測器(基於復旦大學研究員陳文明團隊的研究成果),並橫跨資料收集至觸覺基礎模型的開發。 其資料蒐集管道採用雙軌並行模式,分別是真實機器人以及由人類操作的手持式通用操作介面裝置;正因如此,這家新創公司無需擁有整座機械手臂倉庫,便能累積 30,000 小時的運作數據。
這種全棧佈局在戰略上至關重要。在美國的生態系統中,觸覺感測仍主要
這是一項零組件業務,相關企業將感測器銷售給其他公司的機器人。NeoteAI 認為,無論誰掌握感測器、資料格式與模型,誰就能共同制定機器「感知」方式的標準——這正是 Nvidia 在模擬領域所佔據的地位。 這項開源承諾應從這個角度來解讀:釋出數據和模型,能將你的格式與基準植入生態系統,從而讓該領域的工具鏈圍繞你的硬體發展起來。 這正是 Unitree 在低成本硬體領域採取的策略,而 Ecovacs 也在本週末透過其開源家用機器人平台(今日另文報導)實施同樣的策略。與復旦大學的連結,也傳遞出中國具身人工智慧領域正日益深化的訊號。 「可信體化人工智慧研究院」是上海為將學術機器人技術轉化為企業而設立的一系列大學附屬研究院之一,而 NeoteAI 的發展軌跡——從實驗室感測器到天使輪融資,再到十四個月內發布備受矚目的資料集——正是這套模式按設計順利運作的範例。 同一個週末,整個生態系統中也出現了平行佐證:滙理機器人(Ecovacs)在蘇州開源其家用機器人平台,以及名人資金湧入具身人工智慧新創企業,這兩則消息今日亦有單獨報導。單一週末內,如此密集的獨立參與者採取具說服力的行動,本身就是中國具身人工智慧生態系統已發展到何種程度的明證。
持懷疑態度的檢視清單很明確:這些報告屬自行發布且尚未經過同儕審查;那些引人注目的成功率源自作者自行選定的任務;而在世界模型中模擬的成功,並不等同於生產線上的實際部署成功。 這 3 萬小時數據的具體組成——其中人類手動蒐集與機器人實測各佔多少比例,以及有多少數據通過了嚴格的對齊品質檢查——將決定這份數據集究竟是油田還是垃圾場。而新創公司對開源的承諾,終究取決於它們自身的進度,而非
這屬於社群的;在下載連結上線之前,承諾僅是行銷手段。值得記住的先例正是「視覺語言機器人技術」本身,該領域中,資料集的公告有時會比可實際運用的版本提前數個季度發布。為何觸覺正成為下一場數據競逐
將此事提升至超越單一新創公司技術報告層級的背景,是本刊本月持續追蹤的一種趨勢。 具身人工智慧中的稀缺資源,正從運算能力和資本轉移到「具身數據」——這類數據無法透過爬取獲取,因為它必須透過實體方式產生。韓國科學技術院(KAIST)與英偉達(Nvidia)於7月26日宣布成立一個研究中心,旨在基於臨床級人類動作數據構建基礎模型,本刊今日另文報導了此事。 中國國家數據局一直在建立具身數據基礎設施,而從北京到深圳的各級培訓基地,正是為了大規模製造機器人的體驗而存在。觸覺是合乎邏輯的下一個戰場:這是人類靈巧度最超越機器人能力的感知模式,也是全球現有數據最匱乏的領域。
此外,對於硬體採購商而言,這還涉及一個值得關注的供應鏈影響。如果觸覺模型能基於中國感測器和中國數據格式成熟發展,觸覺感測可能會重現機器人關節的發展軌跡——當時,中國的「四合一」致動器模組已成為全球事實上的標準參考。 西方與日本的感測器供應商及靈巧機械手製造商——該領域包含在力矩感測方面實力雄厚的既有廠商——應將 NeoForce 這樣的統一表示法視為標準化戰略,而非僅是紙上談兵。
對於正在評估是否參與的機器人團隊而言,實際的操作步驟相當明確。請密切關注承諾中的資料庫何時會在常用主機上上線;一旦上線,請優先測試 NeoForce 的可移植性主張,因為一種真正能串聯感測器的表示法
這類模型將立即為任何擁有自身小型觸覺資料集的實驗室帶來益處。在引用 VTLA 的插頭插入與鑰匙抽出數據之前,請先在獨立硬體上進行基準測試。 此外,請將 NeoData 的授權條款視為戰略資訊:是否允許商業使用,以及採用何種署名機制,將揭示 NeoteAI 究竟是在建立共享資源,還是為其感測器打造一條引流管道。值得引述的總結是:機器人從網路上學會了「看見」,但尚無「觸覺網」,因此必須有人一小時一小時地親手建構,而一家由復旦大學孵化的新創公司,剛宣稱已取得迄今為止公開的最大領先優勢。 NeoData 究竟是具身人工智慧的「ImageNet 時刻」,還是被誇大的數據集,將由實驗重現來決定,而非媒體報導。無論如何,這場教導機器感知的能力競賽如今已確立了基準,而這項基準長達三萬小時。
免責聲明:本文僅供一般資訊參考,並不構成投資、法律或採購建議。讀者應在做出商業決策前,向原始來源核實相關細節。












