
Roboter können sehen. Dieses Labor in Shanghai hat gerade 30.000 Stunden an Trainingsdaten veröffentlicht, mit denen man ihnen das Fühlen beibringt.
Das Start-up NeoteAI (Xinzhi Embodied Intelligence) aus Shanghai und das Institut für vertrauenswürdige verkörperte KI der Fudan-Universität veröffentlichten am 26. Juli drei technische Berichte, die auf – wie sie selbst angeben – mehr als 30.000 Stunden an Daten zu visuell-taktilen Interaktionen basieren, etwa 1,4 Millionen Manipulationsclips aus 450 realen Aufgaben mit langem Zeithorizont. Das System umfasst einen taktilen Datensatz (NeoData), ein einheitliches taktiles Repräsentationsmodell (NeoForce), ein vorausschauendes visuell-taktil-sprachlich-handlungsbezogenes Modell (VTLA), das bei kontaktintensiven Aufgaben eine Erfolgsquote von 85 bis 99 Prozent aufweist, sowie ein taktiles Weltmodell (TWAM), wobei Daten und Modelle als Open Source zur Verfügung gestellt werden sollen. Dies ist die bislang deutlichste öffentliche Behauptung, dass der Tastsinn – und nicht das Sehen – die nächste große Herausforderung beim Lernen von Robotern darstellt.
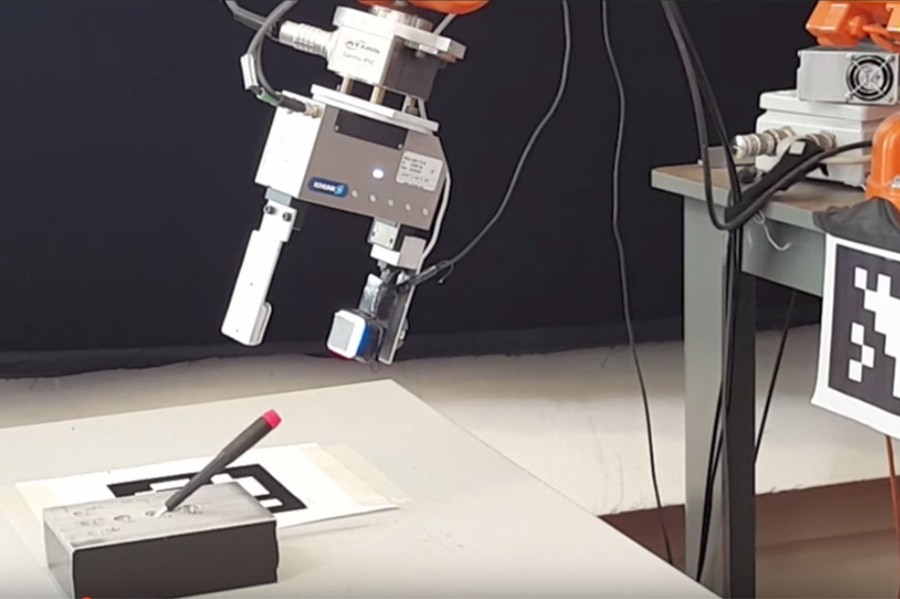
Bitten Sie einen Roboter, ein Hemd zu falten oder einen Stecker in eine Buchse zu stecken, und Sie werden feststellen, was die Computer-Vision im letzten Jahrzehnt nie gelöst hat: Der entscheidende Moment findet dort statt, wo die Kamera nicht hinsehen kann – an der Schnittstelle zwischen Finger und Objekt, wo der Erfolg von Kraft, Rutschverhalten und Oberflächenstruktur abhängt. Am 26. Juli veröffentlichten ein Start-up aus Shanghai und eine der führenden Universitäten Chinas ihre Antwort auf diesen blinden Fleck – und deren Umfang ist das Besondere daran.
Xinzhi Embodied Intelligence Technology, das im englischsprachigen Raum unter dem Namen NeoteAI firmiert, veröffentlichte gemeinsam mit dem Institut für vertrauenswürdige verkörperte KI der Fudan-Universität drei technische Berichte, die auf einem Korpus basieren, den die Partner „NeoData“ nennen: mehr als 30.000 Stunden synchronisierter Videoaufnahmen visueller und taktiler Interaktionen, rund 1,4 Millionen Handlungsclips, die 450 reale Aufgaben mit langfristigem Zeithorizont umfassen – vom Zusammenlegen von Wäsche bis zum Ein- und Ausstecken von Steckern. In der Berichterstattung über die Veröffentlichung ist von Milliarden aufeinander abgestimmter RGB- und taktiler Bilder die Rede. Die Partner geben an, dass sowohl die Daten als auch die darauf trainierten Modelle als Open Source zur Verfügung gestellt werden.
Zur Einordnung: Die Bild-Sprache-Datensätze, die den Boom der generativen KI ausgelöst haben, wurden aus dem bereits bestehenden Internet zusammengestellt. Für taktile Daten gibt es kein Internet, aus dem man Daten scrapen könnte. Jede einzelne Stunde muss von mit Sensoren ausgestatteten Robotern und tragbaren Erfassungsgeräten erzeugt werden, die Objekte physisch berühren – weshalb die meisten akademischen taktilen Datensätze höchstens einige Dutzend oder einige Hundert Stunden umfassen. Sollte sich der Umfang von NeoData einer genauen Prüfung standhalten, würde es zu den größten jemals zusammengestellten Tastsortimenten zählen, und die Tatsache, dass es von einem einjährigen chinesischen Start-up und nicht von einem Labor im Silicon Valley stammt, ist an sich schon ein wichtiger Indikator im Wettlauf um die verkörperte KI.
Warum die Tastsinnwahrnehmung ein Jahrzehnt des Roboterlernens besiegt hat
Ein kurzer Exkurs erklärt, warum dieses Korpus eine Diskussion wert ist. Moderne Roboter-Algorithmen werden größtenteils anhand von Kameradaten trainiert
Ansichten und Gelenkpositionen, die für das Greifen und grobes „Pick-and-Place“ ausreichen. Aufgaben mit zahlreichen Berührungspunkten machen dieses Konzept aus drei sich verstärkenden Gründen zunichte. Erstens: Verdeckung – im Moment des Kontakts verdecken die eigenen Finger des Roboters die Interaktion aus jedem Kamerawinkel. Zweitens die Dynamik: Kräfte ändern sich im Millisekundenbereich, schneller, als Bildverarbeitungs-Pipelines Einzelbilder verarbeiten können; wenn eine Kamera also erkennt, dass ein Objekt wegrutscht, ist der Fehler in der Kontaktzeit bereits Sekunden alt. Drittens die Unsichtbarkeit: Die Eigenschaften, die über den Erfolg entscheiden – Reibung, Nachgiebigkeit, Spannung in einem Kabel –, sind in keinem Bild überhaupt zu erkennen. Menschliche Hände lösen alle drei Probleme mit rund 17.000 Mechanorezeptoren und einem spinalen Reflexkreislauf, der die Griffkraft korrigiert, noch bevor das Gehirn überhaupt zu Rate gezogen wird. Roboter verfügen über nichts Vergleichbares, und die Datensätze, aus denen sie dies lernen könnten, haben in diesem Umfang noch nie existiert. Diese Lücke will NeoData nun schließen.Drei Modelle und ein Argument
Die Veröffentlichung bündelt drei technische Ansätze, die zusammen ein einziges Argument bilden: Der Tastsinn sollte als eigenständige Sinnesmodalität mit eigenen Skalierungsgesetzen behandelt werden, nicht als bloße Ergänzung zum Sehsinn.
NeoForce, der erste Bericht, befasst sich mit dem Problem, das die taktile Forschung seit Jahren spaltet: Jeder Sensor „spricht“ eine andere Sprache. Messwerte verschiedener taktiler Hardware sind nicht kompatibel, sodass Datensätze nicht zusammengeführt werden können. NeoForce schlägt eine einheitliche taktile Darstellung mit zeitlicher Struktur und geräteübergreifender Übertragbarkeit vor – im Grunde eine gemeinsame Einbettung, in die die Signale verschiedener Sensoren projiziert werden können. Wenn dies wie beschrieben funktioniert, löst es den Engpass der Datenfusion in diesem Forschungsgebiet auf dieselbe Weise, wie gemeinsame Tokenizer die Zusammenführung von Textkorpora ermöglichten.
VTLA, der zweite Bericht, bringt eine neue Perspektive ein. Herkömmliche Ansätze verarbeiten den aktuellen taktilen Messwert, der der physikalischen Realität hinterherhinkt: Wenn die Verschiebung wahrgenommen wird, ist das Objekt bereits in Bewegung. Das VTLA-Modell
prognostiziert die weitere Entwicklung der Berührungsinteraktion bis zu 50 Schritte im Voraus und richtet die Maßnahmen nach dieser Prognose aus. Die berichteten Ergebnisse bei zwei kontaktintensiven Benchmarks – 85 Prozent Erfolgsquote beim Einstecken eines Steckers und 99 Prozent beim Herausziehen einer Taste – sind genau jene unscheinbaren, hochpräzisen Aufgaben, bei denen rein bildbasierte Ansätze regelmäßig scheitern, und es sind diese Zahlen, die konkurrierende Labore als Erstes zu reproduzieren versuchen werden.TWAM, der dritte Bericht, ist ein taktiles Weltmodell – ein System, das einen Vorgang gedanklich durchspielt und sowohl visuelle als auch taktile Folgen durchrechnet, bevor der Roboter eine Bewegung ausführt; dabei wird eine durchschnittliche simulierte Erfolgsquote von 84,5 Prozent angegeben. Weltmodelle stellen derzeit die Grenze im Bereich der verkörperten KI dar, von Nvidias „Cosmos“ bis hin zur „Genie“-Reihe von Google DeepMind, doch fast alle von ihnen prognostizieren Pixel. Ein Weltmodell, das auch taktile Reize vorhersagt, ist ein wahrhaft seltenes Konstrukt, und sollte sich seine simulierten Probedurchläufe auf physische Hardware mit einer Rate übertragen lassen, die auch nur annähernd der gemeldeten entspricht, würde dies den teuersten Teil des Robotertrainings verkürzen: das Scheitern an realen Objekten, mit echtem Bruch, in Echtzeit.
Das Unternehmen hinter dem Korpus
NeoteAI ist jung, klein und bewusst als Full-Stack-Unternehmen ausgerichtet. Entstanden im Institut für vertrauenswürdige verkörperte KI der Fudan-Universität, kündigte das Unternehmen aus Shanghai Ende Mai eine Angel-Finanzierungsrunde in Höhe von fast 100 Millionen RMB (etwa 14 Millionen US-Dollar) an. Seine Strategie reicht von eigenen visuo-taktilen Sensoren – die auf der Arbeit des Teams des Fudan-Forschers Chen Wenming basieren – über die Datenerfassung bis hin zu taktilen Grundmodellen. Die Datenerfassungs-Pipeline verläuft auf zwei Ebenen: echte Roboter und von Menschen bediente, universelle Handgeräte zur Manipulation. Auf diese Weise kann ein Start-up 30.000 Stunden Daten sammeln, ohne über ein ganzes Lager voller Roboterarme zu verfügen.
Dieser Full-Stack-Ansatz ist von strategischer Bedeutung. Im amerikanischen Ökosystem ist die taktile Sensorik nach wie vor weitgehend
ein Komponentengeschäft, bei dem Unternehmen Sensoren an die Roboter anderer Firmen verkaufen. NeoteAI setzt darauf, dass derjenige, der den Sensor, das Datenformat und das Modell besitzt, den Standard dafür setzt, wie Maschinen „empfinden“ – eine Position, die Nvidia im Bereich der Simulation einnimmt. Das Open-Source-Versprechen sollte vor diesem Hintergrund betrachtet werden: Durch die Veröffentlichung von Daten und Modellen werden das Ökosystem mit den eigenen Formaten und Benchmarks durchdrungen, sodass sich die Werkzeuge der Branche rund um die eigene Hardware entwickeln. Es ist dieselbe Strategie, die Unitree bei kostengünstiger Hardware verfolgt hat und die Ecovacs an diesem Wochenende mit seiner als Open Source veröffentlichten Heimroboterplattform umsetzt, über die heute separat berichtet wird.Die Verbindung zur Fudan-Universität ist zudem ein Zeichen dafür, wie sich Chinas Kompetenz im Bereich der verkörperten KI weiter vertieft. Das „Institute of Trustworthy Embodied AI“ gehört zu einer Welle universitätsnaher Institute, die Shanghai ins Leben gerufen hat, um akademische Robotik in Unternehmen umzusetzen, und der Werdegang von NeoteAI – vom Laborsensor über die Angel-Finanzierungsrunde bis hin zur Veröffentlichung eines vielbeachteten Datensatzes innerhalb von vierzehn Monaten – ist das Beispiel dafür, dass das Konzept wie vorgesehen funktioniert. Das gleiche Wochenende lieferte parallele Belege aus dem gesamten Ökosystem: Ecovacs stellte in Suzhou eine Heimroboterplattform als Open Source zur Verfügung, und Kapital von Prominenten floss in Unternehmen im Bereich der verkörperten KI – beides wird heute separat behandelt. Die Dichte unabhängiger Akteure, die an einem einzigen Wochenende glaubwürdige Schritte unternehmen, ist an sich schon ein Maß dafür, wie stark sich Chinas Ökosystem für verkörperte KI weiterentwickelt hat.
Die Checkliste für Skeptiker ist übersichtlich: Die Berichte sind selbst veröffentlicht und noch nicht von Fachkollegen begutachtet, die angegebenen Erfolgsraten stammen aus der eigenen Aufgabenauswahl der Autoren, und simulierter Erfolg in einem Weltmodell ist noch kein erfolgreicher Einsatz in einer Fertigungslinie. Die genaue Zusammensetzung der 30.000 Stunden – wie viel davon auf manuelle Datenerfassung und wie viel auf Robotererfahrung entfällt und wie viel davon strenge Qualitätsprüfungen zur Datenanpassung besteht – wird darüber entscheiden, ob der Datensatz ein Ölfeld oder eine Mülldeponie ist. Und Open-Source-Zusagen von Start-ups erfolgen nach deren eigenem Zeitplan, nicht
die der Community; solange die Download-Links noch nicht verfügbar sind, handelt es sich bei der Zusage um Marketing. Ein Präzedenzfall, den man im Auge behalten sollte, ist die Vision-Language-Robotik selbst, bei der Ankündigungen von Datensätzen manchmal um ganze Quartale den Veröffentlichungen nutzbarer Versionen voraus waren.Warum die Berührungswahrnehmung zum nächsten Datenwettlauf wird
Der Kontext, der dies über die technischen Berichte eines einzelnen Start-ups hinaushebt, ist ein Muster, das diese Publikation den ganzen Monat über verfolgt hat. Die knappe Ressource in der verkörperten KI verlagert sich von Rechenleistung und Kapital hin zu verkörperten Daten – jener Art von Daten, die nicht gescrapt werden können, da sie physisch generiert werden müssen. KAIST und Nvidia kündigten am 26. Juli die Einrichtung eines Zentrums an, um ein Grundmodell aus klinisch validierten menschlichen Bewegungsdaten zu entwickeln, worüber heute separat berichtet wurde. Chinas nationales Datenamt baut derzeit eine Infrastruktur für verkörperte Daten auf, und kommunale Trainingszentren von Peking bis Shenzhen dienen genau dem Zweck, Robotererfahrungen in großem Maßstab zu erzeugen. Der Tastsinn ist die logische nächste Front: Er ist die Modalität, in der die menschliche Geschicklichkeit die Fähigkeiten von Robotern am stärksten übertrifft, und jene, für die weltweit die wenigsten Daten vorliegen.
Es gibt zudem eine Auswirkung auf die Lieferkette, die für Hardware-Käufer erwähnenswert ist. Sollten sich taktile Modelle auf der Grundlage chinesischer Sensoren und chinesischer Datenformate etablieren, könnte die taktile Sensorik denselben Weg einschlagen wie Robotergelenke, bei denen chinesische Vier-in-Eins-Aktuator-Module zum weltweiten De-facto-Standard wurden. Sensorhersteller und Hersteller geschickter Roboterhände im Westen und in Japan – ein Bereich, in dem etablierte Marktführer im Bereich der Kraft-Drehmoment-Erfassung vertreten sind – sollten einheitliche Darstellungsformate wie NeoForce als Standardisierungsinitiative betrachten und nicht nur als theoretisches Konzept.
Für Robotik-Teams, die abwägen, ob sie sich daran beteiligen sollen, ist die praktische Vorgehensweise klar. Achten Sie darauf, dass die angekündigten Repositorien auf den üblichen Hosts online gehen, und testen Sie, sobald dies der Fall ist, zunächst die Übertragbarkeitsbehauptung von NeoForce, da eine Darstellung, die tatsächlich eine Brücke zwischen Sensoren schlägt,
Solche Typen würden jedem Labor, das über einen eigenen kleinen Datensatz zu taktilen Reizen verfügt, unmittelbar zugutekommen. Vergleichen Sie die von VTLA angegebenen Werte für das Einstecken von Steckern und das Herausziehen von Schlüsseln auf unabhängiger Hardware, bevor Sie diese zitieren. Und betrachten Sie die Lizenzbedingungen von NeoData als strategische Informationen: Ob eine kommerzielle Nutzung gestattet ist und unter welchen Namensnennungsbedingungen, wird zeigen, ob NeoteAI eine gemeinsame Plattform aufbaut oder einen Trichter zu seinen Sensoren schafft.Die zitierfähige Zusammenfassung lautet wie folgt: Roboter haben aus dem Internet gelernt zu sehen, doch es gibt kein „Internet der Berührung“ – daher muss es jemand Stunde für Stunde aufbauen, und ein von der Fudan-Universität gefördertes Start-up hat gerade den bislang größten öffentlich bekannten Vorsprung für sich beansprucht. Ob sich NeoData als der „ImageNet-Moment“ der verkörperten KI oder als überbewerteter Korpus erweisen wird, wird durch Reproduzierbarkeit entschieden, nicht durch Presseberichte. So oder so: Der Wettlauf, Maschinen das Fühlen beizubringen, hat nun einen festgelegten Maßstab, und dieser umfasst dreißigtausend Stunden.
Haftungsausschluss: Dieser Artikel dient ausschließlich allgemeinen Informationszwecken und stellt keine Anlage-, Rechts- oder Beschaffungsberatung dar. Leser sollten Details anhand von Primärquellen überprüfen, bevor sie geschäftliche Entscheidungen treffen.












