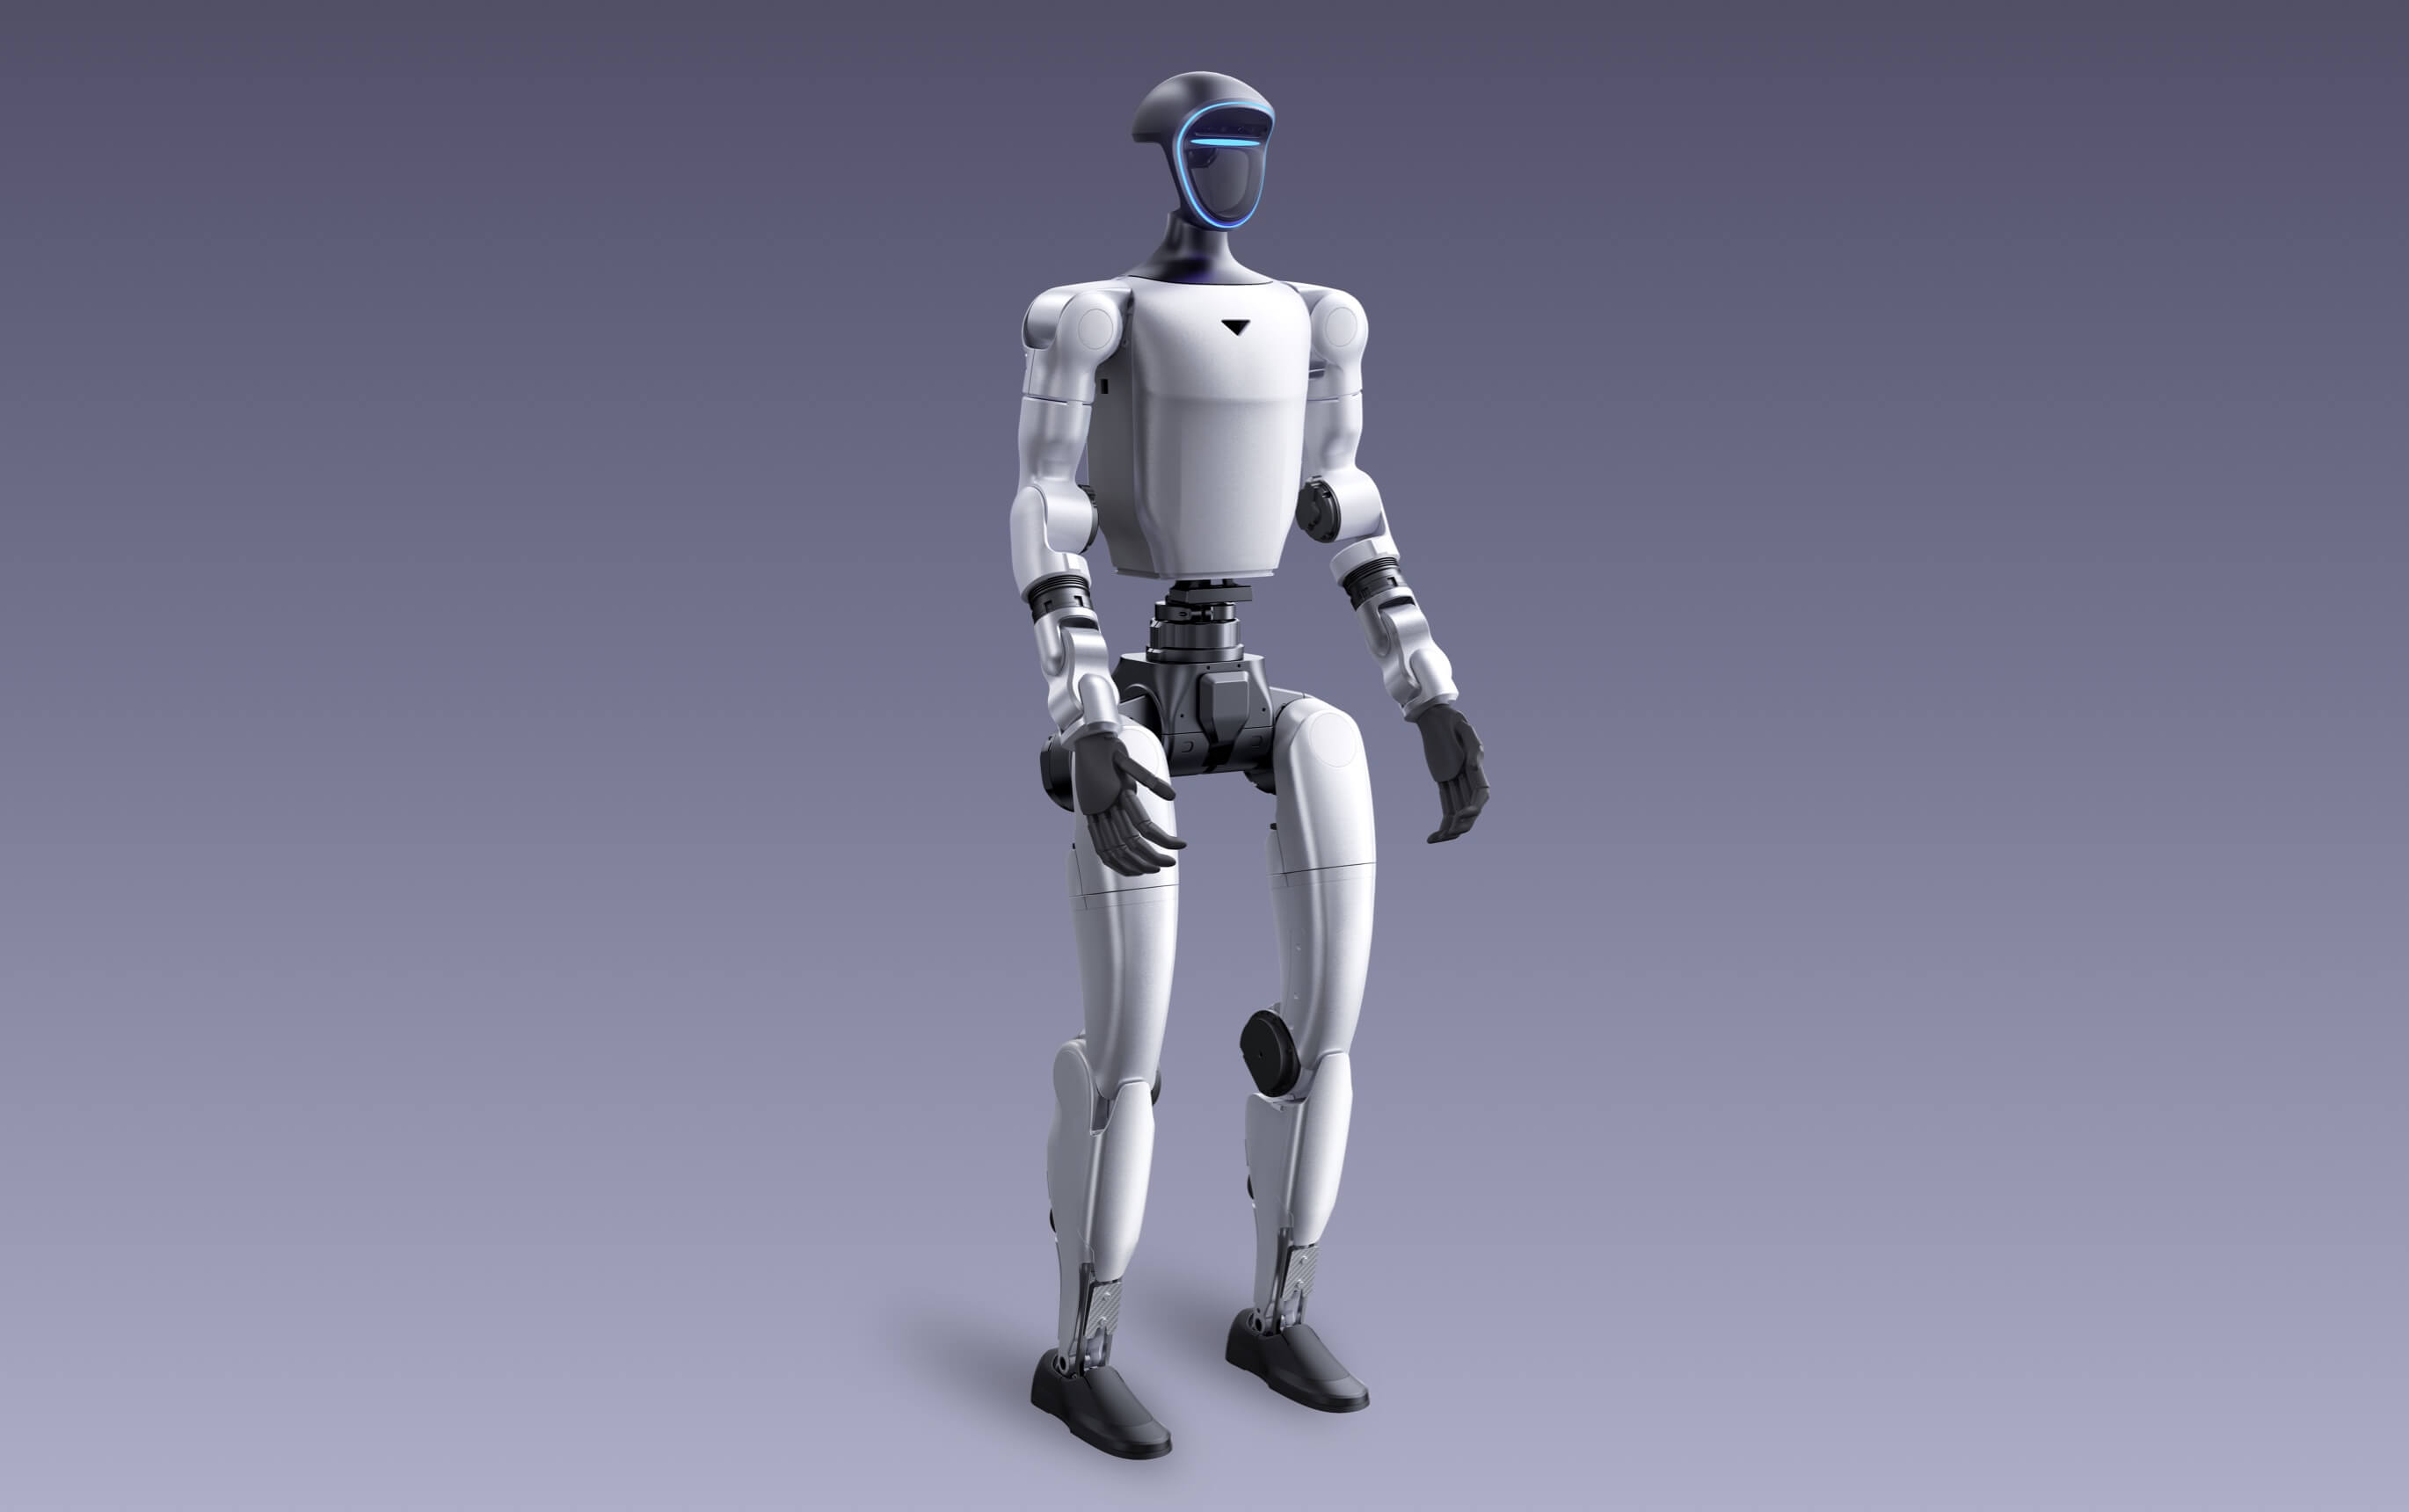
Rhoda AI 關閉其機器人的相機,以證明僅靠觸覺即可運作
帕洛阿爾托新創公司 Rhoda AI 展示了一台機器人,即使其攝影機被遮擋,仍能透過新型觸覺感測器及擴展版的「直接視訊-動作」(Direct Video-Action)模型,僅憑觸覺尋找並拾取具有不同紋理的球體。


正因為配備了一款能於同一指尖偵測小至數毫牛頓、大至超過 40 牛頓力的感測器,Rhoda AI 才得以在刻意關閉機器人攝影機的情況下,進行此次最新示範。 總部位於加州帕洛奧圖的機器人新創公司 Rhoda AI,專注於開發觸覺感測與操作模型。該公司於 2026 年 10 月 13 日發表了一份技術報告,展示了一台機器人僅憑觸覺,便能從箱子中尋找、辨識並取出帶有不同紋理的球體,且在整個任務過程中,其頭部與手腕的攝影機均被遮蔽。
Rhoda 的核心技術是一種新型觸覺感測器,搭配該公司「直接影像-動作」(Direct Video-Action)模型的延伸版本——該系統最初是為了將視覺輸入直接映射到機器人動作而建構,現已改為預測未來的觸覺訊號,而非未來的影像。 逆動力學模型將這些觸覺預測轉換為實際的機器人動作,而最新的感測器讀數會持續更新引導下一個動作的預測,從而形成一個閉環系統,使觸覺(而非視覺)成為搜尋的驅動力。
「蒙眼」實驗實際證明了什麼
「蒙眼」的設定並非噱頭;這是一項刻意設計的剝離實驗,旨在孤立觸覺系統自身的能力,避免視覺在觸覺模型存在缺口時悄然進行補償。 當今大多數機器人操作系統在物體定位方面高度依賴視覺,僅將觸覺作為次要訊號,待相機已大致識別出物體位置後,才利用觸覺對抓取動作進行微調。 Rhoda 的示範在搜尋與擷取階段完全將視覺排除在迴路之外,迫使觸覺模型執行通常由相機系統處理的工作:憑觸感在箱內定位物體、僅憑質感辨別所找到的物體種類,並決定是否擷取該物體或繼續搜尋。
這比觸覺輔助抓取要困難得多。配備相機的機器人在搜尋箱子時,能夠看到整個工作空間,
僅此一次;一臺蒙著眼睛、僅靠觸覺運作的機器人,必須透過逐次接觸——每次僅探測一次——來理解垃圾桶內有何物,且無法依賴任何恆定的整體視圖作為參考。羅達(Rhoda)的感測範圍,從幾毫牛頓起, 精細到足以偵測表面紋理而不造成干擾,到超過 40 牛頓,足以偵測穩固的抓握或啞鈴級的負載,正是這種細粒度、接觸驅動式搜尋得以運作的硬體先決條件。示範影片中的真實部分
Rhoda 並未發布經過修飾、毫無瑕疵的精華片段,而這個選擇本身就對正在評估業界觸覺感測主張的買家具有參考價值。公開的影片中,機器人偶爾會選錯球,並必須重新掃描才能自我修正,而非將這些片段剪輯掉。 採購團隊在評估新興操作技術時,應將這類公開的失效模式視為比無瑕疵的展示影片更有價值的訊號,因為它展現了系統實際的錯誤恢復行為,而非經過精心挑選的成功運行片段。 此外,影片部分片段經過加速處理,某些段落加速了 6 倍和 12 倍,採購方應將此解讀為提升觀看體驗的呈現選擇,而非對即時任務速度的宣稱;Rhoda 並未公布相關的即時完成數據。
Rhoda 所披露的定量結果範圍雖窄,但相當具體。該模型僅以兩顆球體進行訓練——一顆光滑、一顆帶紋理——並在總計七顆球體上進行測試,其中包括兩顆模型在訓練期間從未接觸過的帶紋理球體。 該公司報告指出,機器人在測試中成功拾取了全部三顆帶紋理的球體——包括一顆已受訓的球體以及兩顆新出現的球體;不過,Rhoda 並未公布針對全部七顆測試球體的整體成功率,也未透露每項測試涉及多少次嘗試。這是一項值得關注的限制:一項小範圍且具體的結果(針對帶紋理球體的三試三中)雖能展示該
此概念在狹義情況下雖能運作,但尚未能在更廣泛的物體形狀、材質或貨箱配置範圍內,建立出統計上可靠的成功率——而這些正是實際倉庫或組裝應用所必需的。為何觸覺感測是機器人操作中更艱難的一半
基於視覺的機器人感知技術在過去幾年間迅速發展,這主要歸因於相機價格低廉、技術成熟,且受益於那些已廣泛改變圖像識別領域的深度學習技術。 觸覺感測之所以落後,則是出於一些更為尋常的工程原因:耐用且高解析度的力感測器難以低成本製造;其訊號本身比相機的廣角視野更易受干擾且更具局部性;此外,相較於視覺模型可用的龐大影像資料集,觸覺領域歷來缺乏標準化的訓練資料。 Rhoda 的賭注在於,彌合這項差距對於那些僅靠視覺無法可靠完成的任務至關重要,例如處理容器內被遮擋的物體、在低光或塵埃遮蔽的環境中作業,或是操縱布料或鬆散電纜等材料——在這些情況下,視覺外觀無法可靠地預測材料在接觸時的行為表現。
對於根據操作能力評估機器人供應商的採購方而言,觸覺感測的宣稱向來是最難獨立驗證的項目之一,因為多數公司展示的觸覺功能,往往是疊加在視覺系統之上的輔助功能,而非獨立運作的能力。 Rhoda 決定在此次演示中完全去除視覺系統,這為採購團隊提供了一個更純粹(儘管範圍較窄)的評估依據:即僅憑觸覺模型,在沒有任何視覺輔助的情況下,能否執行基本的搜尋與取物任務。 根據迄今公布的有限證據,答案是「有條件的肯定」——針對置於受控箱中的簡單剛性、帶紋理物體;而更關鍵的問題在於,這項能力是否能推廣至
現實世界中更複雜的操作任務仍待解決。Rhoda 的方法在觸覺感測競爭對手中處於何種地位
致力於提升機器人觸覺表現的並非只有 Rhoda 一家。過去一年來,多家專注於人形機器人與操作任務的機器人公司都發表了各自的觸覺感測器研究成果,這些研究通常將觸覺定位為一種輔助技術,用以精進現有的視覺抓取能力,而非作為獨立的感知通道。 Rhoda 示範的獨特之處在於,其明確且刻意地將視覺從整個搜尋任務的迴路中移除,而不僅限於最終的抓取階段。這項主張比多數競爭對手的觸覺感測器公告更為大膽,同時也更容易讓外部觀察者進行驗證, 這正是因為在公開的影片中,被遮擋的攝影機畫面清晰可見且毫無歧義;相較之下,若觸覺輔助層被埋藏在更廣泛的視覺驅動處理流程中,便難以判斷觸覺實際上發揮了多少作用。
這種可驗證性在聲譽上對 Rhoda 有利,但也提高了該公司為自己設下的門檻。既然已證明在受控環境下,一套無相機、純觸覺的系統能夠搜尋箱內物品並成功識別三顆不同紋理的球體(三試三中),外界現在將期待 Rhoda 能證明相同方法在更混亂的條件下同樣有效: 更多類型的物體、更難區分的紋理、裝有多個重疊物品的雜亂箱子,以及基於足夠大樣本量所揭露的成功率——該成功率須具備統計學上的意義,而非僅供示意。觸覺感測領域的競爭對手,以及正在比較供應商的買家,在將純觸控操作視為商業化就緒之前,理所當然會要求看到這新一輪的證據。
「無視覺觸覺」的商業價值
在那些視覺系統已因與機器人智能無關的原因而難以應對的環境中,獨立於相機的觸覺系統的實際價值最為明顯:一個
倉庫貨位堆疊三層深,導致自上而下的攝影機無法看見下方物品;或是充滿灰塵或水蒸氣的工業環境,導致鏡頭起霧或蒙上薄膜;又或是像在進行維護作業時,機器機箱內部那樣的黑暗密閉空間。 在上述每種情況下,能夠僅憑觸覺來定位、識別並取回物體的機器人,都具備純視覺系統無法比擬的運作優勢,因為無論相機品質如何,物理環境本身都會阻斷視覺系統所需資訊的傳遞。對於針對這些特定失效模式評估新興操作設備供應商的採購團隊而言,Rhoda 的示範提供了一個有用的早期訊號,表明在現有觸覺硬體的支援下,獨立於攝影機的運作在機械層面上是可行的;但這尚未證明任何供應商(包括 Rhoda 在內)已針對這些更嚴苛的環境開發出可部署的產品。 實驗室中裝有帶紋理球的箱子,與真實環境中被完全遮擋且雜亂無章的工業箱子之間存在巨大差距,要彌合這道鴻溝,需要進行大規模且統計上可靠的測試——而這正是 Rhoda 尚未公佈的。
什麼會改變最終結論
該感測器的測量範圍從幾毫牛頓到超過 40 牛頓,並以約 500 Hz 的頻率採樣振動,這是本次公告中值得記住的關鍵數據,因為正是這項具體的硬體規格,才使得蒙眼搜尋成為可能, 這也是競爭對手在開發對手觸覺感測器時,將被拿來作為衡量標準的指標。在 Rhoda 公布針對更多樣化物體集的大規模成功率之前,買家應將此次示範視為「純觸覺物體搜尋與辨識」的可信概念驗證,而非證明觸覺感測已準備好在商業操作部署中取代視覺的證據。
本文綜合了 Rhoda AI 於 2026 年 10 月 13 日發布的技術研究文章,以及《Humanoids Daily》於 2026 年 10 月 15 日針對該主題的報導。
「蒙眼機器人」示範,截至所述發布日期。本文僅供一般資訊參考之用,並不構成任何投資、採購、法律或工程方面的建議。數據反映截至所述資訊截止日為止上述來源所載內容,並可能隨時變更,恕不另行通知。