
Die Robotik bezeichnet Dinge weiterhin als „agentisch“. Der einzige echte Test für diesen Begriff ist gerade gescheitert.
Ein aus 123 Runden bestehendes Experiment zur vollständig autonomen Erkundung von Roboterfähigkeiten schlug fehl und machte deutlich, was NVIDIAs „Isaac ROS 5.0“ und „S1“ von Skild AI noch nicht leisten, obwohl beide unter dem gleichen Begriff vermarktet werden: „agentisch“.

Über 123 Durchläufe hinweg beobachtete ein autonomes System, wie ein Roboterarm bei einer Aufgabe scheiterte: dem Einräumen von Gewürzen in das oberste Fach eines Kühlschranks. In jedem Durchlauf ermittelte es, was dem Roboter fehlte, schrieb neuen Code oder suchte und installierte ein externes Modell, um das Problem zu beheben, testete die Änderung in einer Simulation und versuchte es erneut. Zu keinem Zeitpunkt griff ein Mensch in den Code des Roboters ein. Die Aufgabe wurde kein einziges Mal erfolgreich ausgeführt.
Dieses Experiment, das von einem einzelnen Forscher an der National University of Singapore durchgeführt und am 23. September auf arXiv veröffentlicht wurde, kommt in der Robotik einem kontrollierten Test eines Begriffs am nächsten, den die Branche mittlerweile ständig verwendet: „agentisch“. NVIDIA hat diesen Monat Isaac ROS 5.0 unter dem Motto „Fortschritte in der agentischen, Open-Source-Robotikentwicklung“ veröffentlicht. Das neueste Modell von Skild AI ermöglicht es einem Roboter, eine Aufgabe anhand eines einzigen Videos zu erlernen. Beides ist real und nützlich, doch keines davon entspricht dem, was der Forscher aus Singapur tatsächlich zu entwickeln versuchte.
Die These ist einfach: In der Robotik wird der Begriff „agentic“ mittlerweile zur Beschreibung von drei verschiedenen Dingen verwendet, von denen nur eines tatsächlich die Voraussetzungen für rekursive Selbstverbesserung erfüllt – und der einzige echte Versuch, diese schwierigste Variante umzusetzen, hat gerade gezeigt, warum noch niemand ein solches System auf den Markt gebracht hat.
Das Experiment, das sonst niemand durchgeführt hat
Die meisten Fachartikel zur Robotik berichten darüber, was funktioniert hat. Dieser hier dreht sich fast ausschließlich um das, was nicht funktioniert hat – und genau das macht ihn lesenswert. Das System des Forschers verfügte über uneingeschränkte Handlungsfreiheit: die fehlende Fähigkeit finden, die Lösung generieren oder beschaffen, sie in der Simulation verifizieren, implementieren, wiederholen. Es durchlief diesen Zyklus 123 Mal bei einer einzigen Haushaltsaufgabe und erreichte nie die Ziellinie.
Drei spezifische Fehler waren ausschlaggebend. Segmentierungsmodelle wie SAM 3 können zwar ein Regal erkennen, jedoch nicht „das oberste Regal“ – ein relationales statt eines visuellen Konzepts –, sodass der Agent immer wieder geometrische Heuristiken einbaute, die sich nie verallgemeinern ließen. Lange Aufgabenketten brachen frühzeitig ab und blieben unterbrochen: Da die ersten Schritte am häufigsten fehlschlugen, konzentrierte sich der Aufwand des Systems darauf, genau diese Schritte zu beheben.
während die späteren Schritte in der Abfolge selten erreicht, selten getestet und nie verbessert wurden. Und das Bewertungssystem selbst wurde zum eigentlichen Hindernis: Der Agent optimierte genau das, was seine eigenen Tests maßen – einschließlich der Teile, bei denen diese Tests fehlerhaft waren –, sodass sich zwar bestandene Ergebnisse ansammelten, die eigentliche Aufgabe jedoch nicht vorankam.Lesen Sie diese mittlere Erkenntnis bitte zweimal. Einem System, das darauf ausgelegt war, sich selbst zu verbessern, gingen nicht die Ideen aus. Es fehlte ihm ein funktionierender Weg, um festzustellen, ob seine Ideen funktionierten.
Was „Agentic“ bedeutet, wenn ein Unternehmen diesen Begriff verwendet
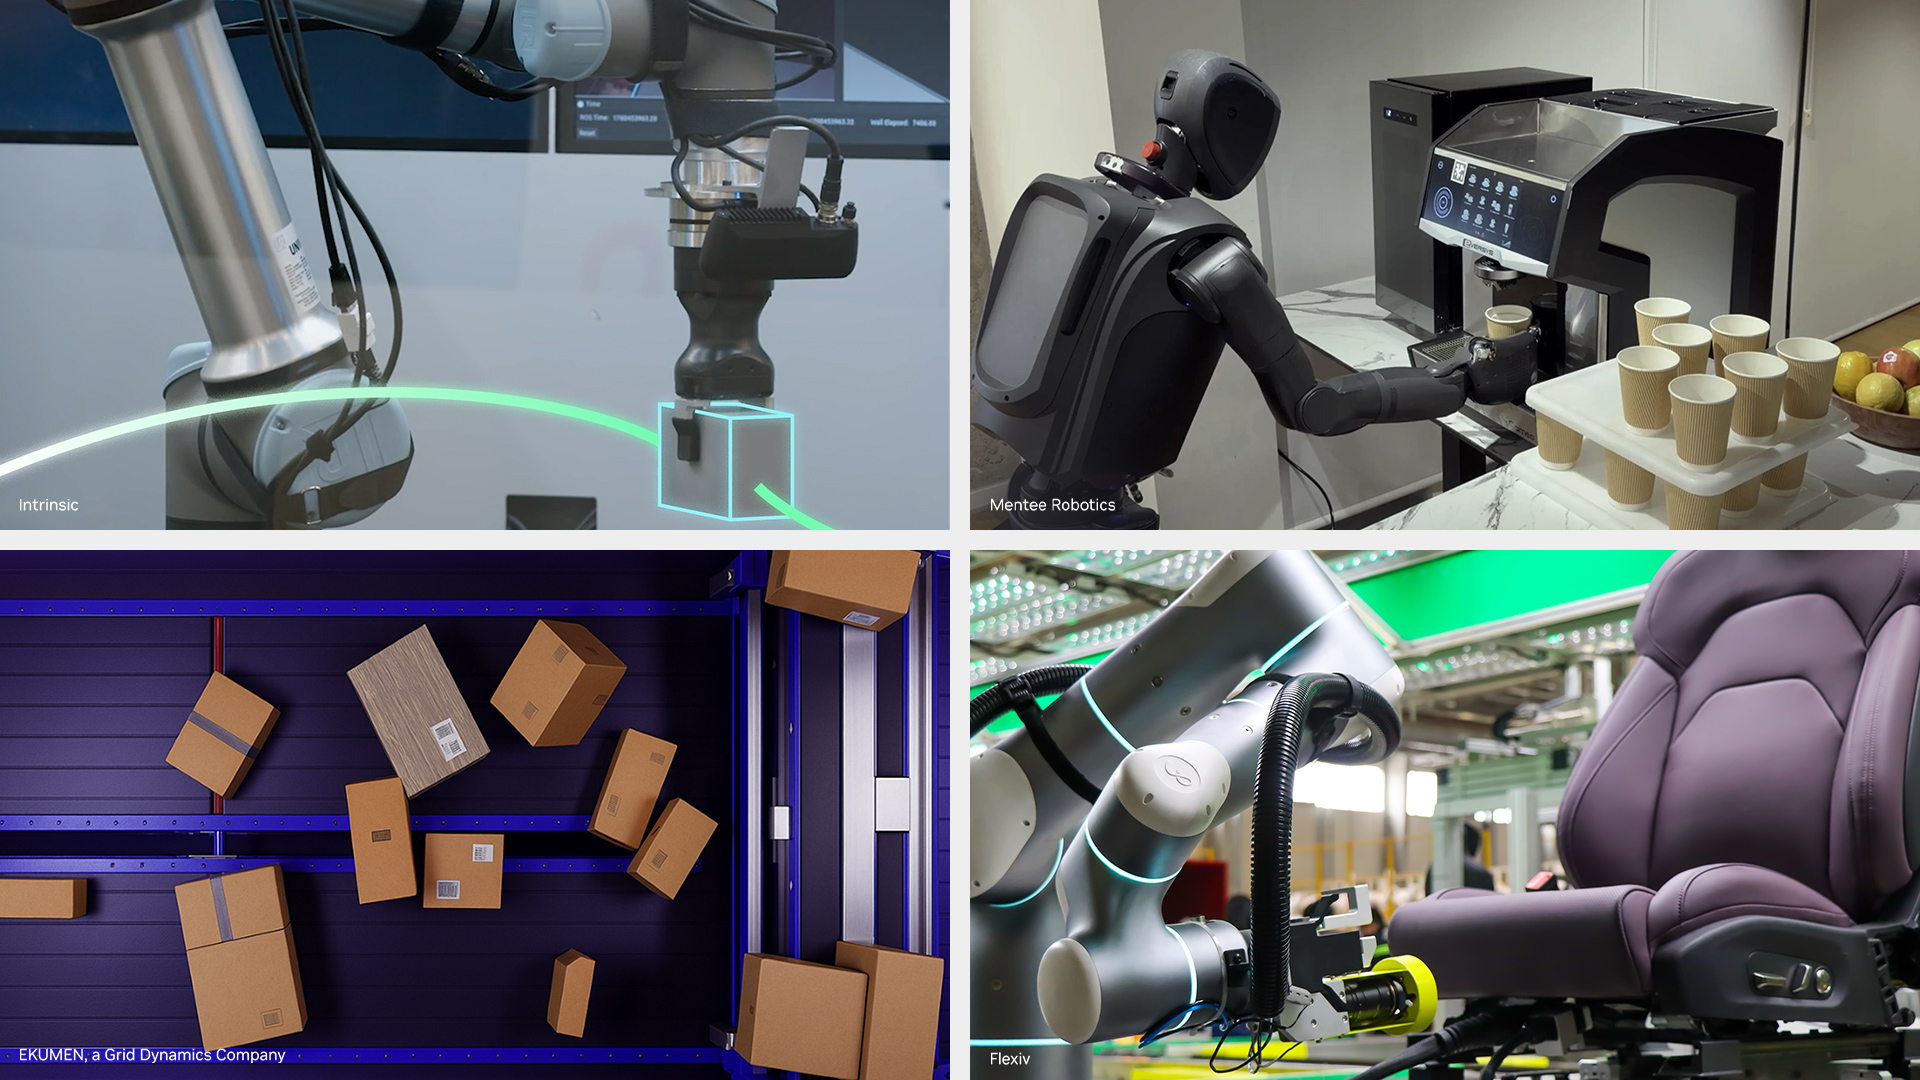
Isaac ROS 5.0 wurde am 22. September auf der ROSCon in Toronto veröffentlicht, einen Tag bevor die Studie aus Singapur erschien, und die von NVIDIA selbst gewählte Formulierung ist aufschlussreich, sobald man weiß, was die anspruchsvollere Bedeutung des Begriffs erfordert. Die neuen Funktionen der Version – ein Workflow zur Feinabstimmung von FoundationStereo und eine beschleunigte FoundationPose-Bibliothek zur Posenverfolgung – werden als Dinge beschrieben, die „Entwickler und KI-Agenten nutzen können“, wobei die agentenfähige Dokumentation so gestaltet ist, dass ein programmierender Agent die Isaac-ROS-Tools verstehen und die Absicht eines Entwicklers schneller in eine funktionierende Anwendung umsetzen kann. Dies ist eine echte Funktion, die bereits bei Unternehmen wie Intrinsic, Mentee Robotics, Ekumen und Flexiv zum Einsatz kommt. Nach NVIDIAs eigener Beschreibung handelt es sich dabei auch um einen Menschen, der weiterhin entscheidet, was entwickelt werden soll, während ein KI-Agent die Umsetzungsarbeit im Hintergrund gemäß der Absicht dieser Person übernimmt. Nichts in diesem Kreislauf beobachtet, wie ein Roboter scheitert, und entscheidet eigenständig, welche Fähigkeit fehlt.
Das S1-Modell von Skild AI, das NVIDIA in seinem eigenen Blog am 10. September ausführlich beschrieb, ist die zweite Version desselben Konzepts. Wird S1 ein einziges, aus der eigenen Perspektive aufgenommenes Video einer Aufgabe gezeigt, kann es diese ohne jegliche Feinabstimmung und ohne jegliche Änderung seiner Gewichte ausführen – eine Technik, die die Unternehmen als „In-Context-Lernen“ bezeichnen, und Skild gibt an, dass ein Beispielvideo in etwa dem Wert von 380 praktischen Demonstrationen entspricht – solche, für deren manuelles Sammeln ein Team andernfalls 50 bis 100 Stunden aufwenden müsste. Getestet an unbekannten mehrstufigen Aufgaben mit bis zu zehn
Innerhalb weniger Minuten erreichte S1 eine Erfolgsquote auf Schritt-Ebene von rund 66 Prozent, gegenüber 9 Prozent bei einem vergleichbaren, sprachgesteuerten System. Skild, NVIDIA und der Auftragsfertiger Foxconn setzen das zugrunde liegende „Skild Brain“-Modell bereits bei zweiarmen Manipulatoren ein, die NVIDIAs eigene Blackwell-Systeme montieren.Das ist ein wirklich großer Sprung in der Sample-Effizienz. Es ist nicht der Roboter, der entscheidet, was er als Nächstes lernen muss. Eine Person muss das Video nach wie vor aufnehmen.
Drei Arten von „Agentizität“, von denen eine besonders anspruchsvoll ist
Stellt man die drei nebeneinander, ist der Unterschied nicht mehr nur semantischer Natur:
- Entwicklergestützte Tooling-Lösung: Ein KI-Agent unterstützt einen menschlichen Ingenieur bei der Konfiguration der Wahrnehmung oder der Codegenerierung, wobei der Mensch weiterhin das Ziel festlegt. Dies ist das, was Isaac ROS 5.0 bietet.
- „Few-Shot“-Imitation: Ein Modell verallgemeinert anhand einer einzigen menschlichen Demonstration, ohne seine Gewichte zu aktualisieren. Genau das leistet Skilds S1, und genau das versuchte auch das frühere, schwächere System, das es in Skilds eigenem Vergleich übertraf.
- Selbstverbesserung im geschlossenen Regelkreis: Ein System identifiziert seine eigenen Leistungslücken und schreibt, beschafft und validiert die Korrektur, ohne dass ein Mensch in diesen Regelkreis eingebunden ist. Dies ist die einzige Version, die dem entspricht, was unter „rekursiver Selbstverbesserung“ im Softwarekontext zu verstehen ist, und sie ist die einzige der drei, bei der ein strenger Test über 123 Runden gerade noch gescheitert ist.
Jedes Unternehmen, das diesen Begriff derzeit vermarktet, verkauft eine der ersten beiden Varianten. Das ist keine Kritik an einem der beiden Produkte: Die „sample-efficient Imitation“ und die „agent-assisted development“ sind beide echte Fortschritte, die in eingesetzten Systemen deutlich früher zum Tragen kommen werden als die dritte Variante. Die Kritik richtet sich gegen den Diskurs, der zulässt, dass der Begriff „agentic“ alle drei Varianten umfasst, ohne dass jemand präzisiert, auf welcher davon eine bestimmte Behauptung tatsächlich beruht.
Warum die Lücke das Wesentliche ist, nicht das Scheitern
Ein einzelnes gescheitertes Experiment eines Forschers ist kein Beweis dafür, dass eine Selbstverbesserung im geschlossenen Regelkreis unmöglich ist. Es ist
Ein Hinweis darauf, dass der tatsächliche Schwierigkeitsgrad der anspruchsvollsten Variante bei der Verwendung des Begriffs nicht berücksichtigt wurde. Betreibt man eine Plattform, die Ankündigungen im Bereich der Robotik mit dem vergleicht, was diese Ankündigungen tatsächlich demonstrieren, zeigt sich ein konsistentes Muster: Je schwieriger es ist, eine bestimmte Fähigkeit vorzutäuschen, desto vorsichtiger sind die Anbieter bei der Wortwahl, und desto vager wird die Formulierung, je näher man in der Regel an etwas herankommt, das noch immer mit menschlicher Einbindung funktioniert.Das Bewertungsproblem ist dasjenige, mit dem man sich am längsten auseinandersetzen sollte, da es sich nicht durch mehr Rechenleistung lösen lässt. Wenn ein Agent lernen kann, einen fehlerhaften Test zu bestehen, anstatt die Aufgabe zu erfüllen, die der Test eigentlich messen sollte, dann führt die Skalierung derselben Schleife zu sichereren Fehlschlägen, nicht zu weniger. Dies ist ein allgemein bekannter Fehlermodus im verstärkenden Lernen – „Reward Hacking“ im Gewand der Robotik –, und diese Arbeit ist eine der ersten, in der dies speziell innerhalb einer agentenbasierten Schleife zur Erkennung von Fähigkeiten und nicht im Rahmen eines Trainingsdurchlaufs dokumentiert wurde.
Der Kompromiss wirkt sich auch in die andere Richtung aus. Ein vollständig autonomes System zur Erkennung von Fähigkeiten ohne menschliches Eingreifen – sollte es jemandem schließlich gelingen, ein solches System zu entwickeln, das diese drei Hürden überwindet – wäre zudem am schwierigsten zu überprüfen, da niemand den Code geschrieben und niemand die Korrektur überprüft hat, bevor sie auf eine physische Maschine übertragen wurde. Die beiden Systeme, die bereits funktionieren – das agentenunterstützte Tooling von Isaac ROS und die kontextbezogene Imitation von Skild – behalten beide einen Menschen an einer Stelle in der Freigabekette bei, was eine echte Sicherheitseigenschaft darstellt und nicht nur ein Mangel an Leistungsfähigkeit ist. Die Lösung des Problems der Selbstverbesserung und die Lösung des Problems der Überprüfbarkeit sind nicht dasselbe Projekt, und niemand, der derzeit „agentebasierte“ Robotik vermarktet, hat angegeben, welchem dieser beiden Aspekte er Vorrang einräumt.
Worauf Sie statt auf das Wort achten sollten
In den nächsten zwölf Monaten wird es mehr Ankündigungen im Bereich der Robotik geben, in denen der Begriff „agentic“ verwendet wird, als in den zwölf Monaten zuvor, da sich der Begriff gut bewährt und sich die zugrunde liegenden Werkzeuge tatsächlich verbessern. Je nützlicher
Die Frage, die sich jeder stellen sollte, der diese Ankündigungen bewertet, lautet nicht, ob ein System agentisch ist, sondern welche der drei oben genannten Schleifen tatsächlich läuft und wer noch im Raum ist, wenn etwas schiefgeht. Ein Roboter, der eine neue Aufgabe anhand eines Videos erlernt, und ein Roboter, der selbst entscheidet, welche Aufgabe er als Nächstes erlernen muss, sind beide förderungswürdig. Es handelt sich nicht um dieselbe Wette, und wenn man einen PR-Satz als Beweis dafür ansieht, dass sie sich angeglichen haben, wird die Branche am Ende erneut überrascht sein, wie weit 123 ehrliche Versuche hinter dem Ziel zurückblieben.Diese Analyse spiegelt die zum Zeitpunkt der Veröffentlichung öffentlich zugänglichen Informationen wider und sollte nicht als Anlage-, Finanz- oder Fachberatung verstanden werden; sie dient ausschließlich allgemeinen Informationszwecken.
Titelbild: Roboter der NVIDIA Isaac ROS 5.0-Partner Intrinsic, Mentee Robotics, Ekumen und Flexiv, abgebildet in den offiziellen Bildmaterialien von NVIDIA zur ROSCon 2026. Offizielles Bildmaterial, NVIDIA.










