
解析全球商業模式:為何麗清智能剛募得數億資金,致力打造「實體人工智慧界的 iOS」
一家由28歲清華大學教授創辦、成立僅三個月的新創公司,已完成2026年中國人工智慧領域最受矚目的種子輪融資之一。 Liqing Intelligence 從包括紅杉資本中國、高瓴資本旗下的 GL Ventures 以及順為資本在內的全明星投資者陣容中,籌得數億元人民幣。 該公司正在打造所謂的「物理AI基礎設施」,這是一套整合了專有數據管道、可微分物理引擎以及原生世界模型的全棧系統,旨在訓練機器人在任何硬體規格及任何真實世界情境下運作。 本文將闡述何謂世界模型、為何其對從自動駕駛到家用機器人等各產業至關重要、李清的解決方案與 NVIDIA、Yann LeCun 的 AMI Labs 以及李飛飛的 World Labs 等全球競爭對手有何不同,以及這波融資熱潮對更廣泛的物理 AI 生態系統意味著什麼。
何謂「世界模型」,為何它如今如此重要?
過去幾年間,人工智慧的進展主要由大型語言模型所定義,這些模型專門預測文字序列中的下一個詞彙。這些系統從數兆個網路文本單詞中學習,並在推理、程式碼生成和對話方面展現出驚人的能力。但它們存在一個根本性的局限:它們學的是人類如何描述世界,而非世界實際運作的機制。 語言模型知道「重力」一詞常出現在「墜落」和「重量」附近,但它並未內建當你將一杯水懸於桌面上方並放手時會發生什麼事的內部表徵。
世界模型代表了一場從「下一個標記預測」到「下一個狀態預測」的範式轉移。世界模型不再只是預測下一個詞彙,而是預測當採取某項行動時,物理環境中接下來會發生什麼。 本質上,這是一個可學習的物理模擬器:一種人工智慧系統,能夠在動作執行前預見其後果、理解空間關係,並在時間流逝中維持對物理現實的一致內部表徵。
2026 年世界模型之所以迫在眉睫,源於兩股交匯的壓力。首先,推動語言模型進步的規模化法則正呈現邊際效益遞減的趨勢。 高品質的文本資料即將耗盡,而每美元運算成本所帶來的基準測試提升幅度也趨於平緩。其次,旨在將智能機器人部署於工廠、家庭和街道的「具身人工智慧」產業,已遭遇資料瓶頸。訓練機器人執行物理任務需要海量的真實世界互動資料,而這些資料的蒐集不僅成本高昂、耗時,有時甚至存在危險。 世界模型提供了一種解決方案:在模擬的物理環境中訓練機器人,然後僅需極少的現實世界微調,即可將技能轉移到現實中。
世界模型目前已應用於
已使用自動駕駛:最成熟的應用場景
自動駕駛是世界模型在商業應用方面最為先進的案例。Waymo 於 2026 年 2 月發布其「世界模型」,藉此模擬僅靠道路測試難以實現的大規模罕見且危險的駕駛情境。 NVIDIA 的 Cosmos 平台下載量已突破兩百萬次,為小鵬汽車(XPENG)、Waabi 及 Uber 等企業生成合成駕駛數據。 在中國,華為的自動駕駛部門公開否決了 VLA(視覺-語言-動作)方法,轉而支持其 WA(世界動作)架構;同時,吉利推出了一款「世界動作模型」,將智慧駕駛、座艙智慧與底盤控制整合為單一的物理感知系統。 效率提升相當顯著:透過世界模型合成罕見的危險情境,其效率據估計比透過實地道路測試累積同等量的數據高出十倍。
機器人學與具身人工智慧:解決數據匱乏問題
機器人學習的核心挑戰在於數據匱乏。與能夠利用整個網際網路進行訓練的語言模型不同,機器人必須透過在真實空間中與真實物體進行的即時物理互動來學習。世界模型透過讓機器人能在模擬環境中「練習」技能,並在僅需最低限度的實境校準下將這些技能轉移至實體硬體,從而解決了這個問題。 NVIDIA 於 2026 年 6 月推出的 Cosmos 3,目前在涵蓋世界生成、機器人動作策略及工業視覺等七項實體 AI 基準測試中均名列前茅。包括 1X、Agility Robotics、Figure AI 及 Unitree 在內的領先類人型與工業機器人公司,正將世界模型訓練整合至其開發流程中。
空間設計、建築與智慧家居
群和科技(Qunhe Technology)於2026年4月在香港聯交所上市,成為全球首家「空間智能」上市公司,並證明了世界模型在機器人領域之外也具備商業價值。該公司利用十多年累積的室內設計數據——包含數十億個物理上正確的房間佈局——作為具身人工智慧系統的訓練數據。 其股票在首個交易日飆升144%。此項技術的應用範圍延伸至智慧家居模擬領域,在該領域中,世界模型能夠預測機器人助理在實際部署前,將如何在特定的公寓佈局中導航、與家具互動,以及如何應對家務任務。
遊戲、電影與虛擬世界
Google DeepMind 於 2025 年底推出的 Genie 3,成為首個能以每秒 24 幀的速度生成持久性 3D 環境的即時互動式世界模型。 李飛飛(Fei-Fei Li)創辦的 World Labs 推出商業產品「Marble」,可根據文字提示生成可探索的 3D 世界,定價從免費到每月 95 美元不等。騰訊的「混元 3D 世界模型 2.0」將開放世界遊戲地圖的建構時間,從數月的人工操作壓縮至數分鐘的 AI 生成。
Liqing Intelligence:秉持全疊層理念的新銳企業
創業故事
李一明生於1997年。他於2025年1月在紐約大學完成人工智慧與機器人學博士學位,期間在CVPR、NeurIPS及RSS等頂級會議上發表超過20篇論文,累積被引用次數逾4,000次。 他的博士研究專注於3D場景解析與機器人決策的強健、高效且可擴展的計算模型。攻讀博士期間,他與謝思寧合作,後者後來成為Yann LeCun旗下AMI Labs的聯合創始人兼首席科學家。
畢業後,李加入 NVIDIA 擔任
擔任視覺與機器人學組的研究科學家,期間從事自主機器人領域的基礎模型與數位孿生相關研究。他是 2024 年全球僅有十位獲選的 NVIDIA 研究生獎學金得主之一,並在任職期間申請了四項美國專利。 2026年3月,他返回中國,加入清華大學人工智慧學院擔任助理教授。一個月後,即2026年4月,他創立了「麗清智能」。融資情況
成立僅兩個月內,利清智能便完成了多輪融資,共籌得數億元人民幣的種子輪資金。投資者名單堪稱中國頂尖風險投資機構的「名人錄」: 紅杉資本中國、GL Ventures(高瓴資本的早期投資部門)、順維資本(雷軍的基金)、Frees Fund、Starlink Capital、水木清華校友種子基金,以及SEE FUND。 值得注意的是,本輪融資還吸引了戰略產業投資者參與:AgiBot(中國領先的具身人工智慧公司之一)、Linker Hand(靈巧機械手製造商)以及世紀黃金資源。 AgiBot 同時以投資者與潛在客戶的身分參與本輪融資,這顯示 Liqing 的基礎設施可能成為現有機器人硬體公司的訓練骨幹。
技術架構:物理 AI 基礎設施
李一明的核心論點是:僅憑世界模型是不夠的。 在 2026 年 7 月接受 36Kr 採訪時,他援引唐代小說《長安荔枝》中的比喻:要將新鮮的荔枝從廣東運送到首都,不僅需要一匹快馬,還需要一套完整的保鮮系統、中轉站、路線規劃以及供應物流體系。 他以此類比指出,世界模型「僅是那匹馬」,若缺乏周遭的數據收集、物理模擬及部署回饋迴路等基礎設施,便毫無價值。
李青的系統包含
三項自主研發的組件。第一項是專屬的數據管道,旨在將數據收集規模從業界平均的數十萬小時,擴展至數百萬或數千萬小時。 該公司自主研發了觸覺手套與穿戴式感測器,將每單位的資料蒐集成本從美元級別降至人民幣級別,使工廠、飯店及廚房的人類工作者僅需執行日常工作,即可大規模產生訓練資料。第二項組件是具備可微分能力的物理引擎,實現了「實機→模擬→實機」的閉環流程。此引擎能模擬包括流體、軟體以及處於彈性或塑性變形狀態的物體在內的複雜材料,使機器人能在實際操作前,先透過模擬進行切割、攪拌、穿線和傾倒等任務的練習。 該公司聲稱,透過將物理引擎中的狀態轉換與少量真實世界數據對齊,他們僅需競爭對手所需真實機器人數據的 1%,即可達到相當的任務成功率。
第三個組成部分是環境模型本身,它具有雙重作用:既是自監督預訓練的目標(同時建模狀態與動作),也是後訓練階段強化的互動環境。 據報導,該公司的視覺標記器(可將物理世界觀察結果轉換為機器可讀的表示形式)表現已超越 Meta 的 DINOv3 基礎模型。
全球競爭格局:李青的定位
2026 年的世界模型領域競爭激烈、資金充沛且全球佈局廣泛。要理解 Liqing 的定位,可根據資金規模、技術成熟度及商業部署等三個層級來劃分該領域。
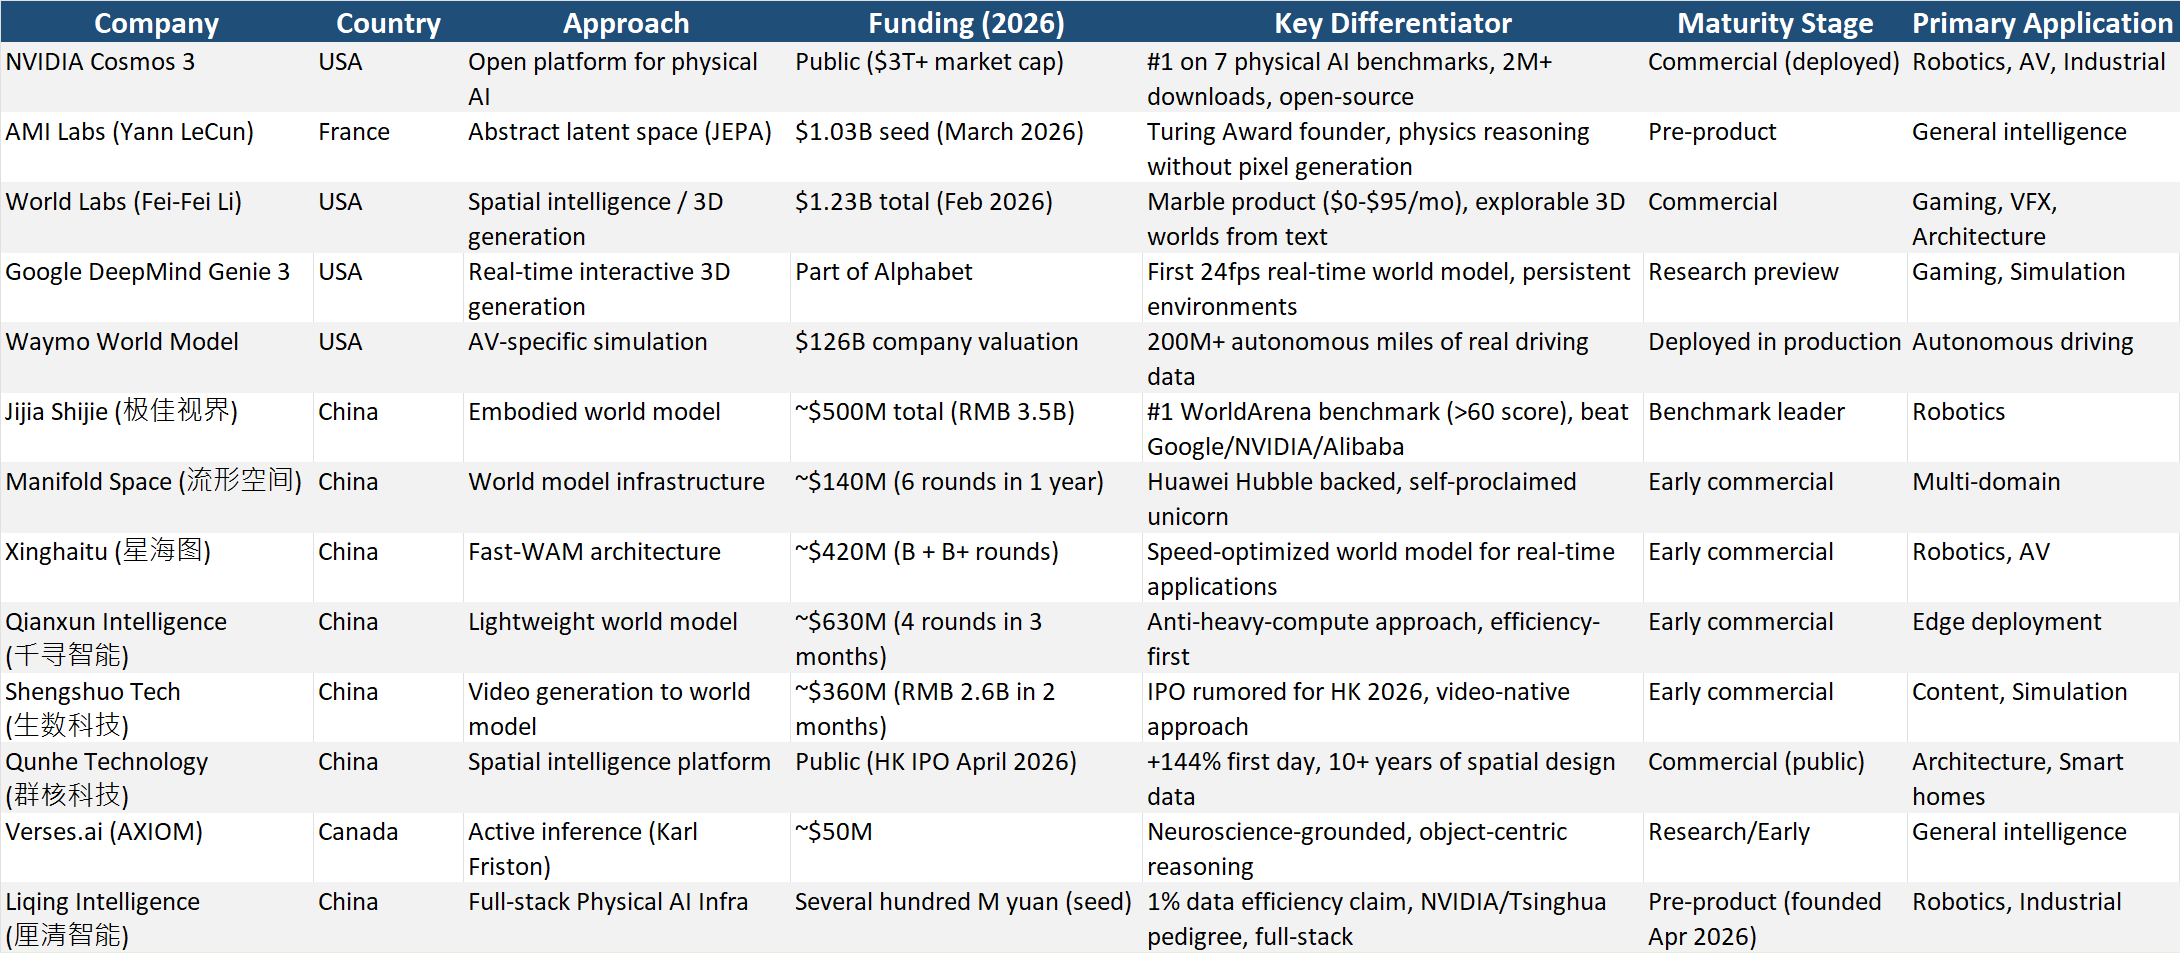
李一明為何認為競爭對手並未建構「原生」世界模型
在一次訪談中,李一明針對世界模型領域的三種主流方法提出了尖銳批評,並主張其中沒有任何一種能被視為具備端到端物理智能能力的「原生世界模型」。
關於谷歌及數家中國新創公司所採用的 VLA(視覺-語言-動作)模型,李一明認為語言本質上是一種溝通介面,而非理解物理世界的表徵方式。「語言是一個高度離散化的空間,」他表示。 「每個國家都有不同的語法規則,語言充滿了人類的偏見,而且許多事物根本無法用言語表達。語言的存在是為了人類之間的溝通,而非作為物理世界的原生表徵。」
關於 Yann LeCun 的 JEPA 架構——AMI Labs 正憑藉超過 10 億美元的資金將其商業化——李承認其設計精妙,但指出一個關鍵限制:「JEPA 可以預測狀態,卻無法輸出動作。」一個能理解將發生什麼事、卻無法決定該如何行動的系統,對於機器人技術的部署而言仍是不完整的。
關於影片生成模型(包括源自 Sora、Runway 及數家中國影片 AI 公司的方法),李同樣直言不諱:「影片生成模型只能擬合世界的表層外觀。 它們無法保證複雜任務學習所需的幾何與物理一致性。」一段生成的影片在人類觀眾眼中或許看起來在物理上合乎邏輯,但其中可能包含違背物理定律的元素,這將導致以此訓練的機器人在現實世界中遭遇災難性的失敗。
李青提出的替代方案,李稱之為『原生世界』
該「模型」將感知、推理、決策與動作輸出整合為單一架構,並針對實體互動進行端到端訓練。由於該公司尚未公布比較結果,此說法能否經得起基準測試的考驗,仍有待觀察。這對機器人技術的普及意味著什麼
世界模型代表了人工智慧與實體部署之間關鍵的缺失層。若無此模型,每台機器人都必須透過昂貴的實境試錯過程從頭學起;有了它,單一的訓練投資在理論上可擴展至無限的硬體平台、環境與任務。 此處刻意將其比喻為作業系統:正如 iOS 讓數百萬個應用程式能在標準化硬體上運行,成熟的「物理 AI 基礎設施」也能讓數百萬種機器人技能得以開發、測試與部署,而無需針對每個任務進行實體數據蒐集。
2026年上半年,該領域的資金集中度極為驚人。 僅中國的「世界模型」新創公司,今年上半年就已吸引超過 150 億人民幣(約 21 億美元)的資金;若將 AMI Labs、World Labs 以及 NVIDIA 的 Cosmos 生態系統投資納入計算,全球總額更超過 40 億美元。 這種資本密集度表明業界共識已發生轉變:世界模型不再是研究領域的奇聞軼事,而是可擴展機器人部署的先決條件。
就麗清智能而言,真正的考驗將出現在2026年底——李毅明已承諾屆時將為企業客戶推出一款跨場景的世界模型。 若該公司聲稱「僅需競爭對手1%的真實世界數據即可達到同等效能」的說法在生產環境中成立,這將代表訓練效率上的真正突破。若不然,它將加入那長長的名單——那些資金雄厚但技術主張超前於實際成果的新創公司行列。
其交付時程。李為大規模商業部署所設定的 2028 年里程碑,將是決定性的考驗。消息來源:
3. Tech in Asia:順為資本、紅杉中國投資人工智慧新創公司「李清」(2026年7月1日)
4. 紐約大學坦登工程學院:NVIDIA 表彰博士候選人李義明(2023年12月)
6. TMTPost:AI新銳企業齊聲押注「世界模型」(2026年6月23日)
8. NVIDIA 新聞室:Cosmos 3 正式推出(2026年6月)
9.
Waymo 部落格:Waymo 世界模型(2026 年 2 月)主圖:NVIDIA Cosmos 世界基礎模型平台視覺化圖像。來源:NVIDIA 新聞室(公開可用的新聞素材)。選用此圖是因為 NVIDIA Cosmos 體現了本文核心的世界模型基礎設施概念,且創辦人李一明與 NVIDIA 存在直接的專業關聯。
免責聲明:本文僅供參考,不構成投資建議。文中資訊基於公開來源,可能未能反映最新發展動態。讀者應在做出任何投資或商業決策前自行進行研究。











