
每週科技回顧:資料蒐集的瓶頸
機器人產業的技術重心已從硬體設計轉向資料擷取。隨著 Maniformer 等專用的實體人工智慧資料服務平台,以及新型具身整合開發環境的出現,該產業已逐漸意識到,高品質的真實世界人類示範資料,正是自主能力的最終限制因素。
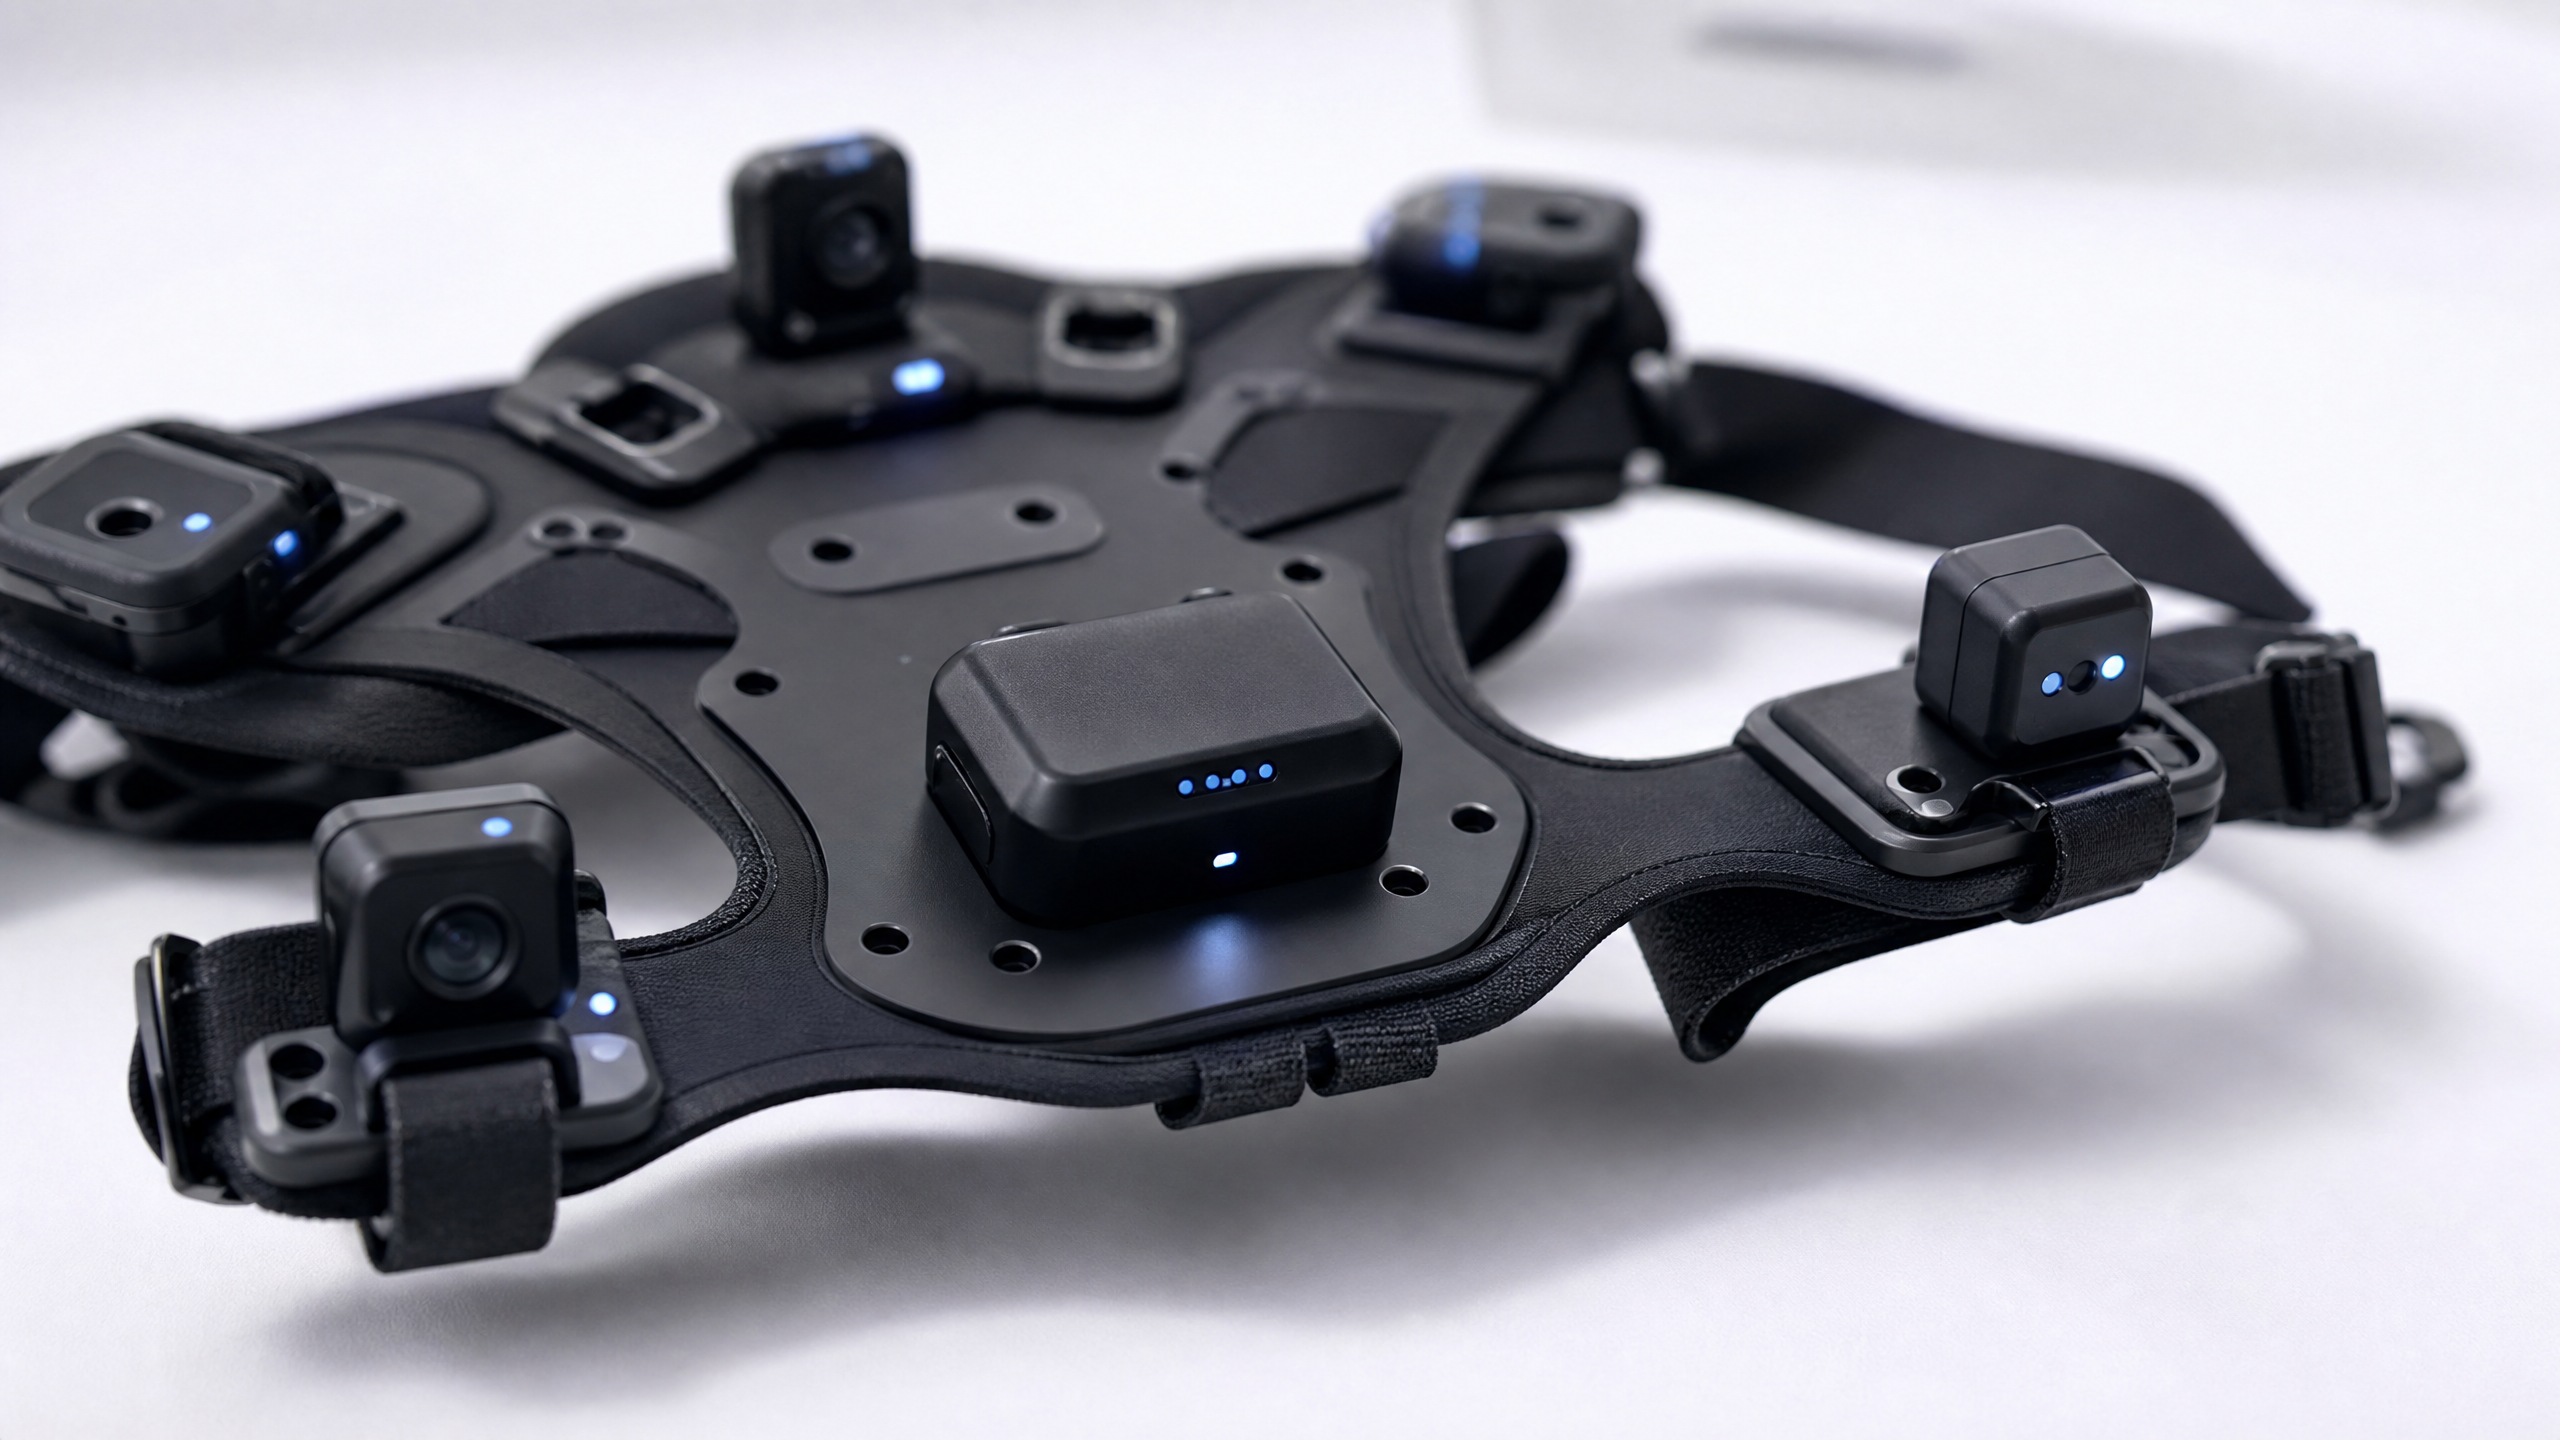
機器人產業的技術重心已從硬體設計轉向資料擷取。隨著 Maniformer 等專用的實體人工智慧資料服務平台,以及新型具身整合開發環境的出現,該產業已逐漸意識到,高品質的真實世界人類示範資料,正是自主能力的最終限制。
過去十年間,機器人產業一直依賴模擬技術來訓練自主系統,其運作基礎是假設虛擬環境終將能重現實體世界的複雜性。2026年8月的第一週,這項假設在複雜操作任務方面徹底崩潰。 這項結構性觀察是不容否認的:模擬數據已達極限,特別是在零售和居家空間等非結構化環境中。新的技術瓶頸並非推理模型或物理致動器,而是如何取得高品質且經授權的真實世界互動數據。
這項轉變在上海得以具體展現:一家名為 Maniformer 的公司開始在實際營運中的便利商店和超市內,展開由人員執行數據蒐集的作業。 Maniformer 作為實體人工智慧數據服務平台,捕捉人類工作者執行補貨、商品陳列及與顧客互動等任務時,時間同步的多模態數據。這些工作者身上裝設了感測裝置,用以記錄他們在實境零售賣場這個雜亂且不可預測的環境中移動時,精確的運動軌跡、視覺輸入及觸覺反饋。
技術譯者深知,這代表著機器智能建構方式的根本性轉變。企業不再試圖將塑膠袋的物理特性或玻璃瓶的摩擦力編程到模擬引擎中,而是直接記錄人類在現實中與這些物體互動的過程。這種方法繞過了
徹底彌合模擬與現實之間的鴻溝,並將物理互動的真實數據餵入基礎模型。在機器人領域,戰略優勢不再屬於擁有最佳模擬引擎的公司,而是屬於掌控最全面且實用之真實世界數據迴路的公司。隨著焦點轉向資料蒐集,處理與部署這些資料所需的基础設施正迅速成熟。 在北京,以「Booster」為品牌營運的 Acceleration Evolution 宣布,已出貨超過 1,000 台 K1 類人型機器人,主要供應至各大大學校園。關鍵的是,該公司同時推出了「Booster Studio」——一個專為具身人工智慧設計的一體化整合開發環境。
Booster Studio 旨在標準化機器人領域的軟體工作流程,為開發者提供一套用於資料處理、模型訓練及硬體部署的統一工具鏈。 長期以來,由於缺乏標準化的開發環境,機器人公司被迫為每個新的硬體平台打造量身訂製的軟體堆疊,這在開發週期中造成了巨大的阻力。透過提供全面的整合開發環境,Booster 試圖降低軟體工程師的入門門檻,使他們能夠像目前開發行動應用程式那樣輕鬆地為實體機器人開發應用程式。
隨著軟體層的標準化,硬體元件也正朝專業化方向發展。8月7日,GigaDevice 推出了兩款專為類人型機器人與機器狗量身打造的新型微控制器。這些晶片旨在為複雜的驅動系統提供工業級安全性、低功耗以及精確的時序控制。 GigaDevice 預測,到 2026 年,全球市場對這類專用微控制器單元的需求將超過 1,000 萬顆,並指出單台類人型機器人
通常需要約 60 顆晶片來控制其各個關節和感測器。硬體堆疊的專業化正超越機器人本身,延伸至支撐其運作的運算基礎架構。 一項彰顯實體人工智慧極高運算需求的進展是,SpaceX 宣布與 NVIDIA 建立獨家合作夥伴關係,共同開發 Starmind AI1 衛星。這顆衛星旨在直接於低地球軌道處理人工智慧工作負載,透過專用的 NVIDIA 模組提供龐大的運算效能,同時避免將資料傳回地面資料中心時固有的延遲。
儘管軌道運算看似與地面機器人技術毫無關聯,但它卻能解決在偏遠或爭奪激烈環境中運作的自主系統所面臨的關鍵問題。 部署於農業、採礦或國防領域的機器人,往往缺乏將複雜推理任務卸載至雲端伺服器所需的可靠、高頻寬連線能力。透過將運算基礎設施部署於軌道上,SpaceX 與 NVIDIA 正致力於打造一個無所不在、低延遲的認知層,以支援地球上任何地點的自主運作。
實境資料蒐集、標準化開發環境、專用微控制器與軌道運算基礎設施的融合,顯示機器人產業終於正在建構實現規模化所需的基礎層級。 量身訂製、手工打造的機器人原型時代正在落幕。取而代之的是一套工業化技術堆疊:數據如同原材料般被蒐集,透過標準化的軟體管道進行處理,並由商品化的硬體元件執行。
由於各層之間相互強化,這股工業化的步伐正不斷加速。更優質的數據蒐集能產生更優秀的基礎模型,這些模型又需要更專業化的硬體,而這又需要更多
標準化的開發工具,進而使資料蒐集速度加快。這個良性循環解釋了為何與前幾年相比,2026 年實體人工智慧的進展步伐大幅加快。 各項組成元件其實早已存在;真正的新穎之處在於將這些元件整合成一套連貫且能自我強化的技術堆疊,並可於工業規模上部署。由 Maniformer 等公司所建構的數據基礎設施,直接饋入最終將主導自主系統的基礎模型。本週,Google 證實 Gemini Robotics ER 2 是其迄今為止功能最強大的具身推理模型,而安川電機(Yaskawa)已將其部署於工業機器人中。 與此同時,NVIDIA 以寬鬆的開放商業授權釋出 Alpamayo 2 Super,其提供的尖端自動駕駛推理能力,在 LingoQA 基準測試中,於近 40 個受評模型中名列榜首。
這些發布的匯聚表明,實體人工智慧的基礎模型層正迅速成熟。競爭已不再僅限於少數幾個進行概念驗證演示的研究實驗室之間;而是轉變為在真實工業環境中部署的、已具備量產能力的模型之間的競爭。 NVIDIA 模型的開放授權尤為重要,因為它允許任何硬體製造商無需支付每單位授權費,即可整合前沿推理能力。這使得認知層商品化,並將競爭優勢重新轉移回資料收集與硬體整合層。
對技術譯者而言,其影響顯而易見:實體人工智慧的價值鏈正在逆轉。基礎模型正變得唾手可得,硬體正趨於商品化,而連接兩者的稀缺資源則是高品質、領域專用的數據。掌控數據管道的企業,
無論是透過上海超市中配備感測器的店員,還是學術會議上佩戴的可穿戴感測裝置,這些人將掌握由自主系統(這些系統消耗著他們的數據)所創造的大部分經濟價值。這場轉型的現實並非體現在潔淨無瑕的實驗室中,而是在上海某間超市狹窄的走道裡。 一名人類工作者佩戴著能追蹤雙手與雙眼每個細微動作的感測器裝置,伸手將貨架上的一排塑膠瓶排列整齊。數據悄然流向伺服器,捕捉摩擦與重量的細微物理特性,將執行這項平凡任務所需的人類直覺數位化,並餵養那台終將取代他們位置的機器。













