
每周科技回顾:数据采集的瓶颈
机器人行业的技术重心已从硬件设计转向数据采集。随着Maniformer等专门的物理人工智能数据服务平台以及新型具身集成开发环境的出现,该行业已认识到,高质量的真实世界人类演示数据是自主能力的最终制约因素。
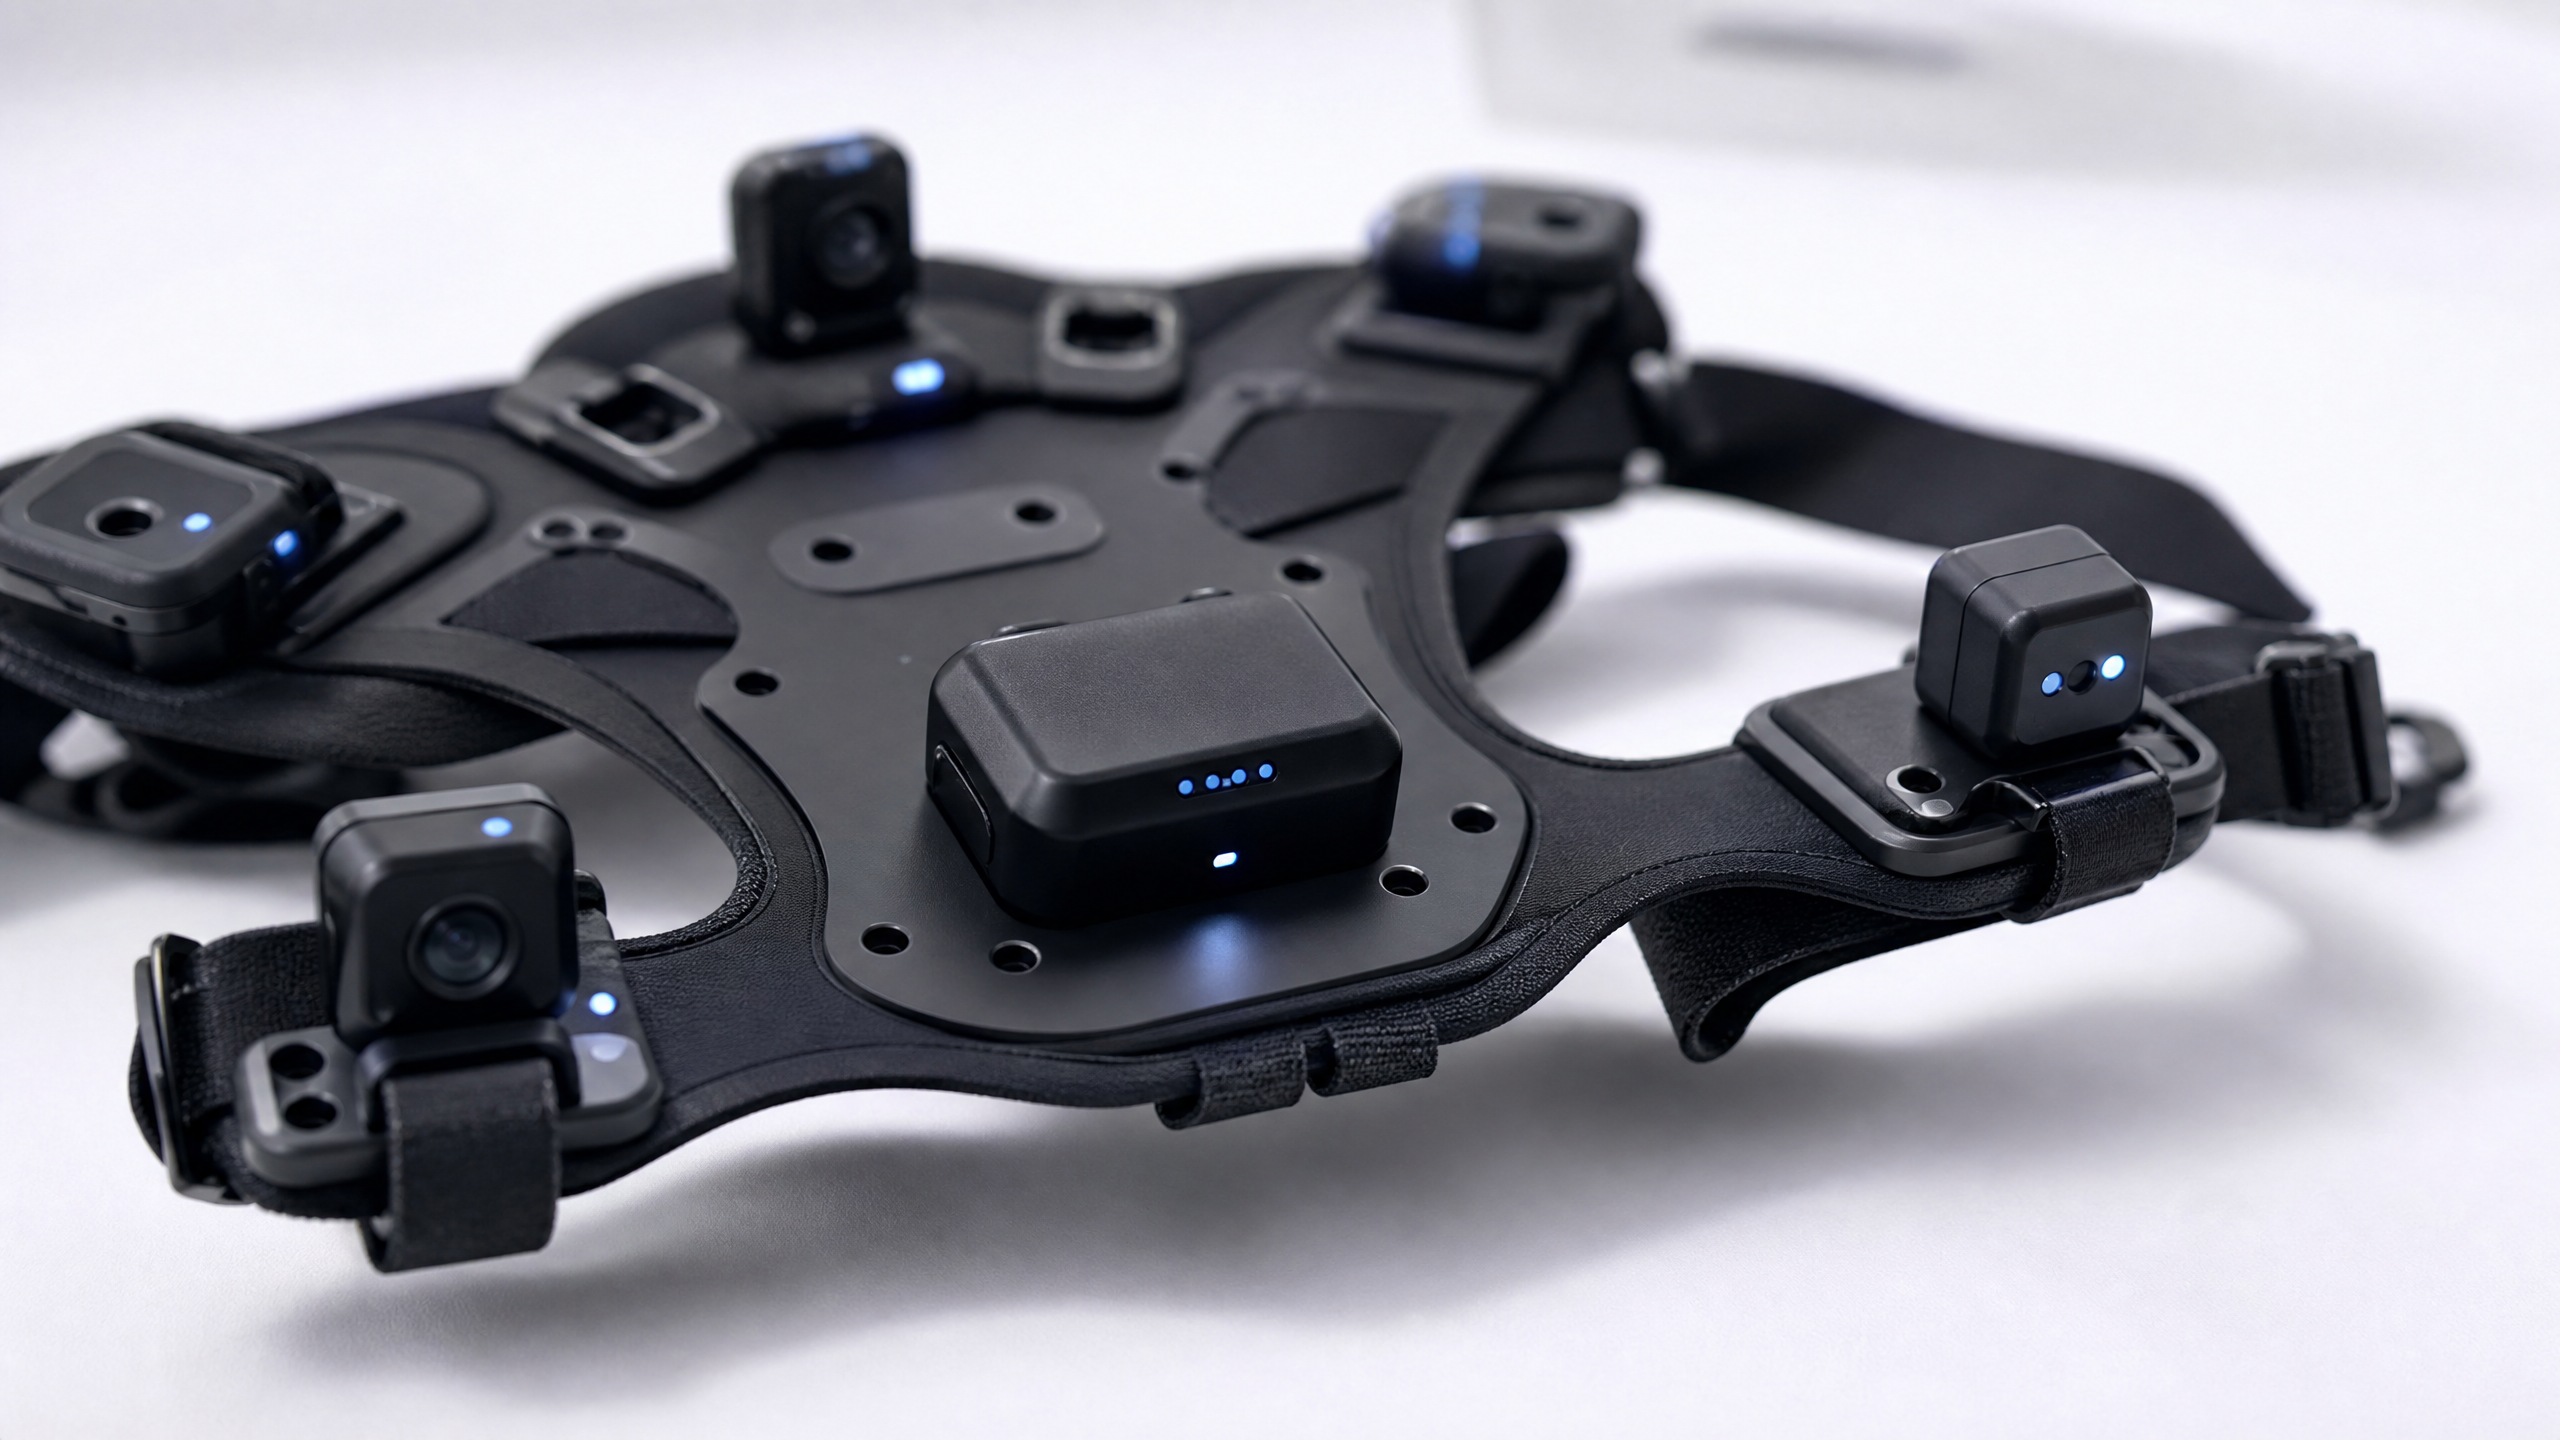
机器人行业的技术重心已从硬件设计转向数据采集。随着Maniformer等专用物理人工智能数据服务平台以及新型具身集成开发环境的出现,该行业逐渐认识到,高质量的现实世界人类示范数据是自主能力的最终制约因素。
过去十年间,机器人行业一直依赖模拟技术来训练自主系统,其运作基于这样一种假设:虚拟环境最终能够再现物理世界的复杂性。2026年8月的第一周,这一假设在复杂的操作任务中彻底破产。 这一结构性观察是不容置疑的:模拟数据已达到极限,特别是在零售和家庭空间等非结构化环境中。新的技术瓶颈并非推理模型或物理执行器,而是获取高质量、经授权的真实世界交互数据。
这一转变在上海得以体现:一家名为Maniformer的公司开始在正常营业的便利店和超市内开展由人工参与的数据采集业务。 Maniformer作为一家实体人工智能数据服务平台,采集人类员工在执行补货、商品陈列和与顾客互动等任务时的时间同步、多模态数据。工作人员身上安装了传感器,在穿梭于真实零售卖场杂乱且不可预测的环境时,记录其精确的运动轨迹、视觉输入和触觉反馈。
技术翻译人员深知,这标志着机器人智能构建方式的根本性变革。企业不再试图将塑料袋的物理特性或玻璃瓶的摩擦力编程到模拟引擎中,而是直接记录人类在现实中与这些物体互动的过程。这种方法绕过了
彻底弥合模拟与现实之间的鸿沟,向基础模型输入物理交互的真实数据。在机器人领域,战略优势不再属于拥有最佳模拟引擎的公司,而是属于掌控最全面、最有用的现实世界数据循环的公司。随着关注点转向数据采集,处理和部署这些数据所需的基础设施正在迅速成熟。 在北京,以“Booster”为品牌运营的Acceleration Evolution公司宣布,已向大学校园等地交付了1,000多台K1人形机器人。关键的是,该公司同时推出了Booster Studio——一个专为具身人工智能设计的一体化集成开发环境。
Booster Studio旨在标准化机器人领域的软件工作流,为开发者提供用于数据处理、模型训练和硬件部署的统一工具链。 长期以来,由于缺乏标准化的开发环境,机器人公司被迫为每个新的硬件平台构建定制化的软件栈,这给开发周期带来了巨大的阻碍。通过提供一个全面的集成开发环境,Booster正致力于降低软件工程师的入门门槛,使他们能够像开发移动应用程序一样轻松地为实体机器人构建应用程序。
软件层的标准化正与硬件组件的专业化相辅相成。8月7日,GigaDevice推出了两款专为人形机器人和机器人狗量身定制的新型微控制器。这些芯片旨在为复杂的执行系统提供工业级安全性、低功耗以及精确的时序控制。 GigaDevice预测,到2026年全球市场对这类专用微控制器单元的需求将超过1000万个,并指出单个人形机器人
通常需要大约60个芯片来控制其各个关节和传感器。硬件堆栈的专业化正超越机器人本身,延伸至支撑其运行的计算基础设施。 SpaceX 宣布与 NVIDIA 建立独家合作伙伴关系,共同开发 Starmind AI1 卫星,这一举措充分体现了物理人工智能对计算能力的极高需求。该航天器旨在直接在近地轨道上处理人工智能工作负载,利用专门的 NVIDIA 模块提供强大的计算性能,同时避免了将数据传输回地面数据中心时固有的延迟。
尽管轨道计算看似与地面机器人技术毫无关联,但它却解决了在偏远或冲突环境中运行的自主系统所面临的关键问题。 部署在农业、采矿或国防领域的机器人往往缺乏将复杂推理任务卸载至云服务器所需的可靠、高带宽连接。通过将计算基础设施部署在轨道上,SpaceX和英伟达正致力于构建一个无处不在、低延迟的认知层,以支持地球上任何地点的自主操作。
现实世界数据采集、标准化开发环境、专用微控制器以及轨道计算基础设施的融合表明,机器人行业终于正在构建实现规模化所需的基础层。 量身定制、手工打造的机器人原型时代正在落幕。取而代之的是一套工业化技术栈:数据如同原材料般被采集,通过标准化的软件管道进行处理,并由商品化的硬件组件执行。
这种工业化的速度正在加快,因为各层之间形成了相互强化。更好的数据采集能产生更优质的基线模型,这些模型又需要更专业的硬件,进而要求更多
标准化的开发工具,进而加快了数据收集的速度。这一良性循环解释了为何与前几年相比,2026年物理人工智能的发展步伐大幅加快。 这些组件本身已存在一段时间;真正的新突破在于将它们整合成一个连贯且具有自我强化效应的技术栈,并能实现工业规模的部署。Maniformer 等公司正在构建的数据基础设施,直接为最终将主导自主系统的基础模型提供支持。本周,谷歌确认 Gemini Robotics ER 2 是其迄今为止功能最强大的具身推理模型,安川电机已将其部署在工业机器人中。 与此同时,英伟达(NVIDIA)在宽松的开放商业许可下发布了Alpamayo 2 Super,该模型提供了前沿级别的自动驾驶推理能力,在LingoQA基准测试中,其在近40个受评模型中排名第一。
这些发布的汇聚表明,物理人工智能的基础模型层正在迅速成熟。竞争已不再局限于少数几个进行概念验证演示的研究实验室之间,而是转向了已在真实工业环境中部署的、具备量产能力的模型之间。 英伟达模型的开放许可尤为重要,因为它允许任何硬件制造商在无需支付单件许可费的情况下集成前沿推理能力。这使得认知层商品化,并将竞争优势重新转向数据采集和硬件集成层。
对于技术翻译人员而言,其影响显而易见:物理人工智能的价值链正在发生逆转。基础模型正变得免费可用,硬件正在商品化,而连接两者的稀缺资源则是高质量的、领域特定的数据。那些掌控数据管道的公司,
无论是上海超市中配备传感设备的员工,还是学术会议上佩戴可穿戴传感设备的人员,都将获取由消耗其数据的自主系统所创造的大部分经济价值。这种转型的现实并非体现在洁净的实验室中,而是在上海某家超市狭窄的过道里。 一名佩戴着传感器装置的工人——该装置能追踪其双手和眼睛的每一个细微动作——伸手将货架上的一排塑料瓶排列整齐。数据悄无声息地流向服务器,捕捉着摩擦与重量的微妙物理特性,将完成这项平凡任务所需的人类直觉数字化,并输入到最终将取代他们位置的机器中。













