
一款「晶片中立」的推論引擎,剛將機器人的反應時間縮短了 90%
Infinigence AI、清華大學和上海交通大學共同開源了 APXInf,這是一款能在 NVIDIA Jetson Thor 晶片上將機器人控制延遲降低 90% 的推論引擎。

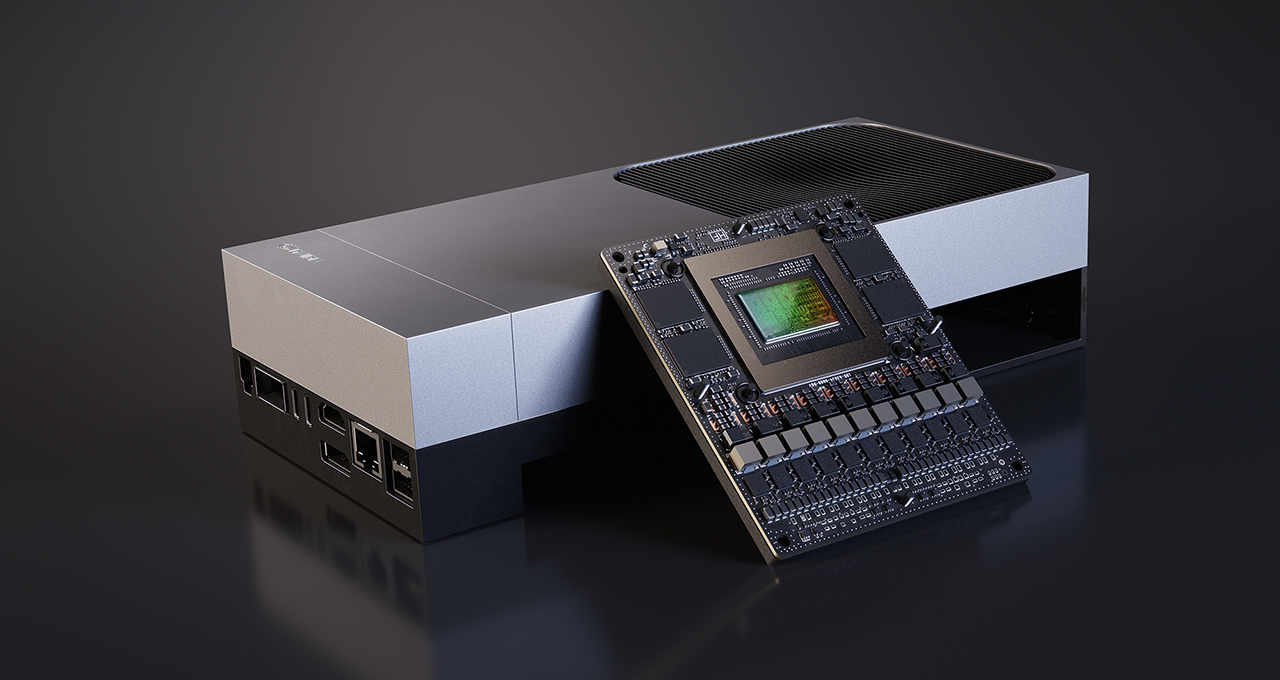
Infinigence AI 週一與清華大學及上海交通大學合作,開源了一款推論引擎,該引擎將機器人將視覺-語言-動作模型的決策轉化為實際肢體動作所需的時間,從 278 毫秒大幅縮短至 26 毫秒以下;這三所機構表示,此十倍的效能提升,消除了體現式人工智慧示範與能實際完成整班工作的機器人間,最後幾個未解決的瓶頸之一。 這款名為 APXInf 的引擎可從 GitHub 免費下載並修改,並已支援兩種業界廣泛使用的視覺-語言-動作模型——Physical Intelligence 的 Pi 0.5 以及 X Square Robot 的 WALL-OSS——且適用於以下三種硬體平台: NVIDIA 的 RTX 4090、Jetson Orin 以及 Jetson Thor 晶片。 該引擎在 FP8 精度下具備 38.46 赫茲的推論頻率,運行速度已足以支援機器人行走、抓取及修正路線所需的連續即時控制迴路,並消除那種明顯的卡頓現象——正是這種卡頓,使得許多具身人工智慧示範在舞台上看似令人印象深刻,但在工廠車間卻顯得不可靠。
Infinigence AI 由清華大學電子工程系分拆出的團隊於 2023 年在北京創立,由王宇教授領軍,已從包括騰訊、百度、 聯想及小米等投資者處於22億元人民幣(約合3.23億美元)以上,該公司定位為基礎設施公司,專注於優化大型AI模型在硬體上的實際運行方式,而非自行構建模型。這種定位對於理解APXInf存在的意義至關重要:Infinigence並未試圖在模型能力上超越Physical Intelligence或X Square Robot。 它試圖解決的是更狹窄、也較不引人注目的問題:當一個功能強大的模型被部署到一台機器人上後會發生什麼事?這台機器人的運算預算僅為資料中心的零頭,功耗受限,且無法容忍雲端聊天機器人使用者所經歷的那種延遲
根本不會察覺。為何幾百毫秒會讓機器人失靈,卻不會影響聊天機器人
APXInf 針對的特定故障模式,是任何評估具身人工智慧供應商實際部署準備度的買家,在簽署部署合約前都應理解的關鍵點。對於在聊天視窗中輸入文字的人來說,一個需要額外 300 毫秒才能回應的雲端語言模型,所產生的延遲根本難以察覺。 然而,若機器人的控制迴路需要額外 300 毫秒才能將決策轉化為關節動作,所產生的正是那種斷續、 不連續的動作,這不僅會讓示範看起來未臻完善,更嚴重的是,當夾爪在移動物體上閉合的時間晚了幾分之一秒時,甚至可能導致多步驟操作任務徹底失敗。 Infinigence 對此問題的獨特詮釋是:一個在雲端運行良好的模型,一旦部署到實體機器人上,便會面臨完全不同的問題——無論是能否瞬間啟動、能否從有限的機載晶片中榨取每一單位可用運算能力, 延遲是否能維持在足夠低的水平以避免成為瓶頸,以及在開發環境中運作無懈可擊的模型,在持續運作中是否仍能保持穩定——這套論述精準地描述了實驗室成果與可部署產品之間的鴻溝,而這道鴻溝在過去兩年裡已使多個類人型及工業機器人計畫陷入停滯。
APXInf 針對此差距的解決方案,並非仰賴單一的演算法技巧,而是基於三項工程設計抉擇。速度的提升源自於對模型處理流程的端到端優化, 運算圖以及個別核心運算的端到端優化,並結合團隊稱為「Agent4Kernel」的自訂融合運算子技術;而非僅針對單一模型運算進行孤立優化。正因如此,所達成的 10.7 倍延遲降低幅度,才是完整的循環運行數據,而非僅從單一處理階段精挑細選而來的基準測試結果。 穩定性則源自以 Rust 語言編寫的輕量級執行環境,以及一套系統級
這是一種專為其記憶體安全性保證而選用的程式語言,並以 Python 介面封裝,使非系統程式設計師出身的機器人開發人員也能輕鬆使用此工具;這種組合旨在防止記憶體洩漏、競態條件以及不可預測的當機——這些問題往往會在工作班次進行數小時後,而非初始測試階段,導致機器人的控制系統癱瘓。 第三項特性,團隊稱之為「敏捷性」,採用其所謂的「代理工程方法」,讓新的視覺-語言-動作模型能更快地整合至引擎中。這是一項明確的賭注:新具身模型的發布速度將持續加速,而鎖定於當今模型架構的推論引擎,將在一年內變得過時。基準測試數字背後的生態系統佈局
APXInf 並非以獨立專案的形式出現。它是對現有開源框架 RLinf 的延伸,該框架由 Infinigence 與清華大學於 2025 年 9 月發布,據團隊描述,這是首個專為訓練後具身 AI 模型打造的大規模強化學習框架。 該早期版本負責建構具身模型的訓練與評估環節;而 APXInf 則負責部署環節,為開發者提供一條從模型訓練、行為驗證,到在實體機器人機載晶片上運行的一體化、連續的開源管道。 對於正在評估其具身 AI 技術堆疊應「自建」或「採購」的機器人新創公司或工業自動化買家而言,這種端對端的連續性無疑比任何單一基準測試數值都更具意義,因為它降低了切換與整合成本——這些成本目前迫使許多機器人團隊不得不將各自獨立且不相容的訓練與部署工具拼湊在一起。
Infinigence 在發布時同步公布的路線圖進一步強調,此平台旨在成為基礎架構,而非一次性研究發布。該團隊表示
該公司已著手調整 APXInf,使其支援更多模型系列,包括阿里巴巴的「Qwen」和 NVIDIA 的「Groot」,以及更廣泛的視覺-語言模型與世界模型類別;同時,該公司亦承諾將硬體支援範圍從 NVIDIA 的晶片產品線擴展至中國本土晶片、本土機器人作業系統,以及 AMD 的處理器。 這種多晶片策略,正是為了直接對沖出口管制與供應鏈不確定性所帶來的風險——正是這些因素促使眾多中國人工智慧基礎設施公司開發硬體中立的工具,而非將公司的技術堆疊押注於單一晶片供應商的持續供應能力上。 如今,若機器人買家以 Pi 0.5 或 WALL-OSS 為核心制定部署計畫,便能獲得一款已可在主流 NVIDIA 硬體上運行的工具,且該工具明確承諾具備可移植性——即使未來因地緣政治或供應限制而被迫更換硬體。為何 Infinigence 選擇招募貢獻者而非出售授權
Infinigence 已明確將此次首發版本定位為起點而非成品,並正積極徵求外部貢獻者, 已將 Pi 0.5 整合至 Jetson 級硬體的機器人團隊、從事 RTX 4090 或 Orin 專案的開發者,以及任何正在為新型具身模型建構部署流程的人士,邀請他們直接在 GitHub 儲存庫中提交問題與程式碼變更。這種開放貢獻的姿態,是經過深思熟慮的戰略選擇,而非單純的禮節性舉動。 推論引擎的長期價值,取決於其實際經過多少種硬體配置、模型架構及邊緣案例的測試;而面對發展如此迅速的機器人產業,Infinigence 無法在內部驗證未來一年內可能產生的所有晶片、模型與任務組合。 透過開放貢獻來群眾外包這項驗證工作,正是讓 PyTorch 和 Hugging Face 的 Transformers 等框架成為產業標準的相同策略
這遠遠超出了其原始開發者單憑一己之力所能測試的範圍,相較於封閉且受供應商鎖定的替代方案,這對成為預設基礎設施而言,是一項更具說服力的長期投資。這對評估具身人工智慧供應商的團隊意味著什麼
對任何買家或系統整合商而言,真正的實務考驗不在於 APXInf 的基準測試數據能否在 Infinigence 自身的測試中成立, 而是這些數值能否在特定設施中,由執行特定任務的特定機器人上得到驗證,因為推論引擎的性能聲稱歷來都極易受團隊所測量之模型變體、量化等級及工作負載模式的影響。FP8 精確度, 正是那項標榜「26 毫秒」的數字背後所採用的設定,這種設定是以犧牲部分數值精確度來換取速度;採購團隊應要求任何推銷基於 APXInf 部署方案的供應商,在實際應用所需的精確度層級下,展示相同的延遲與穩定性數據,而非將最佳情況下的 FP8 數值視為適用於所有配置的保證。 這項提醒並非貶低其根本成就,而是界定了嚴謹的買家在確定生產時程表之前,必須獲得解答的具體盡職調查問題。
這次開源發布所立即改變的,是實驗的成本。 在 APXInf 問世之前,若機器人團隊希望在 Jetson Thor 上以生產級延遲運行 Pi 0.5 或 WALL-OSS,必須具備兩項條件之一:要麼擁有能夠從零開始構建同等優化堆疊的內部系統工程人才;要麼與已內部解決該問題的供應商建立付費合作關係。 由 Infinigence、清華大學及上海交通大學針對兩種廣泛使用的模型進行驗證,並已證實有效的免費開源引擎,消除了這道障礙,讓過去因無法負擔系統工程投資而難以將高效能模型從研究原型轉化為實際運作機器人的小型機器人新創公司與大學實驗室,如今得以實現此目標。
能夠一小時又一小時地穩定執行任務,無需工程師在旁待命以重新啟動系統。試想實際應用中的差異:一家擁有三名工程師、僅配備一套 Jetson Thor 開發套件的倉儲自動化新創公司,現在只需克隆一個 GitHub 儲存庫、載入 Pi 0.5 系統,便能在一個下午內,看著機械手臂的取放循環從明顯遲滯的四分之一秒延遲,轉變為流暢連續的動作, 這道差距,正是過去區分「前景看好的研究原型」與「值得投資的產品」的關鍵。
本分析基於 Infinigence AI、清華大學及上海交通大學所發布的公開開源版本與技術文件,其中闡述了 APXInf 引擎的運作原理。本文僅供一般資訊參考,不構成任何投資、財務或法律建議。
首圖來源:NVIDIA。













