
Eine chipunabhängige Inferenz-Engine hat die Reaktionszeit von Robotern gerade um 90 Prozent verkürzt
Infinigence AI, die Tsinghua-Universität und die Shanghai Jiao Tong-Universität haben APXInf als Open-Source-Software veröffentlicht – eine Inferenz-Engine, die die Latenz bei der Robotersteuerung auf dem Jetson Thor-Chip von NVIDIA um 90 Prozent reduziert.

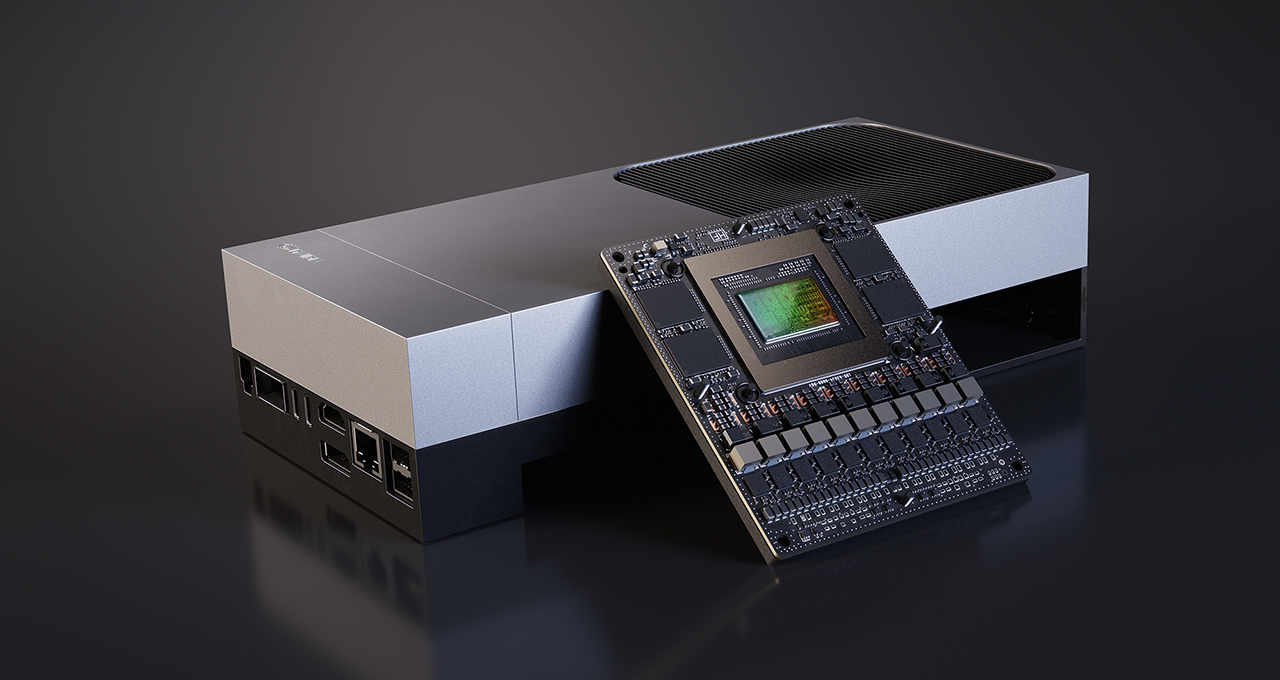
Infinigence AI hat in Zusammenarbeit mit der Tsinghua-Universität und der Shanghai Jiao Tong-Universität am Montag eine Inferenz-Engine als Open-Source-Software veröffentlicht, die die Zeit, die ein Roboter benötigt, um die Entscheidung eines Bild-Sprache--Aktions-Modell in eine physische Bewegung umsetzt, von 278 Millisekunden auf unter 26 Millisekunden auf der NVIDIA Jetson Thor-Hardware verkürzt – eine zehnfache Reduzierung, die nach Angaben der drei Institutionen einen der letzten ungelösten Engpässe beseitigt, die zwischen Demonstrationen verkörperter KI und Robotern stehen, die tatsächlich eine volle Schicht arbeiten können. Die Engine mit dem Namen APXInf kann kostenlos von GitHub heruntergeladen und angepasst werden. Sie unterstützt zwei bereits in der Industrie weit verbreitete Vision-Sprache-Aktion-Modelle – „Pi 0.5“ von Physical Intelligence und „WALL-OSS“ von X Square Robot – auf drei Hardware-Plattformen: NVIDIAs RTX 4090-, Jetson Orin- und Jetson Thor-Chips. Mit einer Inferenzfrequenz von 38,46 Hertz bei FP8-Präzision läuft die Engine nun schnell genug, um jene Art von kontinuierlichem Echtzeit-Regelkreis zu unterstützen, den ein Roboter benötigt, um zu gehen, zu greifen und seinen Kurs zu korrigieren – und zwar ohne das sichtbare Ruckeln, das viele Demonstrationen mit verkörperter KI auf der Bühne zwar beeindruckend, in der Fabrikhalle jedoch unzuverlässig erscheinen ließ.
Infinigence AI, 2023 in Peking von einem aus der Fakultät für Elektrotechnik der Tsinghua-Universität hervorgegangenen Team unter der Leitung von Professor Wang Yu gegründet, hat mehr als 2,2 Milliarden RMB – umgerechnet etwa 323 Millionen US-Dollar – von Investoren wie Tencent, Baidu, Lenovo und Xiaomi mehr als 2,2 Milliarden RMB (etwa 323 Millionen US-Dollar) von Investoren wie Tencent, Baidu, Lenovo und Xiaomi eingeworben und positioniert sich als Infrastrukturunternehmen, das die tatsächliche Ausführung großer KI-Modelle auf Hardware optimiert, anstatt die Modelle selbst zu entwickeln. Diese Positionierung ist entscheidend, um zu verstehen, warum es APXInf gibt: Infinigence versucht nicht, Physical Intelligence oder X Square Robot hinsichtlich der Modellleistung zu übertreffen. Vielmehr versucht das Unternehmen, das eng gefasste, weniger glamouröse Problem zu lösen, was geschieht, wenn ein leistungsfähiges Modell auf einen Roboter übertragen wird, der nur über einen Bruchteil des Rechenbudgets eines Rechenzentrums, eine begrenzte Leistungsaufnahme und keinerlei Toleranz für die Art von Latenz verfügt, die ein Nutzer eines Cloud-Chatbots
würden das niemals bemerken.Warum ein paar hundert Millisekunden einen Roboter lahmlegen, einen Chatbot jedoch nicht
Der spezifische Fehlermodus, auf den APXInf abzielt, ist einer, den Käufer, die die Praxistauglichkeit eines Anbieters für verkörperte KI bewerten, verstehen sollten, bevor sie einen Implementierungsvertrag unterzeichnen. Ein cloudbasiertes Sprachmodell, das 300 Millisekunden länger für eine Antwort benötigt, verursacht für eine Person, die in ein Chatfenster tippt, eine nicht wahrnehmbare Verzögerung. Der Regelkreis eines Roboters, der zusätzliche 300 Millisekunden benötigt, um eine Entscheidung in eine Gelenkbewegung umzusetzen, erzeugt genau jene ruckartige, abgehackte Bewegung, die eine Demonstration unvollendet wirken lässt und – was noch schwerwiegender ist – dazu führen kann, dass eine mehrstufige Manipulationsaufgabe gänzlich fehlschlägt, wenn ein Greifer sich einen Bruchteil einer Sekunde zu spät um ein sich bewegendes Objekt schließt. Infinigences eigene Formulierung des Problems lautet: Ein Modell, das in der Cloud gut läuft, steht vor ganz anderen Fragen, sobald es auf einem physischen Roboter zum Einsatz kommt – ob es sofort hochfahren kann, ob es jede verfügbare Rechenleistung aus dem begrenzten integrierten Speicher herausholen kann, ob die Latenz niedrig genug bleibt, um nicht zum Engpass zu werden, und ob ein Modell, das in einer Entwicklungsumgebung einwandfrei funktionierte, im Dauerbetrieb stabil bleibt – beschreibt genau die Kluft zwischen einem Laborergebnis und einem einsatzfähigen Produkt, die in den letzten zwei Jahren zahlreiche Programme im Bereich der humanoiden und industriellen Robotik zum Stillstand gebracht hat.
Die Antwort von APXInf auf diese Lücke beruht auf drei technischen Entscheidungen und nicht auf einem einzigen algorithmischen Trick. Die Geschwindigkeitssteigerung resultiert aus einer durchgängigen Optimierung über die gesamte Modellpipeline hinweg, dem Berechnungsgraphen und den einzelnen Kernel-Operationen, kombiniert mit einer maßgeschneiderten „Fused-Operator“-Technik, die das Team „Agent4Kernel“ nennt – und nicht aus der isolierten Optimierung einer einzelnen Modelloperation. Aus diesem Grund gilt die daraus resultierende 10,7-fache Latenzreduktion als Wert für den gesamten Regelkreis und nicht als Benchmark, der gezielt aus einer einzelnen Verarbeitungsstufe herausgegriffen wurde. Die Stabilität beruht auf einer minimalen Laufzeitumgebung, die in Rust implementiert ist, einem System-
Eine Programmiersprache, die speziell aufgrund ihrer Garantien für Speichersicherheit ausgewählt wurde und in eine Python-Schnittstelle eingebettet ist, wodurch das Tool auch für Robotikentwickler zugänglich bleibt, die keine ausgebildeten Systemprogrammierer sind – eine Kombination, die darauf abzielt, Speicherlecks, Race-Conditions und unvorhersehbare Abstürze zu verhindern, die das Steuerungssystem eines Roboters nicht während der ersten Testphase, sondern erst nach mehreren Stunden im Einsatz zum Erliegen bringen können. Die dritte Eigenschaft, die das Team als „Agilität“ bezeichnet, nutzt einen sogenannten „agentenbasierten Entwicklungsansatz“, um neue Modelle aus den Bereichen „Vision-Sprache-Aktion“ schneller in die Engine zu integrieren – eine explizite Wette darauf, dass sich das Tempo der Veröffentlichungen neuer verkörperter Modelle weiter beschleunigen wird und dass eine Inferenz-Engine, die an die heutigen Modellarchitekturen gebunden ist, innerhalb eines Jahres veraltet sein wird.Das Ökosystem hinter den Benchmark-Zahlen
APXInf entstand nicht als eigenständiges Projekt. Es erweitert ein bestehendes Open-Source-Framework namens RLinf, das Infinigence und Tsinghua im September 2025 veröffentlichten – nach Angaben des Teams als erstes groß angelegtes Framework für bestärkendes Lernen, das speziell für verkörperte KI-Modelle nach dem Training entwickelt wurde. Diese frühere Version kümmerte sich um den Trainings- und Bewertungsaspekt beim Aufbau eines verkörperten Modells; APXInf übernimmt nun den Einsatzaspekt und bietet Entwicklern eine einzige, durchgängige Open-Source-Pipeline – vom Training eines Modells über die Validierung seines Verhaltens bis hin zur Ausführung auf dem Onboard-Chip eines physischen Roboters. Für ein Robotik-Start-up oder einen Käufer im Bereich der industriellen Automatisierung, der Entscheidungen zwischen „Selbstentwicklung“ und „Zukauf“ für seinen Embodied-AI-Stack abwägt, ist diese durchgängige End-to-End-Kontinuität wohl ein bedeutenderes Signal als einzelne Benchmark-Werte, da sie die Umstellungs- und Integrationskosten senkt, die derzeit viele Robotik-Teams dazu zwingen, separate, inkompatible Tools für Training und Bereitstellung miteinander zu verknüpfen.
Die Roadmap, die Infinigence parallel zur Markteinführung veröffentlicht hat, unterstreicht, dass es sich hierbei um eine Infrastruktur handelt und nicht um eine einmalige Forschungsveröffentlichung. Das Team erklärt
Das Unternehmen passt APXInf bereits an, um weitere Modellfamilien zu unterstützen, darunter Alibabas „Qwen“ und NVIDIAs „Groot“, sowie umfassendere Kategorien von Bild-Sprache- und Weltmodellen, und hat sich dazu verpflichtet, die Hardware-Unterstützung über die Chip-Produktpalette von NVIDIA hinaus auf in China hergestellte Chips, inländische Roboter-Betriebssysteme und Prozessoren von AMD auszuweiten. Diese Multi-Chip-Strategie stellt eine direkte Absicherung gegen eben jene Unsicherheiten hinsichtlich Exportkontrollen und Lieferketten dar, die eine Vielzahl chinesischer KI-Infrastrukturunternehmen dazu veranlasst haben, hardwareunabhängige Werkzeuge zu entwickeln, anstatt den Technologie-Stack eines Unternehmens von der fortgesetzten Verfügbarkeit eines einzigen Chipherstellers abhängig zu machen. Ein Roboter-Käufer, der heute einen Einsatzplan rund um Pi 0.5 oder WALL-OSS aufstellt, erhält ein Tool, das bereits auf gängiger NVIDIA-Hardware läuft, mit einer ausdrücklichen Zusicherung der Portabilität für den Fall, dass geopolitische oder versorgungspolitische Einschränkungen letztendlich einen Hardware-Wechsel erzwingen sollten.Warum Infinigence Mitwirkende rekrutiert, anstatt eine Lizenz zu verkaufen
Infinigence hat diese erste Version ausdrücklich als Ausgangspunkt und nicht als fertiges Produkt definiert, und das Unternehmen ruft externe Mitwirkende dazu auf, Robotik-Teams, die Pi 0.5 bereits auf Hardware der Jetson-Klasse integrieren, Entwickler, die an RTX-4090- oder Orin-Projekten arbeiten, sowie alle, die eine Bereitstellungspipeline für ein neues verkörpertes Modell aufbauen, dazu auf, Probleme zu melden und Codeänderungen direkt im GitHub-Repository einzureichen. Diese Haltung der offenen Mitwirkung ist eine bewusste strategische Entscheidung und keine bloße Höflichkeitsgeste. Der langfristige Wert einer Inferenz-Engine ergibt sich daraus, mit wie vielen Hardwarekonfigurationen, Modellarchitekturen und Randfällen sie tatsächlich getestet wurde, und Infinigence kann intern nicht jede Kombination aus Chip, Modell und Aufgabe validieren, die eine sich so schnell entwickelnde Robotikbranche im Laufe des nächsten Jahres hervorbringen wird. Diese Validierung durch Crowdsourcing im Rahmen offener Beiträge ist dieselbe Strategie, die Frameworks wie PyTorch und die „Transformers“ von Hugging Face zu Industriestandards gemacht hat.
weit über das hinaus, was ihre ursprünglichen Entwickler allein hätten testen können, und es stellt eine glaubwürdigere langfristige Investition in die Entwicklung zur Standardinfrastruktur dar, als dies bei einer geschlossenen, an einen Anbieter gebundenen Alternative der Fall wäre.Was sich dadurch für Teams ändert, die Anbieter von „Embodied-AI“ bewerten
Der praktische Test für jeden Käufer oder Integrator besteht nicht darin, ob sich die Benchmark-Werte von APXInf in den eigenen Tests von Infinigence bestätigen, sondern ob sie auf einem bestimmten Roboter, der eine bestimmte Aufgabe in einer bestimmten Einrichtung ausführt, Bestand haben, da Leistungsangaben zur Inferenz-Engine in der Vergangenheit stets davon abhingen, welche Modellvariante, welchen Quantisierungsgrad und welches Arbeitslastmuster ein Team genau gemessen hat. Die FP8-Präzision, die Einstellung hinter dem Schlagwort „26 Millisekunden“, tauscht einen Teil der numerischen Genauigkeit gegen Geschwindigkeit ein; ein Beschaffungsteam sollte daher jeden Anbieter, der eine APXInf-basierte Lösung anbietet, auffordern, dieselben Latenz- und Stabilitätswerte auf dem Präzisionsniveau nachzuweisen, das die tatsächliche Anwendung erfordert, anstatt einen FP8-Best-Case-Wert als Garantie für jede Konfiguration zu akzeptieren. Dieser Vorbehalt schmälert die zugrunde liegende Leistung nicht so sehr, als dass er vielmehr die konkrete Frage definiert, die ein ernsthafter Käufer im Rahmen seiner Sorgfaltspflicht geklärt haben muss, bevor er sich auf einen Zeitplan für die Produktionsbereitstellung festlegt.
Was die Open-Source-Veröffentlichung jedoch unmittelbar verändert, sind die Kosten für Experimente. Vor APXInf benötigte ein Robotik-Team, das Pi 0.5 oder WALL-OSS auf Jetson Thor mit produktionsreifer Latenz ausführen wollte, entweder interne Systemingenieure, die in der Lage waren, einen vergleichbaren Optimierungsstack von Grund auf neu zu entwickeln, oder eine bezahlte Zusammenarbeit mit einem Anbieter, der dieses Problem intern bereits gelöst hatte. Eine kostenlose Open-Source-Engine, die von Infinigence, der Tsinghua-Universität und der Shanghai Jiao Tong-Universität bereits anhand zweier weit verbreiteter Modelle validiert wurde, beseitigt diese Hürde für kleinere Robotik-Start-ups und Universitätslabore, die zuvor die Investitionen in die Systemtechnik nicht rechtfertigen konnten, die erforderlich sind, um ein leistungsfähiges Modell von einer Forschungsdemo in einen Roboter zu übertragen, der dasselbe ausführt.
die Aufgabe zuverlässig Stunde für Stunde ausführen, ohne dass ein Techniker bereitstehen muss, um das System neu zu starten.Stellen Sie sich den Unterschied in der Praxis vor: Ein Start-up im Bereich Lagerautomatisierung mit drei Ingenieuren und einem einzigen Jetson-Thor-Entwicklungskit kann nun ein GitHub-Repository klonen, Pi 0.5 laden und beobachten, wie sich der Pick-and-Place-Zyklus eines Roboterarms innerhalb eines Nachmittags von einer sichtbar zögerlichen Verzögerung von einer Viertelsekunde zu einer flüssigen, kontinuierlichen Bewegung verbessert – eine Lücke, die früher einen vielversprechenden Forschungsprototyp von einem finanzierbaren Produkt trennte.
Diese Analyse stützt sich auf die öffentliche Open-Source-Veröffentlichung und die technische Dokumentation, die von Infinigence AI, der Tsinghua-Universität und der Shanghai Jiao Tong-Universität zur Beschreibung der APXInf-Engine veröffentlicht wurden. Sie dient ausschließlich allgemeinen Informationszwecken und stellt keine Anlage-, Finanz- oder Rechtsberatung dar.
Bildnachweis für das Titelbild: NVIDIA.













