
一款芯片无关的推理引擎刚刚将机器人的反应时间缩短了90%
Infinigence AI、清华大学和上海交通大学共同开源了APXInf——一款在NVIDIA Jetson Thor芯片上可将机器人控制延迟降低90%的推理引擎。

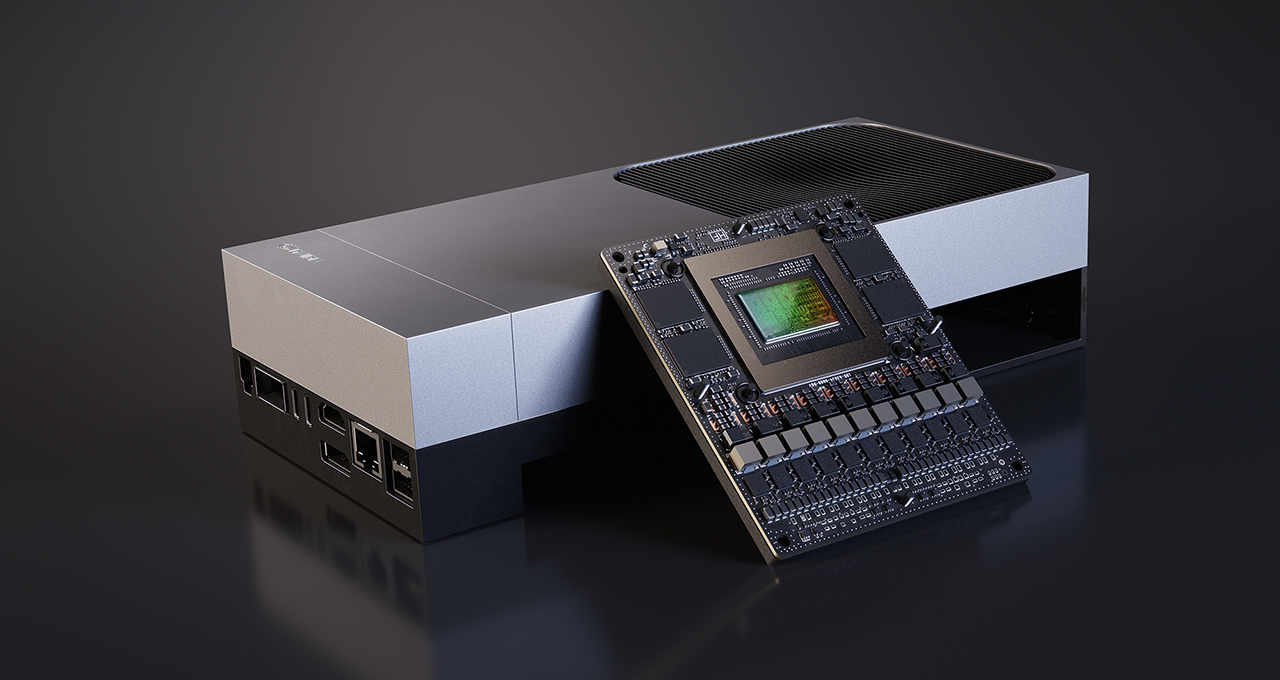
Infinigence AI 周一与清华大学和上海交通大学合作,开源了一款推理引擎,该引擎将机器人将视觉-语言-动作模型的决策转化为实际物理动作所需的时间,从278毫秒缩短至26毫秒以内。这三家机构表示,这一十倍的性能提升消除了具身人工智能演示与能够实际完成整班工作的机器人之间最后几个未解决的瓶颈之一。 该引擎名为APXInf,可从GitHub免费下载并修改,发布时已支持两种已在业界广泛应用的视觉-语言-动作模型——Physical Intelligence公司的Pi 0.5和X Square Robot公司的WALL-OSS,并兼容以下三种硬件平台: 英伟达的 RTX 4090、Jetson Orin 以及 Jetson Thor 芯片。 该引擎在FP8精度下以38.46赫兹的推理频率运行,速度已足够支持机器人所需的连续、实时控制循环,使其能够行走、抓取和修正路径,而不会出现那种肉眼可见的卡顿现象——正是这种卡顿,导致许多具身AI演示虽然在舞台上令人印象深刻,但在工厂车间却显得不可靠。
Infinigence AI 由清华大学电子工程系分拆团队于 2023 年在北京创立,由王宇教授领衔,已从腾讯、百度、 联想和小米等投资者处,已筹集资金超过22亿元人民币(约合3.23亿美元)。该公司将自身定位为一家基础设施公司,专注于优化大型AI模型在硬件上的实际运行效率,而非构建模型本身。这一定位对于理解APXInf存在的意义至关重要:Infinigence并非试图在模型能力上超越Physical Intelligence或X Square Robot。 它试图解决一个范围更窄、也更不引人注目的问题:当一个功能强大的模型被部署到一台机器人上后会发生什么——这台机器人的计算预算仅为数据中心的零头,功耗受限,且无法容忍云端聊天机器人用户所经历的那种延迟
根本不会察觉。为何几百毫秒会让机器人失灵,却不会影响聊天机器人
APXInf 针对的这种特定故障模式,是任何评估具身人工智能供应商实际应用准备情况的买家在签署部署合同前都应了解的。对于在聊天窗口中输入文字的人来说,一个响应时间多出 300 毫秒的云端语言模型所造成的延迟是难以察觉的。 而机器人的控制回路若多花300毫秒将决策转化为关节运动,就会产生那种令演示看起来未完成的、 不连贯的运动,这不仅会让演示显得不完整,更严重的是,当夹爪对移动物体闭合的时间晚了不到一秒时,可能会导致多步骤操作任务彻底失败。 Infinigence 对这一问题的独到阐释是:一个在云端运行良好的模型,一旦部署到实体机器人上,就会面临完全不同的一系列问题——它能否瞬间启动,能否从有限的机载芯片中榨取每一单位可用计算资源, 延迟是否足够低以避免成为瓶颈,以及在开发环境中运行无误的模型在连续运行中是否仍能保持稳定——这恰恰描述了实验室结果与可部署产品之间的鸿沟,而正是这一鸿沟在过去两年中阻碍了多个类人机器人和工业机器人项目的进展。
APXInf 针对这一差距的解决方案,并非依赖于单一的算法技巧,而是基于三项工程选择。速度的提升源于对模型管道、 计算图以及各个内核操作的端到端优化,并结合了团队称为Agent4Kernel的自定义融合运算符技术,而非孤立地优化任何单一模型操作。正因如此,最终实现的10.7倍延迟降低才是完整循环的实际数据,而非从某个处理阶段刻意挑选出来的基准测试结果。 稳定性则源于采用Rust语言构建的轻量级运行时,以及系统级
该编程语言之所以被选中,正是因为它能保证内存安全;同时,它被封装在 Python 接口中,使那些并非系统程序员出身的机器人开发人员也能轻松使用该工具。这种组合旨在防止内存泄漏、竞争条件以及不可预测的崩溃——这些故障往往不会在初始测试阶段发生,而是在机器人运行数小时后导致控制系统瘫痪。 第三个特性,即团队所称的“敏捷性”,采用了一种被其描述为“代理工程方法”的策略,使新的视觉-语言-动作模型能够更快地集成到引擎中。这是一种明确的押注:新的具身模型发布速度将持续加快,而锁定在当今模型架构上的推理引擎将在一年内变得过时。基准数据背后的生态系统布局
APXInf 并非作为独立项目出现。它是对现有开源框架 RLinf 的扩展——该框架由 Infinigence 和清华大学于 2025 年 9 月发布,据团队描述,这是首个专门为训练后具身 AI 模型构建的大规模强化学习框架。 该早期版本负责构建具身模型的训练和评估环节;而APXInf则负责部署环节,为开发者提供了一条从模型训练、行为验证到在实体机器人板载芯片上运行的单一、连续的开源管道。 对于正在评估其具身AI技术栈“自建与采购”决策的机器人初创企业或工业自动化采购方而言,这种端到端的连续性可以说比任何单项基准测试数据都更为重要,因为它降低了切换和集成成本——正是这些成本目前迫使许多机器人团队不得不将训练和部署环节中那些彼此独立且不兼容的工具拼凑在一起。
Infinigence 在发布之际同步公布的路线图进一步强调,这旨在构建基础设施,而非一次性的研究发布。该团队表示
该公司目前正在对APXInf进行适配,以支持更多模型系列,包括阿里巴巴的Qwen和英伟达的Groot,以及更广泛的视觉-语言模型和世界模型;同时,该公司已承诺将硬件支持范围从英伟达的芯片产品线扩展至中国本土芯片、本土机器人操作系统以及AMD的处理器。 这种多芯片战略正是针对出口管制和供应链不确定性的直接对冲措施——正是这些因素促使众多中国人工智能基础设施企业开发硬件无关的工具,而不是将公司的技术栈押注于单一芯片供应商的持续供货能力上。 如今,围绕Pi 0.5或WALL-OSS制定部署计划的机器人采购方,将获得一款已可在主流英伟达硬件上运行的工具,且该工具明确承诺具备可移植性——即使未来因地缘政治或供应限制而不得不更换硬件,也能顺利迁移。Infinigence 为何招募贡献者而非出售许可证
Infinigence 已明确将此次首次发布定位为起点而非成品,该公司正在招募外部贡献者, 已将 Pi 0.5 集成到 Jetson 级硬件的机器人团队、从事 RTX 4090 或 Orin 项目的开发者,以及任何正在为新型具身模型构建部署管道的人士,鼓励他们直接向 GitHub 仓库提交问题报告和代码修改。这种开放贡献的姿态并非礼节性举动,而是经过深思熟虑的战略选择。 推理引擎的长期价值取决于其实际经过测试的硬件配置、模型架构和边界情况的数量,而面对机器人行业如此迅猛的发展势头,Infinigence 无法在未来一年内内部验证该行业将产生的每一种芯片、模型和任务的组合。 通过开放贡献来众包这种验证,正是让 PyTorch 和 Hugging Face 的 Transformers 等框架成为行业标准的同一策略。
这远远超出了其原始开发者单独测试所能达到的范围,而且与封闭且受供应商锁定的替代方案相比,它作为未来默认基础设施的长期选择更具可信度。这对评估具身人工智能供应商的团队意味着什么
对于任何买家或集成商而言,真正的实践检验并非在于APXInf的基准测试数据能否在Infinigence的内部测试中得到验证, 而在于这些数据能否在特定设施中,由运行特定任务的特定机器人上得到验证——因为历史上,推理引擎性能的宣称一直高度依赖于团队所测量的具体模型变体、量化级别和工作负载模式。FP8精度, 正是支撑“26毫秒”这一头条数据的设置,它是以牺牲部分数值精度为代价换取速度的。采购团队应要求任何推销基于APXInf部署方案的供应商,在实际应用所需的精度级别下展示相同的延迟和稳定性数据,而不是将最佳情况下的FP8数值视为适用于所有配置的保证。 这一注意事项并非贬低其根本成就,而是界定了严肃的买家在确定生产时间表之前,需要得到解答的具体尽职调查问题。
此次开源发布立即改变的是实验成本。 在 APXInf 出现之前,如果某个机器人团队希望在 Jetson Thor 上以生产级延迟运行 Pi 0.5 或 WALL-OSS,则必须拥有能够从零开始构建同类优化栈的内部系统工程人才,或者与已经内部解决了该问题的供应商建立付费合作关系。 Infinigence、清华大学和上海交通大学已经针对两种广泛使用的模型验证过这款免费的开源引擎,这为规模较小的机器人初创公司和大学实验室扫除了障碍——此前,这些机构无法承担将一个功能强大的模型从研究演示转化为能够运行相同功能的机器人的系统工程投资。
该系统能够小时复小时地稳定运行,无需工程师在旁待命以重启系统。试想一下实际应用中的差异:一家拥有三名工程师和单套 Jetson Thor 开发套件的仓库自动化初创公司,现在只需克隆一个 GitHub 仓库,加载 Pi 0.5 系统,就能在短短一个下午内,将机械臂的拾放循环从肉眼可见的、略显迟疑的四分之一秒延迟,优化为流畅连续的动作, 而这曾是将一个前景广阔的研究原型与可获融资的产品分隔开来的鸿沟。
本分析基于Infinigence AI、清华大学和上海交通大学发布的关于APXInf引擎的公开开源版本及技术文档。本文仅供一般信息参考,不构成投资、财务或法律建议。
封面图片来源:NVIDIA。













