
Figure's Helix 2.5 成功清除了30处它从未见过的房屋
Figure AI 的 Helix 2.5 模型将 30 个陌生家庭中的零样本任务成功率从 9% 提升至 56%,以此检验了对于家用机器人而言,“泛化”究竟意味着什么。

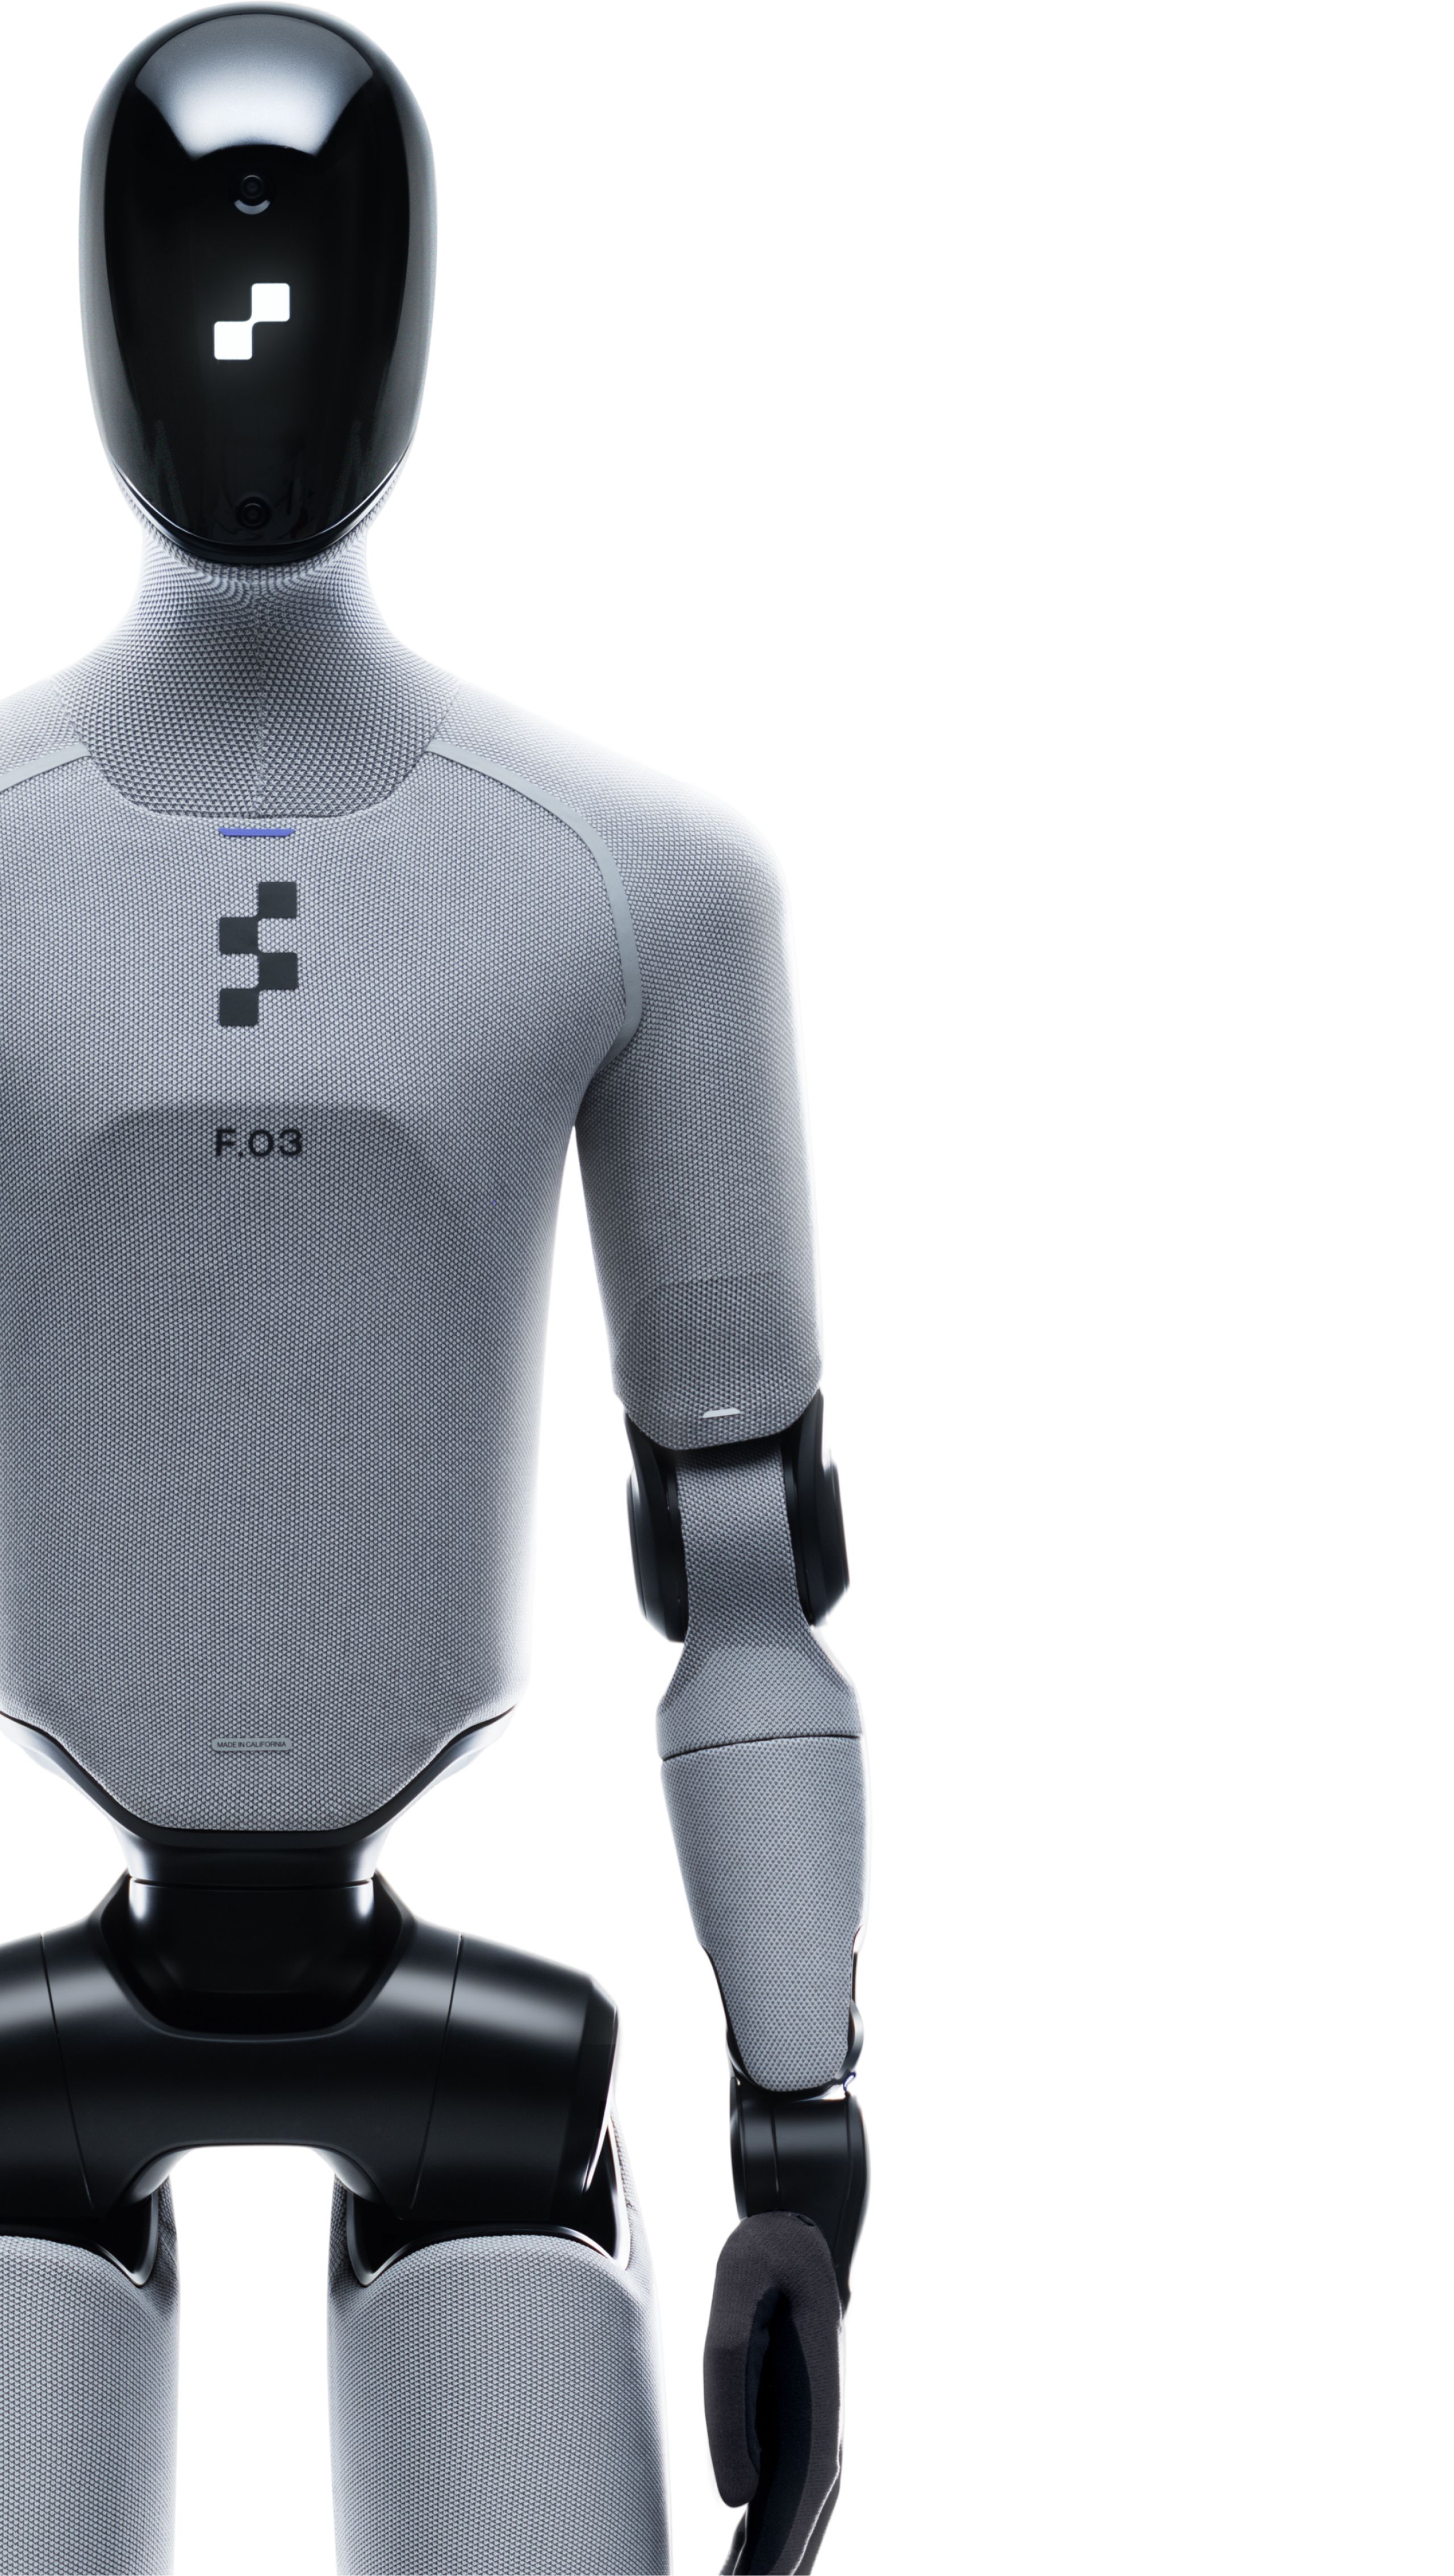
家用机器人领域最棘手的问题,从来都不是让类人机器人折一次毛巾。真正的难题在于,让同一台机器人在从未踏足过的房屋里、在从未见过的床上、用从未接触过那种特定面料的双手来折毛巾。 Figure AI表示,其最新的控制模型Helix 2.5本月已跨越这一门槛,在旧金山湾区的30个陌生家庭中完成了三项家务任务,且未进行额外的数据采集、 微调,也无需现场适应,任务成功率达到56%,而未经过该模型大规模预训练步骤时,相同任务的基线成功率仅为9%。 对于过去两年一直致力于证明类人型机器人在单一、精心排练的环境中能表现出色的行业而言,在互不相关的物理空间中实现零样本泛化能力的真正飞跃,是一种截然不同的成果,而这也将决定家用机器人究竟是演示类产品还是商用产品。
Figure AI是一家位于湾区的人形机器人公司,既开发Figure 03机器人硬件,也开发控制该机器人的Helix视觉-语言-动作模型。该公司租用了30套此前从未进行过操作的住宅,并在每套住宅内测试了三项长周期行为: 整理客厅、折叠毛巾和铺床,所有操作均利用该特定住宅中原本就存在的家具、台面和物品。没有任何住宅被用作训练数据,且机器人在抵达后未进行任何针对特定任务的适应性调整。这种测试设计正是关键所在。 在公司自有展厅中进行的机器人演示——其灯光、家具和物品摆放均经过预先调整——只能证明该模型在理想条件下能够运行。而在30套该模型从未见过的住宅中进行的冷启动测试,则更接近实际客户在第一天所面临的客厅环境。
Helix与Helix 2.5之间的变化
图所称的“Index”正是这一飞跃背后的机制
预训练:这是一个大规模的预训练阶段,其处理人类物理体验数据的速度据该公司描述约为每秒35分钟的人类体验数据,远远超出了仅靠特定任务的机器人演示数据所能提供的量。 Figure 并未针对每种新行为直接使用经过筛选的、针对特定任务的机器人演示数据来训练模型,而是先利用更广泛的人类经验语料库对单一基础模型进行预训练,随后将同一预训练基础模型适应于涵盖移动、刚性及可变形物体操作、双臂协调以及主动感知等不同下游行为。 在保持特定任务数据、机器人硬件、训练流程和评估协议不变,仅改变是否包含该 Index 预训练步骤的情况下,该公司报告称,在 30 项家庭场景评估中的零样本成功率从 9% 提升至 56%。 对于机器人领域的公告而言,这是一种极为严谨的实验设计:大多数类人机器人公司通常仅公布一个醒目的核心数据,却未明确说明是哪项架构变更促成了这一成果;而Figure决定发布这项受控对比实验,本身就是有力的证据,因为这使外部研究人员能够评估,究竟是预训练方法——而非其他未披露的变更——真正发挥了作用。效率的提升进一步强化了泛化效果。 Figure表示,Helix 2.5所需的任务特定数据量仅为早期Helix 02模型中代表性行为所需数据量的半数,却能达到相当甚至更优的性能。这一点至关重要,因为任务特定的机器人演示数据——即使用真实机器人执行实际任务时记录的物理试验——是整个训练流程中最昂贵的输入。 收集此类数据需要机器人硬件时间、人工操作,且通常需要手动标注,其扩展性远不及大型语言模型所使用的互联网文本或图像数据。如果基于更广泛的
如果人类体验数据确实能够替代那部分昂贵且针对特定任务的数据集中的相当一部分,那么它不仅会改变家用机器人模型最终的性能上限,还会改变训练该模型的单位经济效益。头条数据背后的规模律主张
Figure 还随同泛化结果发布了一项标度律分析,报告称在测试的最大预训练运行中,其预测误差仅占预训练数据量八倍范围内的总变异量的 0.54%。 通俗地说,该公司声称在开展全面实验之前,就能高精度地预测预训练数据的特定增量将如何提升下游任务的性能。 正是这种可预测的规模关系,让大型语言模型开发者得以在模型发布前数年就为数亿美元的训练投入提供合理依据——因为可靠的规模律能将昂贵的训练从一种投机性赌注转变为可预测的投资。 如果 Figure 的规模定律在比迄今测试的八倍范围更大的数据量上仍然成立,这将为该公司及其投资者提供一个站得住脚的依据,使其能够继续扩大 Index 的预训练规模,而不是对收益递减进行猜测。
在将这一说法视为定论之前,它理应像任何一家公司发布的规模律声明一样,接受同样的严格审查。 在其他领域,由单一实验室发布、基于该实验室自有基准和硬件评估的规模律,一旦独立研究人员尝试在不同条件下进行复现,有时会被证明不够稳健;而Figure尚未说明Helix 2.5的规模曲线是否经过外部研究人员的评估,或在其他机器人平台上得到复现。 相比之下,无论其基础规模律最终能否成立,那项针对30个家庭的测试结果都更难被质疑,因为在真正具有创新性的
环境条件要么成立,要么不成立,而预测的缩放曲线则并非如此。56%的成功率究竟意味着什么
56%的任务成功率并非最终的消费级产品,Figure 也从未将其作为成品呈现。在陌生家庭中近一半的尝试中,毛巾折叠错误、 或在陌生住宅中近半数的尝试中未能将床铺整理妥当,对于真正的付费客户而言将是一种令人沮丧的体验。而且,在30套租赁房屋中仅进行一次研究基准测试,与一款必须在特定住宅中每天可靠运行、且在没有摄像团队或工程团队在场的情况下无限期运行的产品之间,存在巨大的差距。 该数据的有用之处在于将其与该领域的实际起点进行比较,而非与理想化的目标进行比较:在完全相同的任务、硬件和评估协议下,未经Index预训练时的9%基准成功率意味着,客观的比较并非“56%与完美”的对比, 而是“56% 对比上一代同款机器人大约十分之一的成功率”。以这一基准衡量,单次模型迭代就能实现六倍的提升,对于一个历史上通常在重大硬件或软件更新之间仅能实现微小进步的领域而言,这无疑是意义重大的快速进步。
此次评估选定的三项任务——整理客厅、折叠毛巾和铺床——也并非最容易展示的家务活。 这些任务需要持续的多步骤规划,而非单一的“抓取并放置”动作;需要适应毛巾和床单等可变形材料——它们不像刚性物体那样保持固定形状;还要求通过全身双臂机器人(而非固定机械臂)进行协调的导航和操作。 在泛化能力基准测试中选择长周期、涉及可变形物体的任务,而非可能展现更高原始成功率的简单“拾取并放置”演示,表明Figure正在优化其
这是为了在具备技术知识的买家和竞争对手心中树立公信力的基准,而非追求尽可能令人印象深刻的头条数据——尽管无论选择何种测试任务,该公司显然都有充分的动机将自身测试结果呈现得尽可能有利。这对所有致力于解决同一问题的企业意味着什么
每一家致力于开发家用通用类人机器人的公司——无论是拥有雄厚资金、自建视觉-语言-动作模型的竞争对手,还是为这些模型最终运行提供执行器和传感器的零部件供应商——都在朝着同一个根本性制约因素飞速前进: 任务特定的训练数据无法快速扩展,以覆盖商用家用机器人最终将遇到的近乎无限多样的真实家庭环境、物体及边界情况。 如果基于更广泛人类经验数据的大规模预训练,真能替代那部分昂贵且收集缓慢的任务专用数据中的相当一部分——正如Figure公司进行的9%至56%的受控对比所示——那么,人形机器人领域的竞争优势将进一步向那些能够获取、处理、 并利用最大规模的通用物理体验数据进行训练的企业,而不仅仅是拥有最先进机器人硬件或已部署最大规模机队来收集特定任务演示数据的企业。
这一转变对未来几个产品周期内评估类人机器人公司的买家和投资者具有直接影响: 一家公司当前的机器人机队规模和特定任务数据集——这是大多数类人机器人初创企业在营销中重点宣传的指标——对于其长期竞争力而言,可能不如该公司是否拥有(或能够构建)与Figure的“Index”方法相当的预训练管道和数据采集策略重要。 一家目前部署机队规模更大但缺乏同等预训练架构的竞争对手,其在新环境中的泛化能力可能会远低于一家实地部署机器人数量较少但
为其提供更强大的基础模型。Helix 2.5面临的下一个考验,绝不是又一场针对30户家庭的研究评估。 而是当某位付费客户最终在普通周二让机器人进入家中,在无人监督的情况下——既没有工程团队待命,也没有预先定义成功的基准协议——去处理那些从未被出租、布置过或选作新闻稿素材的、堆积如山的待洗衣物和未整理的床铺。
本分析基于 Figure AI 针对 Helix 2.5 模型及其评估所发布的公开声明和技术成果。本文仅供一般信息参考,不构成投资、财务或法律建议。
首图来源:Figure AI。









