
『Figure's Helix 2.5』が、これまで見たことのない30軒の家をクリアした
Figure AIの「Helix 2.5」モデルは、30軒の見知らぬ家庭におけるゼロショットタスクの成功率を9%から56%へと向上させ、家庭用ロボットにとって「汎化」が実際に何を意味するのかを検証した。

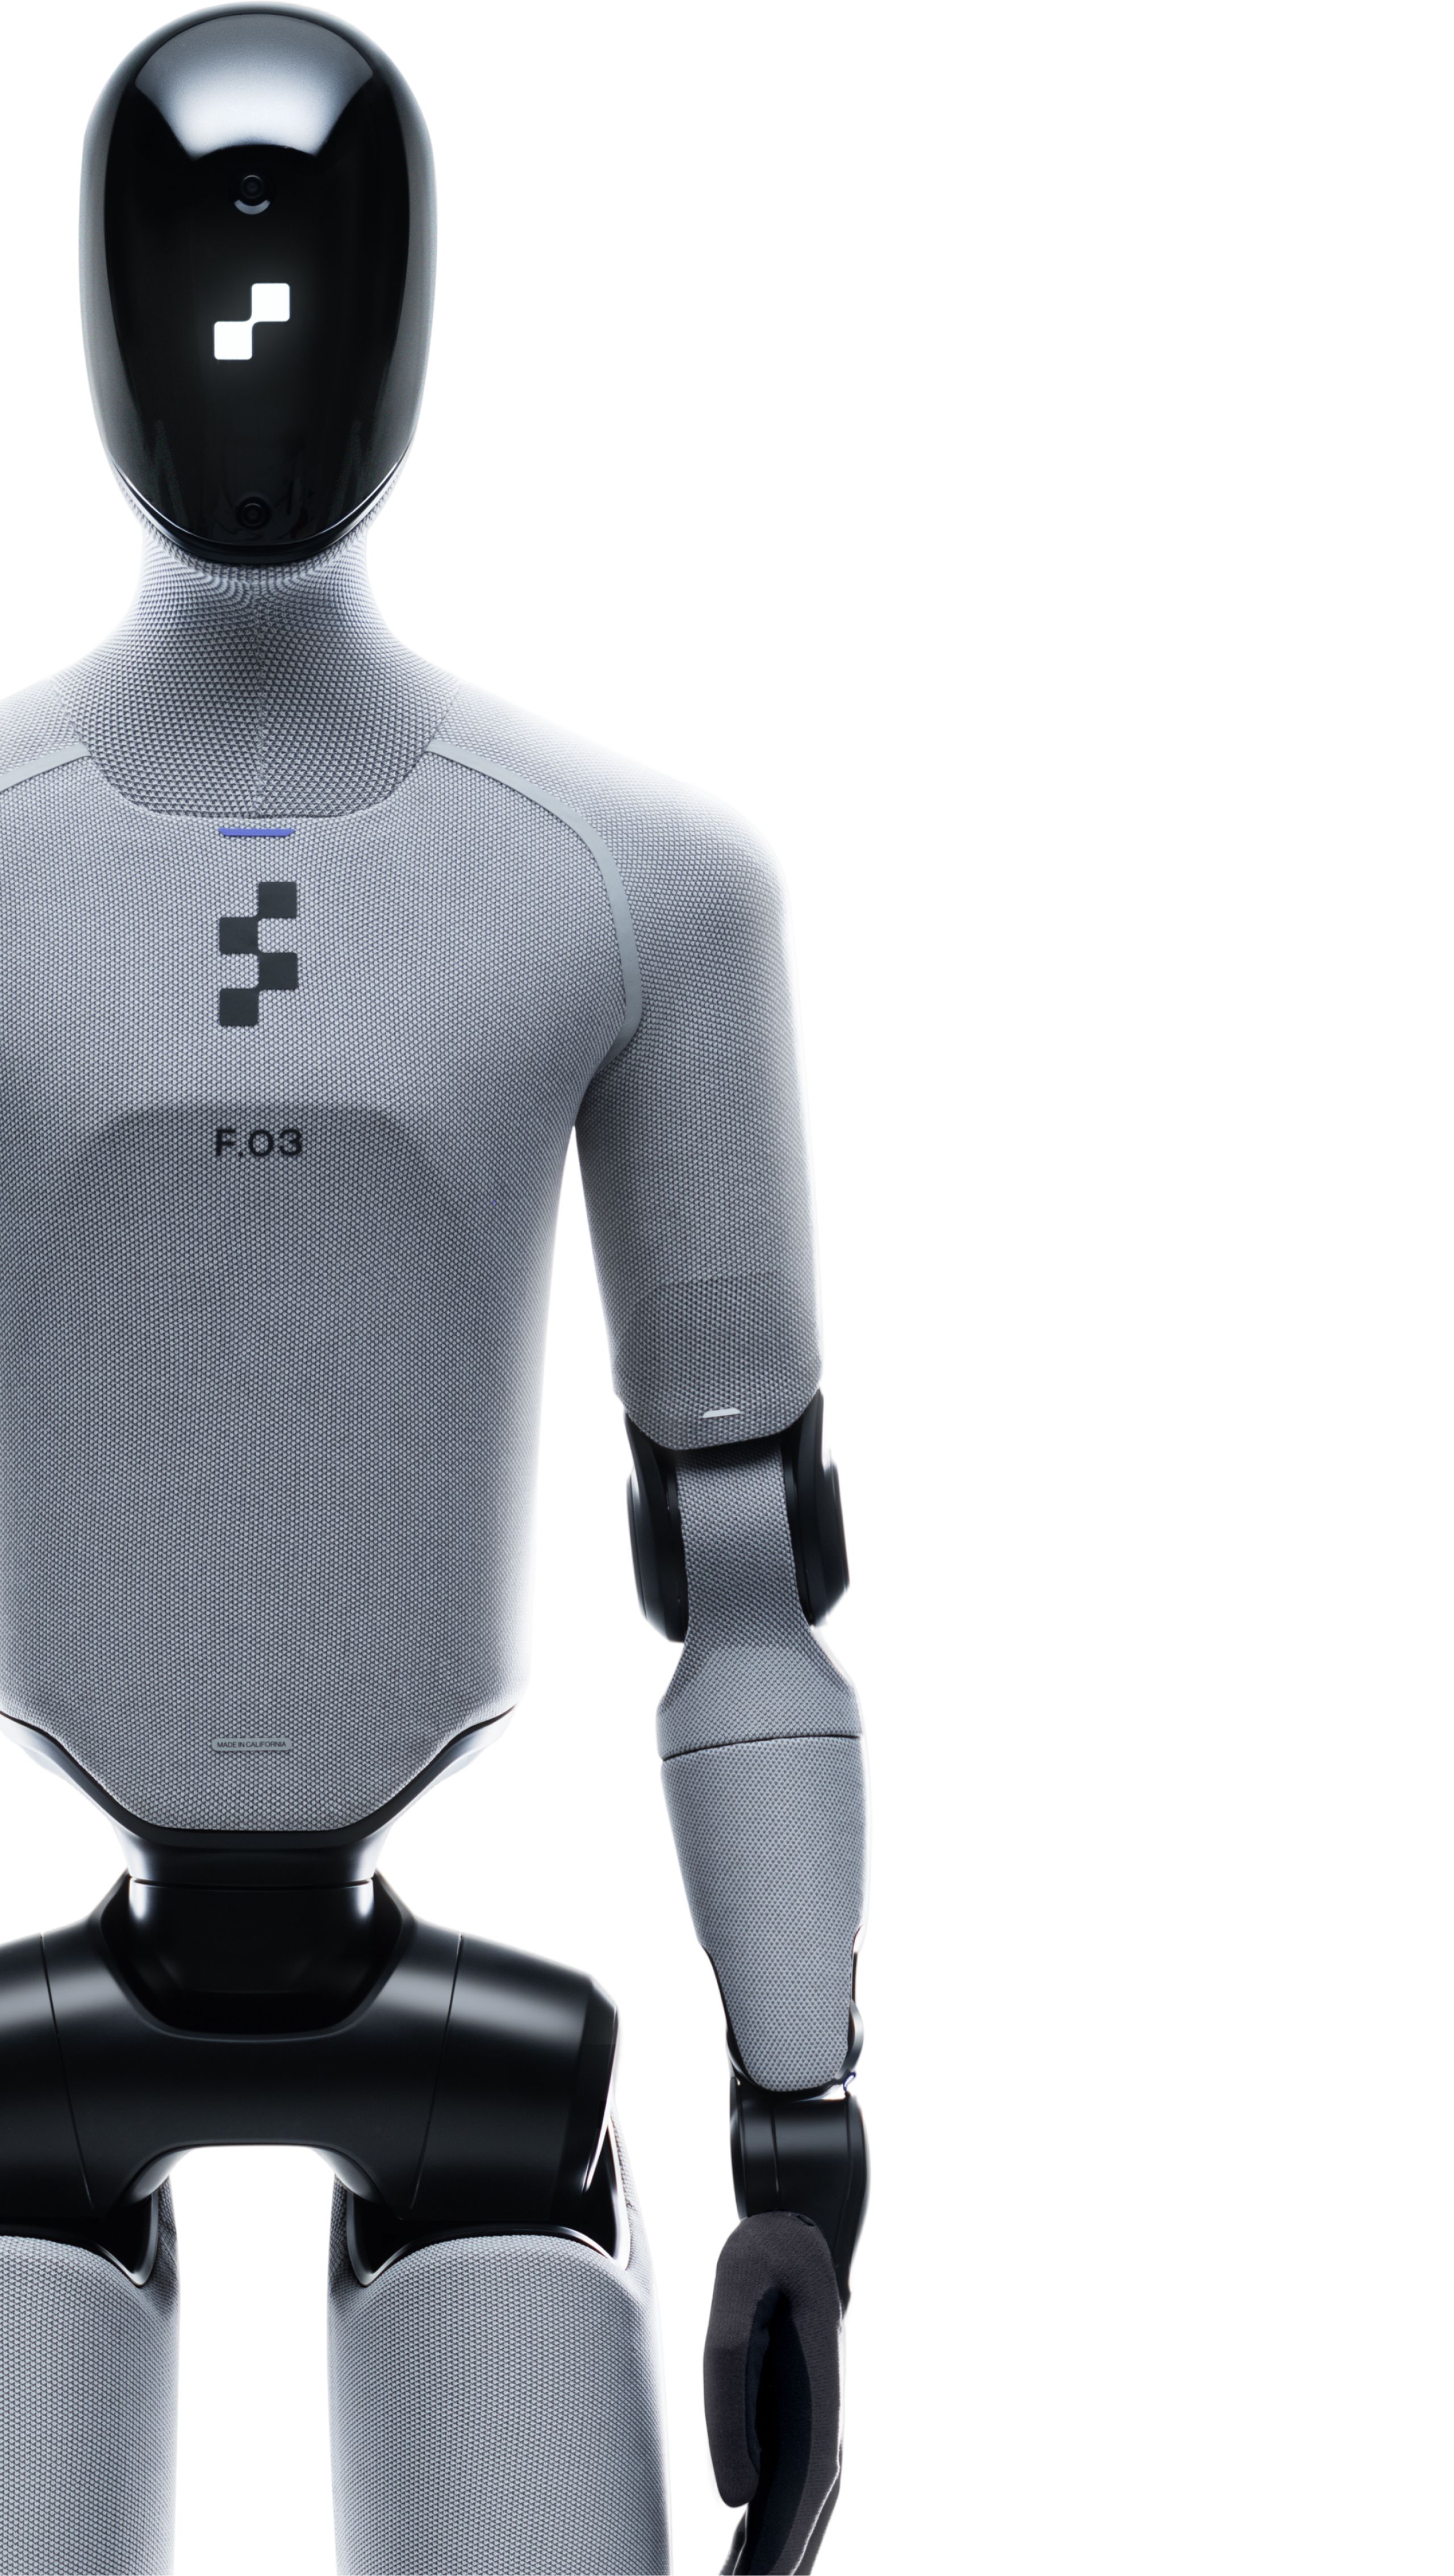
家庭用ロボットの分野において、最も困難な課題は、ヒューマノイドロボットにタオルを一度だけ畳ませることではありませんでした。その課題とは、そのロボットが一度も入ったことのない家の中で、見たことのないベッドの上で、その特定の生地に触れたことのない手を使って、タオルを畳ませることだったのです。 Figure AIによると、同社の最新制御モデル「Helix 2.5」は今月、このハードルを乗り越えたという。サンフランシスコ・ベイエリアの30軒の見知らぬ住宅において、追加のデータ収集や 微調整、あるいは現場での適応を行うことなく、サンフランシスコ・ベイエリアの30軒の未知の住宅で3つの家事タスクを実行し、タスク成功率は56%を記録した。これは、同モデルの大規模な事前学習ステップを行わない場合の同じタスクにおける9%というベースラインから向上した数値である。 過去2年間、ヒューマノイドロボットが、単一の、入念にリハーサルされた環境下で目覚ましい性能を発揮できることを証明してきた業界にとって、関連性のない物理的空間を跨ぐゼロショット汎化能力における真の飛躍は、これまでとは一線を画す成果であり、家庭用ロボットが単なるデモの範疇にとどまるか、あるいは製品カテゴリーとして確立されるかを決定づけるものとなる。
ベイエリアの人型ロボット企業であるFigure AIは、ロボットハードウェア「Figure 03」と、それを制御する「Helix」ビジョン・言語・アクションモデルの両方を開発している。同社は、これまで一度も稼働させたことのない30軒の住宅を借り上げ、各住宅内で以下の3つの長期的な行動をテストした: リビングの片付け、タオルの折りたたみ、ベッドメイキング。これらはすべて、その特定の住宅にたまたま既にあった家具、表面、物体を使用して行われた。どの住宅もトレーニングデータとして使用されておらず、ロボットが到着した後にタスクに特化した適応も行われなかった。このテスト設計こそが重要な点である。 照明や家具、物置きの配置が事前に調整された、自社ショールームで行われるロボットデモは、モデルが好条件下で動作できることを証明するに過ぎない。モデルがこれまで見たことのない30軒の住宅で、事前準備なしに実施されたテストは、実際の顧客の居間が導入初日にどのような状態になるかに、より近い状況を証明するものである。
HelixとHelix 2.5で何が変わったのか
この飛躍の背景にある仕組みを、フィギュアは「インデックス」と呼んでいる
「プレトレーニング」とは、同社が「1秒あたり約35分分の人間体験データ」と表現するペースで、人間の身体的体験データを取り込む大規模な事前学習段階であり、これはタスク特化型のロボットデモンストレーションデータだけでは到底提供できない量をはるかに上回るものです。 Figureは、新しい行動ごとに厳選されたタスク特化型のロボットデモンストレーションデータを用いてモデルを直接学習させるのではなく、まずその広範な人間の経験コーパスを用いて単一のベースモデルを事前学習させ、その後、その事前学習済みのベースモデルを、移動、剛体および変形可能な物体の操作、両手の協調動作、能動的知覚といった、さまざまな下流の行動に適応させる。 タスク固有のデータ、ロボットハードウェア、トレーニング手順、評価プロトコルを固定し、その「Index」事前学習ステップを含めるかどうかのみを変更したところ、同社は30のホーム評価におけるゼロショットの成功率が9%から56%に上昇したと報告している。 これは、ロボット工学分野の発表としては異例に明快な実験設計である。ヒューマノイドロボットを手掛ける企業の多くは、どのアーキテクチャの変更が結果をもたらしたかを特定せずに、単一の注目すべき数値のみを報告する傾向にある。一方、Figure社がこの制御された比較結果を公表したことは、それ自体が有用な証拠となる。なぜなら、これにより外部の研究者が、他の未公開の変更ではなく、事前学習アプローチが実際に効果を発揮しているかどうかを評価できるからである。この効率の向上は、汎化性能の向上をさらに後押ししている。 Figure社によると、Helix 2.5は、以前のHelix 02モデルの代表的な動作と比較して、同等の、あるいはそれ以上の性能を達成するために必要なタスク固有のデータ量を半分に抑えることができたという。これは重要な点である。なぜなら、タスク固有のロボットデモンストレーションデータ(実際のロボットが実際のタスクを実行する様子を記録した物理的な試行)は、トレーニングパイプライン全体において最もコストのかかる入力要素だからだ。 そのデータの収集には、ロボットハードウェアの使用時間、オペレーターの人手、そして多くの場合手作業によるラベリングが必要であり、大規模言語モデルにおけるインターネット由来のテキストや画像データのようにスケーリングすることはできません。もし、より広範なデータを用いた事前学習を
人間による体験データが、その高コストなタスク特化型データ収集の相当な部分を真に代替できるのであれば、それは家庭用ロボットモデルの最終的な性能の上限だけでなく、そのモデルを訓練するための単位あたりの経済性も変えることになる。見出しの数値の背景にあるスケーリング則の主張
Figure社は、汎化性能の結果と併せてスケーリング則の分析も発表しており、テストした最大規模の事前学習実行における予測誤差は、事前学習データ量の8倍の範囲にわたる総変動のわずか0.54%であったと報告している。 平たく言えば、同社は、本格的な実験を実行する前に、プレトレーニングデータの一定量の増加が、下流タスクの性能をどれだけ向上させるかを高い精度で予測できると主張している。 こうした予測可能なスケーリング関係こそが、大規模言語モデルの開発者たちが、モデルがリリースされる何年も前から数億ドル規模のトレーニング実行を正当化できた理由である。信頼性の高いスケーリング則があれば、高額なトレーニング実行は単なる投機的な賭けから、予測可能な投資へと変わるからだ。 もしFigure社のスケーリング法則が、これまでテストされた8倍の範囲よりもさらに大規模なデータ量においても成立するならば、同社とその投資家にとって、収益の逓減を推測するのではなく、Indexの事前学習を継続的に拡大していくための正当な根拠となる。
この主張は、確立された科学として扱われる前に、単一企業によるスケーリング則の発表が受けるべきのと同じ程度の精査に値する。 単一の研究所によって発表され、その研究所独自のベンチマークやハードウェアで評価されたスケーリング則は、他の分野において、独立した研究者が異なる条件下で再現を試みた際に、その堅牢性が低いことが判明することがある。また、Figure社は、Helix 2.5のスケーリング曲線が外部の研究者によって評価されたか、あるいは別のロボットプラットフォーム上で再現されたかについて、何も明らかにしていない。 対照的に、30戸のテスト結果は、根底にあるスケーリング則が最終的にどの程度成立するかにかかわらず、反論しづらいものです。なぜなら、真に斬新な
環境要因については、予測されたスケーリング曲線とは異なり、真か偽かのいずれかである。「56%の成功率」が実際に意味すること
56%というタスク成功率は、完成した消費者向け製品ではなく、Figure社もそれをそのように提示してはいない。見知らぬ家での試行のほぼ半数において、タオルを間違った折り方にしたり、 見知らぬ家での試行のほぼ半数で、タオルを間違って畳んだり、ベッドを半分しか整えなかったりすることは、実際の有料顧客にとっては苛立たしい体験となるだろう。また、30軒の賃貸住宅で一度だけ実施された研究用ベンチマークと、カメラクルーやエンジニアリングチームがいない状態で、特定の1軒の家で毎日、無期限に確実に動作しなければならない製品との間には、大きな隔たりがある。 この数値が有用なのは、理想化された目標値との比較ではなく、この分野の実際の出発点との比較においてである。まったく同じタスク、ハードウェア、評価プロトコルにおいてIndexの事前学習を行わなかった場合の9%というベースラインを基準とすれば、正直な比較は「56%対完璧」ではなく、 「56%対完璧」ではなく、「56%対、前世代の同じロボットが達成した約10回に1回の成功率」である。そのベースラインと比較すれば、単一のモデル反復で6倍の改善を達成したことは、これまで主要なハードウェアやソフトウェアの改訂の合間に、より小さな段階的な改善しか見られなかったこの分野にとって、極めて速い進歩のペースである。
評価のために選ばれた3つのタスク、すなわちリビングの片付け、タオルの折りたたみ、ベッドメイキングは、実証する上で最も簡単な家事とは言えない。 これらは、単に「掴んで置く」という単一の動作ではなく、持続的な多段階の計画立案を必要とし、剛体のように固定された形状を保たないタオルや寝具のような変形可能な素材への対応力、そして固定されたアームではなく、全身・両手を持つロボット全体での協調的な移動と操作が求められる。 単純な「把持・配置」の実演(これなら生成功率がより高くなる可能性が高い)ではなく、汎化能力のベンチマークとして、長期的な視点が必要で変形可能な物体を取り扱うタスクを選んだことは、Figure社が自社の
技術に精通した購入者や競合他社からの信頼性を測るための公的な指標であり、単に可能な限り見栄えのする数字を掲げるためのものではない。もっとも、課題の選択にかかわらず、自社結果を好意的に見せようとする動機が同社には当然ながら十分に存在する。同じ課題に取り組むすべての企業にとっての意味
家庭向けの汎用ヒューマノイドを開発しているすべての企業――独自の視覚・言語・動作モデルを持つ資金力のあるライバル企業から、それらのモデルが最終的に稼働するためのアクチュエータやセンサーを製造する部品サプライヤーに至るまで――は、同じ根本的な制約に向かって競争を繰り広げている。 タスク固有のトレーニングデータは、商用家庭用ロボットが最終的に遭遇する、ほぼ無限に多様な実際の住宅、物体、およびエッジケースを網羅するのに十分な速さで拡張できない。 もし、より広範な人間の経験データを用いた大規模な事前学習が、図に示された9%対56%の比較が示唆するように、収集にコストがかかり時間がかかるタスク固有のデータのかなりの部分を真に代替できるのであれば、ヒューマノイドロボット分野における競争優位性は、単に最も高性能なロボットハードウェアを保有したり、タスク固有のデモンストレーションを収集するためにすでに展開されている最大規模のロボット群を保有したりする企業だけでなく、最も多くの汎用的な物理的経験データを調達・処理・ 訓練できる企業へとさらにシフトすることになる。単に最も高性能なロボットハードウェアを保有している企業や、タスク固有のデモンストレーションを収集するためにすでに展開されている最大規模のロボット群を持つ企業というわけではない。
この変化は、今後数回の製品サイクルにわたってヒューマノイドロボット企業を評価する購入者や投資家にとって、直接的な意味を持つ。 ヒューマノイドスタートアップの多くがマーケティングで前面に押し出している指標である、企業の現在のロボット配備台数やタスク固有のデータセットは、長期的な競争力という点では、その企業がFigureの「Index」アプローチに匹敵する事前学習パイプラインとデータ収集戦略をすでに保有しているか、あるいは構築できるかという点に比べれば、重要度が低くなる可能性がある。 現在、より多くのロボットを展開しているものの、同等の事前学習アーキテクチャを持たない競合他社は、現場に配置されているロボットの数は少ないものの、
それらを支える、より優れた基盤モデル。Helix 2.5にとっての次の試練は、またしても30世帯を対象とした研究評価などではない。 それは、ある火曜日のごく普通の日に、有料の顧客が最終的にロボットを監視なしで自宅に招き入れ、エンジニアリングチームが待機しておらず、成功の定義を事前に定めたベンチマークプロトコルもない状況下で、賃貸用でも、内見用でも、プレスリリース用に選ばれたものでもない、山積みの洗濯物や整えられていないベッドの片付けをロボットに任せることなのです。
本分析は、Helix 2.5モデルとその評価に関してFigure AIが公表した公式声明および技術的成果に基づいています。これは一般的な情報提供のみを目的としており、投資、財務、または法的アドバイスを構成するものではありません。
ヒーロー画像のクレジット:Figure AI。









