
„Figure’s Helix 2.5“ hat 30 Häuser gemeistert, die es noch nie zuvor gesehen hatte
Das „Helix 2.5“-Modell von Figure AI steigerte die Erfolgsquote bei Zero-Shot-Aufgaben in 30 unbekannten Haushalten von 9 Prozent auf 56 Prozent und prüfte damit, was Generalisierung für Haushaltsroboter tatsächlich bedeutet.

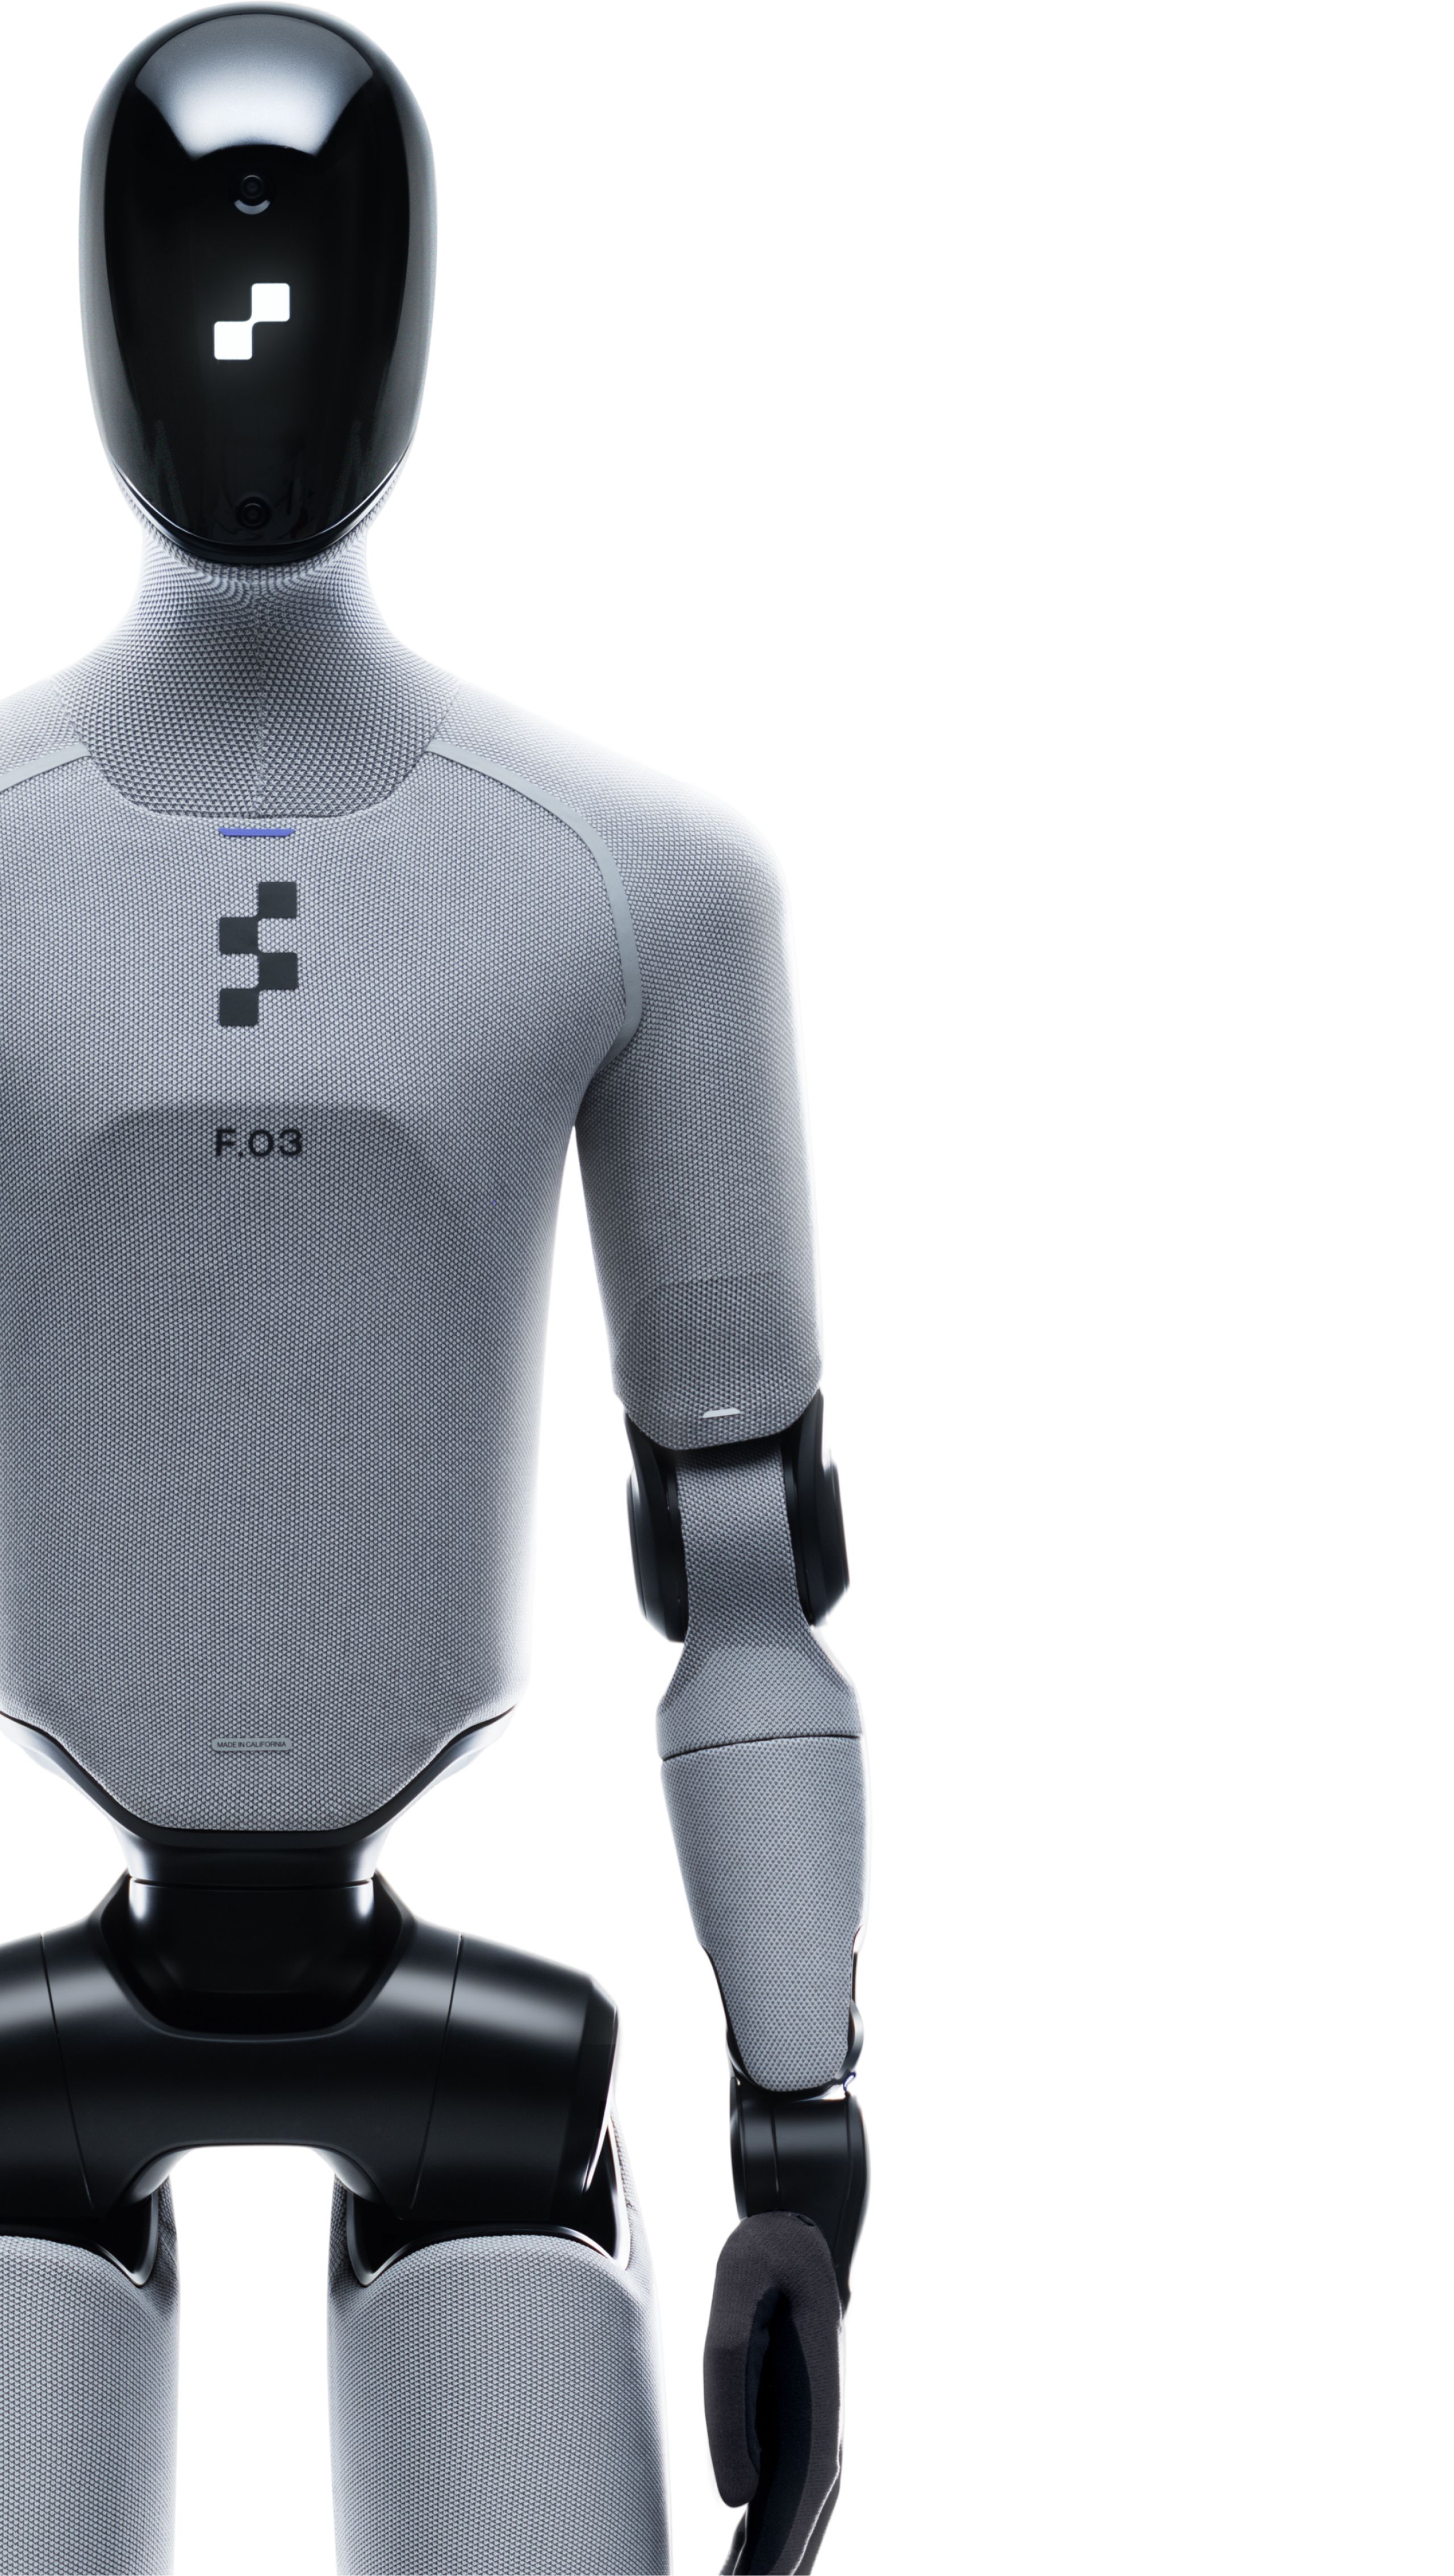
Die größte Herausforderung in der Haushaltsrobotik bestand nie darin, einen humanoiden Roboter dazu zu bringen, ein Handtuch einmal zu falten. Die Herausforderung bestand vielmehr darin, denselben Roboter dazu zu bringen, ein Handtuch in einem Haus zu falten, das er noch nie betreten hat, auf einem Bett, das er noch nie gesehen hat, und mit Händen, die diesen speziellen Stoff noch nie berührt haben. Figure AI gibt an, dass sein neuestes Steuerungsmodell, Helix 2.5, diese Hürde in diesem Monat genommen hat: Es führte drei Haushaltsaufgaben in 30 unbekannten Haushalten in der San Francisco Bay Area durch, ohne zusätzliche Datenerfassung, Feinabstimmung oder Anpassung vor Ort und eine Erfolgsquote von 56 Prozent bei den Aufgaben erzielt – eine Steigerung gegenüber den 9 Prozent, die bei denselben Aufgaben ohne den groß angelegten Vortrainingsschritt des Modells als Ausgangswert erzielt wurden. Für eine Branche, die die letzten zwei Jahre damit verbracht hat, zu beweisen, dass humanoide Roboter in einer einzigen, sorgfältig einstudierten Umgebung beeindruckende Leistungen erbringen können, stellt ein echter Sprung bei der Zero-Shot-Generalisierung über nicht miteinander in Zusammenhang stehende physische Räume hinweg ein Ergebnis ganz anderer Art dar – und genau dieses Ergebnis entscheidet darüber, ob Haushaltsroboter eine Demokategorie oder eine Produktkategorie sind.
Figure AI, das in der Bay Area ansässige Unternehmen für humanoide Robotik, das sowohl die Roboterhardware „Figure 03“ als auch das sie steuernde „Helix“-Modell für Vision, Sprache und Aktion entwickelt, mietete 30 Wohnungen an, in denen es zuvor noch nie tätig gewesen war, und testete in jeder einzelnen drei Verhaltensweisen mit langfristigem Zeithorizont: das Aufräumen eines Wohnzimmers, das Zusammenlegen von Handtüchern und das Bettenmachen – und zwar jeweils unter Verwendung der Möbel, Oberflächen und Gegenstände, die sich zufällig bereits in dem jeweiligen Haus befanden. Kein Haus wurde für Trainingsdaten herangezogen, und nach der Ankunft des Roboters erfolgte keine aufgabenspezifische Anpassung. Genau dieses Testdesign ist der entscheidende Punkt. Eine Robotik-Demonstration im firmeneigenen Showroom, bei der Beleuchtung, Möbel und die Anordnung der Gegenstände im Voraus abgestimmt wurden, beweist, dass ein Modell unter günstigen Bedingungen funktionieren kann. Ein Testlauf in 30 Wohnungen, die das Modell noch nie gesehen hat, liefert Ergebnisse, die dem tatsächlichen Erscheinungsbild des Wohnzimmers eines Kunden am ersten Tag näherkommen.
Was sich zwischen Helix und Helix 2.5 geändert hat
Der Mechanismus hinter diesem Sprung ist das, was Figure als „Index“ bezeichnet
Vortraining: Eine groß angelegte Vortrainingsphase, in der Daten menschlicher körperlicher Erfahrungen mit einer Rate aufgenommen werden, die das Unternehmen mit etwa 35 Minuten gesammelter menschlicher Erfahrungsdaten pro Sekunde angibt – weit mehr, als aufgabenspezifische Roboterdemonstrationsdaten allein jemals liefern könnten. Anstatt ein Modell für jedes neue Verhalten direkt anhand kuratierter, aufgabenspezifischer Roboterdemonstrationen zu trainieren, führt Figure zunächst ein Vortraining eines einzigen Basismodells anhand dieses umfassenderen Korpus menschlicher Erfahrungen durch und passt anschließend dasselbe vortrainierte Basismodell an unterschiedliche nachgelagerte Verhaltensweisen an, darunter Fortbewegung, die Handhabung starrer und verformbarer Objekte, bimanuelle Koordination sowie aktive Wahrnehmung. Unter Beibehaltung der aufgabenspezifischen Daten, der Roboterhardware, des Trainingsverfahrens und des Bewertungsprotokolls – wobei lediglich variiert wurde, ob dieser „Index“-Vortrainingsschritt einbezogen wurde – berichtet das Unternehmen, dass die Zero-Shot-Erfolgsquote bei der „30-Home“-Bewertung von 9 Prozent auf 56 Prozent stieg. Dies ist ein für eine Ankündigung im Bereich der Robotik ungewöhnlich klar strukturiertes Versuchsdesign: Die meisten Hersteller humanoider Roboter geben lediglich eine einzige Schlagzeilenzahl an, ohne herauszuarbeiten, welche architektonische Änderung diese bewirkt hat. Die Entscheidung von Figure, den kontrollierten Vergleich zu veröffentlichen, ist an sich schon ein nützlicher Beweis, da sie es externen Forschern ermöglicht zu beurteilen, ob tatsächlich der Vortrainingsansatz – und nicht etwa eine andere, nicht offengelegte Änderung – den entscheidenden Beitrag leistet.Der Effizienzgewinn verstärkt das Generalisierungsergebnis. Figure gibt an, dass Helix 2.5 nur halb so viele aufgabenspezifische Daten benötigte wie ein repräsentatives Verhalten des früheren Modells Helix 02, um eine vergleichbare oder bessere Leistung zu erzielen. Dies ist von Bedeutung, da aufgabenspezifische Roboterdemonstrationsdaten – also physische Versuche, die mit einem echten Roboter bei der Ausführung einer realen Aufgabe aufgezeichnet wurden – den teuersten Input in der gesamten Trainingspipeline darstellen. Das Erfassen dieser Daten erfordert Roboter-Hardwarezeit, menschliches Bedienpersonal und oft manuelle Beschriftung; zudem lässt sich dieser Aufwand nicht in derselben Weise skalieren wie bei Text- oder Bilddaten aus dem Internet, die für große Sprachmodelle verwendet werden. Wenn das Vortraining auf breiteren
Sollten Daten aus der menschlichen Erfahrung tatsächlich einen bedeutenden Teil dieser kostspieligen, aufgabenspezifischen Datenerhebung ersetzen, würde dies nicht nur die letztendliche Leistungsgrenze des Modells verändern, sondern auch die Wirtschaftlichkeit pro Einheit beim Training eines Modells für einen Heimroboter.Die Behauptung zum Skalierungsgesetz hinter der Schlagzeilenzahl
Figure hat neben dem Generalisierungsergebnis auch eine Skalierungsgesetz-Analyse veröffentlicht und berichtet, dass der Prognosefehler für den größten getesteten Vortrainingslauf lediglich 0,54 Prozent der Gesamtvariation über einen achtfachen Bereich des Vortrainingsdatenvolumens betrug. Einfach ausgedrückt behauptet das Unternehmen, dass es mit hoher Präzision vorhersagen kann, um wie viel eine bestimmte Erhöhung der Vortrainingsdatenmenge die Leistung bei nachgelagerten Aufgaben verbessert, noch bevor das Experiment in vollem Umfang durchgeführt wird. Eine solche vorhersagbare Skalierungsbeziehung ist genau das Instrument, mit dem Entwickler großer Sprachmodelle bereits Jahre vor der Markteinführung dieser Modelle Trainingsläufe im Wert von mehreren hundert Millionen Dollar rechtfertigen konnten, denn ein zuverlässiges Skalierungsgesetz verwandelt einen teuren Trainingslauf von einer spekulativen Wette in eine vorhersehbare Investition. Sollte das Skalierungsgesetz von Figure auch bei noch größeren Datenmengen als dem bislang getesteten achtfachen Bereich gelten, bietet dies dem Unternehmen und seinen Investoren eine stichhaltige Grundlage, das Vortraining von „Index“ weiter auszubauen, anstatt Vermutungen über abnehmende Erträge anzustellen.
Diese Behauptung verdient dieselbe kritische Prüfung, die jede Ankündigung eines Skalierungsgesetzes durch ein einzelnes Unternehmen verdient, bevor sie als gesicherte Erkenntnis behandelt wird. Skalierungsgesetze, die von einem einzelnen Labor veröffentlicht und anhand des eigenen Benchmarks und der eigenen Hardware dieses Labors bewertet wurden, haben sich in anderen Bereichen manchmal als weniger robust erwiesen, sobald unabhängige Forscher versuchten, sie unter anderen Bedingungen zu replizieren, und Figure hat nicht angegeben, ob die Skalierungskurve von Helix 2.5 von externen Forschern bewertet oder auf einer anderen Roboterplattform reproduziert wurde. Der Test mit 30 Häusern ist dagegen ein Ergebnis, das sich schwerer anzufechten lässt, unabhängig davon, wie sich das zugrunde liegende Skalierungsgesetz letztendlich bewährt, da eine Erfolgsquote von 56 Prozent bei wirklich neuartigen
Umgebungen sind entweder wahr oder nicht wahr, im Gegensatz zu einer prognostizierten Skalierungskurve.Wo eine Erfolgsquote von 56 Prozent tatsächlich anzusiedeln ist
Eine Erfolgsquote von 56 Prozent bei der Aufgabenbewältigung ist kein fertiges Verbraucherprodukt, und Figure hat sie auch nicht als solches dargestellt. Das falsche Falten von Handtüchern, oder ein halb gemachtes Bett in fast der Hälfte aller Versuche in ungewohnten Haushalten zu hinterlassen, wäre für einen tatsächlichen zahlenden Kunden eine frustrierende Erfahrung, und die Kluft zwischen einem einmalig in 30 gemieteten Häusern durchgeführten Forschungs-Benchmark und einem Produkt, das jeden Tag in einem bestimmten Haushalt zuverlässig funktionieren muss – auf unbestimmte Zeit und ohne Anwesenheit eines Kamerateams oder eines Ingenieurteams –, ist beträchtlich. Diese Zahl ist jedoch nützlich für den Vergleich mit dem tatsächlichen Ausgangspunkt des Fachgebiets und nicht mit einem idealisierten Ziel: Eine Ausgangsbasis von 9 Prozent ohne Index-Vortraining bei genau denselben Aufgaben, derselben Hardware und demselben Bewertungsprotokoll bedeutet, dass der ehrliche Vergleich nicht „56 Prozent gegenüber Perfektion“ lautet, sondern „56 Prozent im Vergleich zu der Erfolgsquote von etwa einem Zehntel, die derselbe Roboter eine Generation zuvor erreicht hat“. Gemessen an dieser Basislinie stellt eine sechsfache Verbesserung in einer einzigen Modelliteration ein bedeutend schnelles Fortschrittsniveau für ein Fachgebiet dar, das sich in der Vergangenheit zwischen größeren Hardware- oder Software-Überarbeitungen stets in kleineren Schritten verbessert hat.
Die drei für die Bewertung ausgewählten Aufgaben – das Aufräumen eines Wohnzimmers, das Zusammenlegen von Handtüchern und das Bettenmachen – gehören zudem nicht zu den einfachsten Haushaltsaufgaben, die sich zur Demonstration eignen. Sie erfordern eine kontinuierliche, mehrstufige Planung anstelle einer einzelnen Greif- und Ablegeaktion, Toleranz gegenüber verformbaren Materialien wie Handtüchern und Bettwäsche, die keine feste Form beibehalten wie starre Objekte, sowie eine über einen Ganzkörper-Roboter mit zwei Armen koordinierte Navigation und Manipulation anstelle eines stationären Arms. Die Wahl von Aufgaben mit verformbaren Objekten und langfristigem Zeithorizont für einen Generalisierungs-Benchmark anstelle einer einfacheren „Pick-and-Place“-Demonstration, die wahrscheinlich eine höhere reine Erfolgsquote erzielen würde, deutet darauf hin, dass Figure seine
ein öffentlicher Maßstab für die Glaubwürdigkeit bei technisch versierten Käufern und Wettbewerbern und nicht für die möglichst schmeichelhafte Schlagzeilenzahl, obwohl das Unternehmen natürlich jedes Interesse daran hat, seine eigenen Ergebnisse unabhängig von der Wahl der Aufgabe in einem günstigen Licht darzustellen.Was dies für alle bedeutet, die sich mit demselben Problem befassen
Jedes Unternehmen, das einen universell einsetzbaren humanoiden Roboter für den Hausgebrauch entwickelt – von finanzstarken Konkurrenten mit eigenen Modellen für Sehen, Sprache und Handeln bis hin zu Zulieferern, die die Aktuatoren und Sensoren herstellen, auf denen diese Modelle letztendlich laufen werden –, stößt auf dieselbe grundlegende Einschränkung: Aufgabenspezifische Trainingsdaten lassen sich nicht schnell genug skalieren, um die nahezu unendliche Vielfalt an realen Wohnräumen, Objekten und Randfällen abzudecken, denen ein kommerzieller Haushaltsroboter letztendlich begegnen wird. Sollte ein groß angelegtes Vortraining auf der Grundlage umfassenderer Daten aus der menschlichen Lebenserfahrung tatsächlich einen bedeutenden Teil dieser teuren und nur langsam zu erfassenden aufgabenspezifischen Daten ersetzen – wie der von Figure durchgeführte kontrollierte Vergleich von 9 bis 56 Prozent nahelegt –, dann verlagert sich der Wettbewerbsvorteil in der humanoiden Robotik weiter hin zu jenen Unternehmen, die die größte Menge an allgemeinen Daten zur physischen Lebenserfahrung beschaffen, verarbeiten und trainieren können, und nicht nur bei den Unternehmen, die über die leistungsfähigste Roboterhardware oder die größte bereits im Einsatz befindliche Flotte zur Erfassung aufgabenspezifischer Demonstrationen verfügen.
Diese Verschiebung hat direkte Auswirkungen auf Käufer und Investoren, die humanoide Robotikunternehmen über die nächsten Produktzyklen hinweg bewerten: Die aktuelle Flottengröße eines Unternehmens und sein aktueller aufgabenspezifischer Datensatz – die Kennzahlen, mit denen die meisten Start-ups im Bereich der humanoiden Robotik in ihrem eigenen Marketing werben – könnten für die langfristige Wettbewerbsfähigkeit weniger von Bedeutung sein als die Frage, ob dieses Unternehmen über eine Vortrainings-Pipeline und eine Strategie zur Datenbeschaffung verfügt oder diese aufbauen kann, die mit dem „Index“-Ansatz von Figure vergleichbar sind. Ein Konkurrent, der heute zwar über eine größere Flotte im Einsatz verfügt, aber keine gleichwertige Vortrainingsarchitektur besitzt, könnte feststellen, dass er sich in neuen Umgebungen weitaus langsamer anpasst als ein Wettbewerber mit weniger Robotern im Einsatz, der jedoch
ein besseres Grundmodell, auf dem sie basieren.Der nächste Test für Helix 2.5 ist keine weitere Forschungsbewertung mit 30 Haushalten. Es geht vielmehr darum, in welchem beliebigen Haushalt ein zahlender Kunde den Roboter schließlich an einem ganz normalen Dienstag unbeaufsichtigt hereinlässt – ohne dass ein Technikteam bereitsteht und ohne ein im Voraus festgelegtes Benchmark-Protokoll, das den Erfolg definiert –, um die Berge von Wäsche zu waschen und die ungemachten Betten zu machen, die niemals vermietet, für Besichtigungen hergerichtet oder für eine Pressemitteilung ausgewählt wurden.
Diese Analyse stützt sich auf öffentliche Erklärungen und technische Ergebnisse, die von Figure AI bezüglich des Modells Helix 2.5 und dessen Bewertung veröffentlicht wurden. Sie dient ausschließlich allgemeinen Informationszwecken und stellt keine Anlage-, Finanz- oder Rechtsberatung dar.
Bildnachweis für das Titelbild: Figure AI.









