
《Figure's Helix 2.5》成功清除 30 個它從未見過的家園
Figure AI 的 Helix 2.5 模型將 30 個陌生家庭中的零樣本任務成功率,從 9% 提升至 56%,藉此驗證「泛化能力」對家用機器人而言究竟意味著什麼。

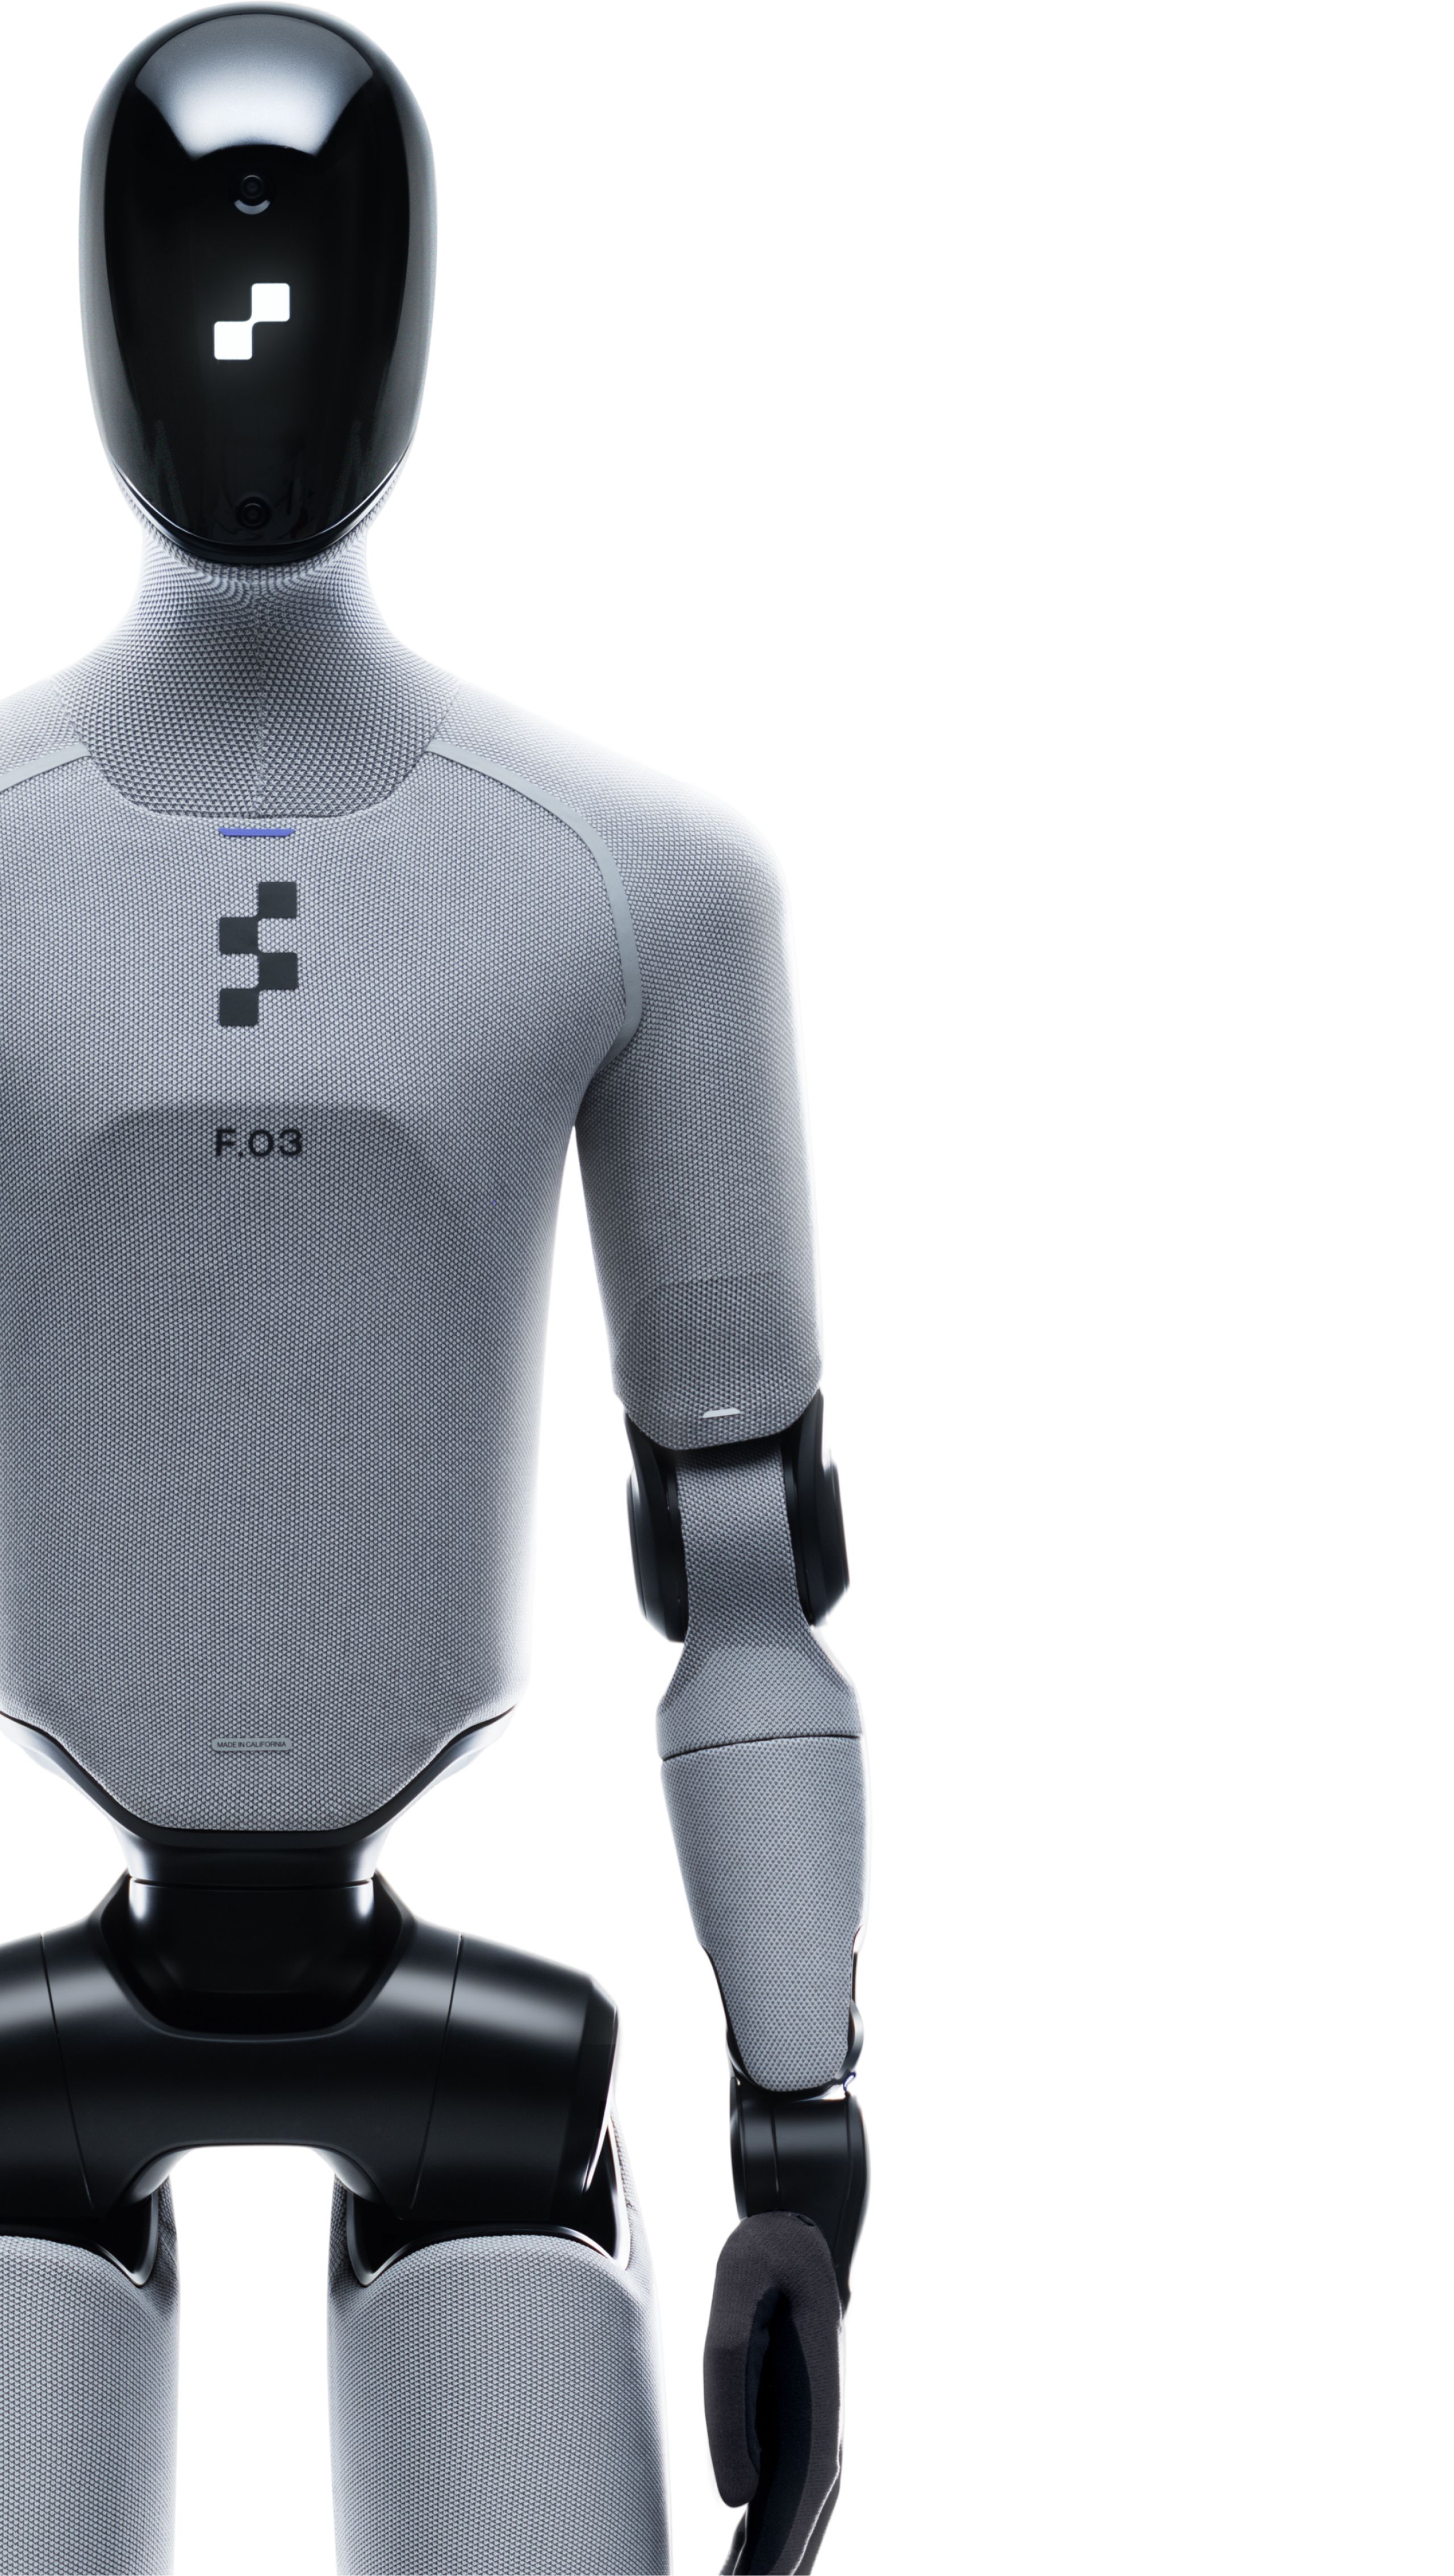
家用機器人領域中最棘手的問題,從來都不是讓類人型機器人折一次毛巾。真正的難題在於,要讓同一個機器人在從未踏足過的屋子裡、在從未見過的床上、用從未接觸過那種特定布料的雙手來折疊毛巾。 Figure AI 表示,其最新的控制模型「Helix 2.5」本月已跨越這道門檻,在舊金山灣區的 30 處陌生住宅中執行三項家務任務,過程中未進行額外的資料蒐集、 微調或現場適應的情況下,於舊金山灣區 30 處陌生的住宅中成功執行三項家務任務,並達成 56% 的任務成功率,相較於未經該模型大規模預訓練步驟時,執行相同任務的 9% 基準成功率顯著提升。 對於過去兩年來一直致力於證明人形機器人能在單一、經過仔細排練的環境中展現出色表現的產業而言,在互不相關的實體空間中實現零樣本泛化能力的真正飛躍,是一種截然不同的成果,而這正是決定家用機器人究竟是「展示類別」還是「產品類別」的關鍵。
位於灣區的人形機器人公司 Figure AI,不僅開發了 Figure 03 機器人硬體,也打造了用於控制該機器人的 Helix 視覺-語言-動作模型。該公司租用了 30 間從未進行過運作測試的住宅,並在每間住宅內測試了三項長期行為: 整理客廳、摺疊毛巾以及鋪床,所有操作皆利用該特定住宅中現有的家具、表面及物品進行。沒有任何住宅被用作訓練數據,且機器人抵達後也未進行任何任務特定的適應調整。這項測試設計正是關鍵所在。 在公司自家展示廳內進行的機器人示範——其照明、家具及物品擺放皆經事先調整——僅能證明該模型在理想條件下能正常運作;而在 30 間該模型從未見過的住宅中進行的「冷啟動」測試,則更貼近實際客戶在第一天所面臨的客廳情境。
Helix 與 Helix 2.5 之間的變化
圖所稱的「Index」,正是這項飛躍背後的機制
預訓練,這是一個大規模的預訓練階段,其處理人類物理經驗資料的速度,據該公司描述,約為每秒收集 35 分鐘的人類經驗資料,遠遠超出僅靠特定任務的機器人示範資料所能提供的量。 與其針對每種新行為,直接使用經過精選的、特定任務的機器人示範來訓練模型,Figure 首先會以更廣泛的人類經驗資料集對單一基礎模型進行預訓練,接著將同一預訓練好的基礎模型適應於涵蓋移動、剛體與可變形物體操作、雙手協調以及主動感知等不同下游行為。 在將任務特定資料、機器人硬體、訓練流程及評估協議固定不變,僅變更是否包含該「Index」預訓練步驟的情況下,該公司報告指出,在 30 項居家評估任務中的零樣本成功率從 9% 提升至 56%。 對於機器人領域的公告而言,這是一項異常嚴謹的實驗設計:多數類人型機器人公司僅報告單一的頭條數據,卻未釐清是哪項架構變更帶來了此成果;而 Figure 決定公布這項受控對比實驗,本身即具實質參考價值,因為這讓外部研究人員得以評估,究竟是預訓練方法——而非其他未公開的變更——真正發揮了作用。效率的提升進一步強化了泛化能力的成果。 Figure 表示,Helix 2.5 所需的任務特定數據量,僅需早期 Helix 02 模型中代表性行為所需的一半,即可達到相當或更佳的表現;這點至關重要,因為任務特定的機器人示範數據——即透過真實機器人執行實際任務所記錄的物理試驗——是整個訓練流程中最昂貴的輸入資源。 收集此類資料需要耗費機器人硬體時間、人力操作,且通常還需人工標註;與其相較,大型語言模型所使用的網路文本或圖像資料則具備更佳的可擴展性。若在更廣泛的
如果人類經驗數據確實能取代那部分昂貴且針對特定任務的資料收集工作中的相當大比例,那麼這不僅會改變家用機器人模型最終的性能上限,還會改變訓練該模型的單位經濟效益。頭條數字背後的尺度律主張
Figure 除了一般化結果外,還同步發布了一項尺度律分析,指出在測試過的最大預訓練運行中,其預測誤差僅佔預訓練資料量八倍範圍內總變異量的 0.54%。 淺顯地說,該公司聲稱在執行全面實驗之前,便能以高精度預測預訓練資料的特定增量,將如何提升下游任務的表現。 這種預測性的比例關係,正是讓大型語言模型開發者在模型正式推出數年前,便能為數億美元的訓練計畫辯護的工具——因為可靠的尺度律,能將昂貴的訓練計畫從一場投機賭注轉變為可預測的投資。 倘若 Figure 的規模律在比迄今測試過的八倍範圍更大的數據量下依然成立,這將為該公司及其投資者提供一個站得住腳的依據,使其能持續擴大 Index 的預訓練規模,而非在遞減回報的情況下憑空猜測。
在將此說法視為定論之前,這項主張理應像任何單一公司公布的規模定律那樣,接受同樣嚴格的檢視。 由單一實驗室發表、且僅基於該實驗室自身基準測試與硬體進行評估的規模化定律,在其他領域中,一旦獨立研究人員嘗試在不同條件下進行重現,有時會被證明不夠穩健;而 Figure 尚未說明 Helix 2.5 的規模化曲線是否已由外部研究人員進行評估,或在不同的機器人平台上重現過。 相較之下,那項涵蓋 30 個家庭的測試,無論其基礎的尺度律最終能否成立,其結果都更難被質疑,因為在真正創新的
環境條件要麼成立,要麼不成立,這一點與預測的縮放曲線不同。56% 的任務成功率究竟代表什麼
56% 的任務成功率並非成品,而 Figure 也從未將其呈現為成品。在陌生住處近半數的嘗試中,若發生毛巾摺疊錯誤、 或讓床鋪只整理了一半——若在陌生住處的近半數嘗試中都發生這種情況,對實際付費的客戶而言將是極其沮喪的體驗;而且,在 30 間租賃房屋中僅執行一次的研究基準測試,與必須在特定住宅中每天、無止境地穩定運作的產品之間——且無需攝製組或工程團隊在場——存在著巨大的差距。 這個數字的價值在於與該領域的實際起點進行比較,而非與理想化的目標對比:在完全相同的任務、硬體和評估協議下,未經 Index 預訓練的 9% 基準值意味著,客觀的比較並非「56% 對比完美」, 而是「56% 對比上一代同款機器人大約十分之一的成功率」。以該基準來衡量,單次模型迭代便實現六倍的提升,對於這個歷史上通常在重大硬體或軟體更新之間僅有微小進步的領域而言,這是一項極具意義的快速進展。
此次評估選定的三項任務——整理客廳、摺疊毛巾以及鋪床——也並非最容易用來展示的家庭雜務。 這些任務需要持續的多步驟規劃,而非單純的「抓取並放置」動作;需要對毛巾和床單等可變形材料具備容錯能力——這些材料不像剛性物體那樣能保持固定形狀;同時還需透過全身雙臂機器人進行協調的導航與操作,而非僅靠靜止的機械臂。 選擇長週期、涉及可變形物體的任務作為泛化基準測試,而非可能展現更高原始成功率的簡單「拾取並放置」示範,這顯示 Figure 正在優化其
這項測試旨在為具備技術知識的買家和競爭對手提供可信度的公開基準,而非追求盡可能亮眼的頭條數字;儘管無論選擇何種測試任務,該公司顯然都有充分的動機將自身結果呈現得盡可能有利。這對所有致力解決相同問題的企業意味著什麼
每一家致力於開發家用通用類人型機器人的公司——無論是擁有雄厚資金、具備專屬視覺-語言-動作模型的競爭對手,還是為這些模型最終運行所需的致動器和感測器提供組件的供應商——都在朝著同一個根本性限制奔馳: 任務專用的訓練資料無法快速擴展,以涵蓋商用家用機器人最終將遭遇的、近乎無限多樣的真實住宅、物體及邊緣案例。 如果基於更廣泛人類經驗數據的大規模預訓練,真能替代那部分昂貴且難以快速蒐集的任務特定數據中相當大比例——正如 Figure 那項 9% 至 56% 的受控對比所示——那麼人形機器人領域的競爭優勢,將進一步轉向那些能夠蒐集、處理、 並以此進行訓練的公司,而不僅僅是擁有最先進機器人硬體,或是已部署最大規模機隊來蒐集特定任務示範資料的公司。
這種轉變對未來幾個產品週期內評估人形機器人公司的買家和投資者具有直接影響: 企業當前的機器人機隊規模與特定任務資料集——這些是多數類人型新創公司在行銷時最常強調的指標——對於長期競爭力的影響,可能遠不如該公司是否擁有(或能夠建立)一套與 Figure 的「Index」方法相媲美的預訓練流程及資料蒐集策略來得重要。 一家目前部署機器人數量較多,但缺乏同等預訓練架構的競爭對手,其在新環境中的泛化能力,可能會遠遠落後於現場機器人數量較少、但
為它們提供更完善的基礎模型。Helix 2.5 的下一項考驗,並非又一項針對 30 戶家庭的研究評估。 而是當某位付費客戶最終在一個普通的星期二,讓這台機器人無需監督地進入家中——此時既無工程團隊待命,也無預先定義成功標準的基準測試協議——去處理那些從未被租用、佈置過或選為新聞稿素材的髒衣物與未整理的床鋪。
本分析基於 Figure AI 針對 Helix 2.5 模型及其評估所發布的公開聲明與技術成果。本文僅供一般資訊參考,不構成投資、財務或法律建議。
首圖來源:Figure AI。













