
小米发布Robotics-1,搭载10万小时的具身训练数据
小米机器人发布了“Robotics-1”视觉-语言-动作模型,该模型基于超过10万小时的真实世界运动轨迹数据进行训练,旨在解决具身人工智能领域中的数据匮乏瓶颈。
由于一个根本性的制约因素——数据匮乏,机器人行业在很大程度上错过了人工智能领域的规模化热潮。尽管大型语言模型能够吞噬整个互联网,但传统的机器人轨迹标注仍需根据任务语义和语言注释进行人工分割。这一劳动密集型过程限制了策略模型的扩展能力。 2026年7月16日,小米机器人发布了“Xiaomi-Robotics-1”——一款基于超过10万小时真实世界操作轨迹训练而成的即用型机器人基础模型,证明了大规模无具身预训练能够突破机器人数据瓶颈。
作为全球消费电子和智能制造企业旗下的机器人业务部门,小米机器人专注于开发先进的机器人系统和具身人工智能。“小米-机器人-1”的发布,标志着其在构建可扩展、通用型机器人控制模型方面迈出了重要一步。 该模型专为真实环境中的移动操作任务而设计,例如整理沙发、整理鞋柜、收纳厨具、手机打包、打印机加墨、洗衣机装衣和纸箱打包等家务劳动。 其核心技术突破在于证明:大规模无具身预训练能够突破机器人数据瓶颈,实现可预测的扩展性,从而提升真实机器人的开箱即用性能。
小米的数据和基准测试证据证明了什么?在已报告的评估场景之外,哪些内容仍未得到证实?
小米的证据证实,大规模无具身预训练能够提升开箱即用的真实机器人性能,并实现高数据效率——每项任务仅需不到10小时的演示即可达到75%的成功率。然而,该模型在非结构化、
在已报告的评估场景之外的新环境中,其效果尚未得到验证,因为训练后评估主要依赖于在特定真实家庭中收集的内部数据。发布规模与训练架构
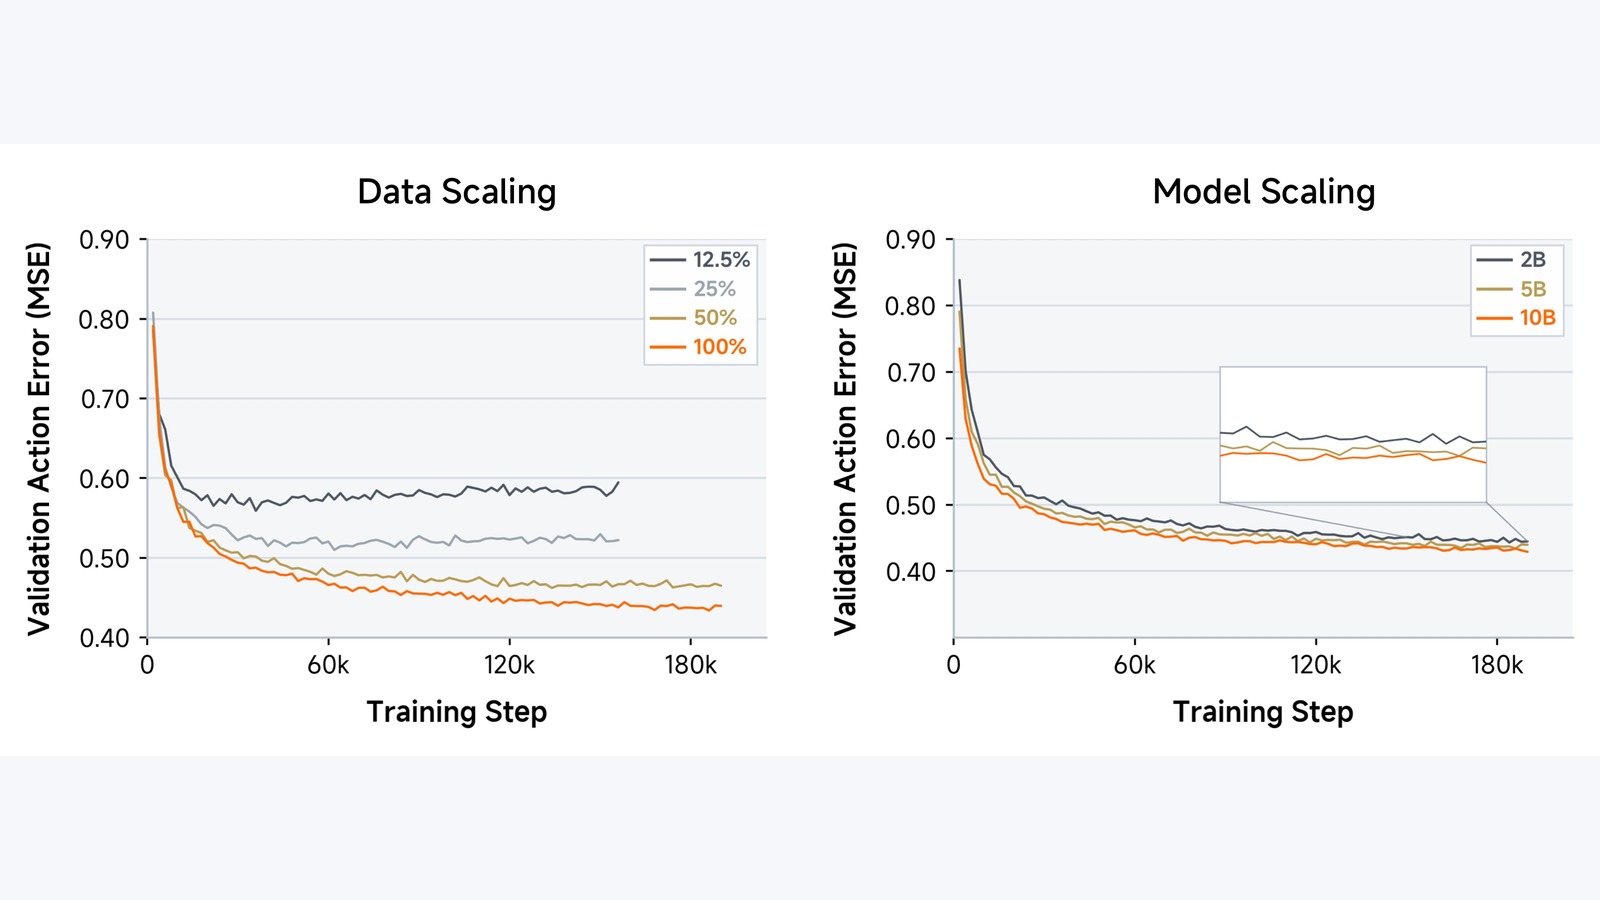
Xiaomi-Robotics-1 的核心成就在于其海量的训练数据。该模型是一个基于超过 10 万小时真实世界操作轨迹训练的视觉-语言-动作系统。 这一规模在开源机器人领域前所未有,直接解决了长期阻碍通用机器人策略发展的数据匮乏问题。该模型的性能会随着数据量和模型规模的增加而可预测地提升,这种可扩展性意味着其在未见环境中的开箱即用真实机器人性能将更优。
训练过程分为两个截然不同的阶段。预训练阶段利用了 100,000 小时的无具身化轨迹数据,涵盖 1,700 多个场景,包括家庭、商业场所、工业场所和户外空间。 为处理这一海量数据集,我们采用基于视觉-语言模型的自动标注管道来描述状态转换。 后训练阶段使用了超过10,000小时的跨具身数据集,其中包括在真实家庭环境中采集的超过7,200小时的内部真实机器人数据、经过筛选的开源机器人数据以及高质量的无具身数据。 该阶段旨在使模型与真实的机器人实体及遵循指令的能力相匹配。
其底层架构采用“变压器混合模型”(Mixture-of-Transformers),将预训练的视觉语言模型(具体为 Qwen3-VL)与扩散变压器相结合。这种组合使模型能够处理复杂的视觉和语言输入,并将其转化为精确、连续的控制动作。 扩散变压器的应用尤为值得关注,因为它能够生成平滑的、
高保真轨迹,这对精细操作任务至关重要。这种架构选择反映了具身人工智能领域日益形成的共识:将大型语言模型的推理能力与扩散模型的生成能力相结合,是通向通用机器人控制的最有前景的道路。将技术复杂性转化为人类关切
试想一下,你要教一个孩子打扫房间,却只能向他演示如何在某个特定角落捡起一件特定的玩具。 一旦你移动玩具或更换房间,孩子就会完全不知所措。这就是传统机器人的学习方式。它们需要针对任务的每一种变体都进行费时费力的手动指导。Xiaomi-Robotics-1 通过让机器人观看 10 万小时的人类在数千个不同房间中做家务的视频,改变了这一现状。 机器人不再局限于学习某个特定动作,而是掌握了“整理”这一通用概念,从而能够更快地适应新的房间和新的物品。它弥合了狭隘的预设动作与通用、可适应行为之间的鸿沟。
这种从任务特定编程向泛化学习的转变,正是具身人工智能的核心承诺。这意味着机器人最终能够部署在从未见过的环境中,执行未被明确编程的任务。对于医院管理人员而言,这意味着机器人无需预先规划路线,就能在拥挤的走廊中自主导航并运送物资。 对于仓库经理而言,这意味着系统能够处理新型包装,而无需耗费数周时间重新编程。这项技术对人类的影响深远,因为它有潜力将大量体力劳动自动化,从而从根本上改变工作的性质和生产力。
部署现实:理论与实践的对比
仿真基准测试尽管基准测试结果令人印象深刻,但必须区分在受控环境下经过验证的能力与在现实世界中的部署验证。 该模型在四个主流仿真基准测试中均取得了最先进的结果:RoboCasa(74.5%)、RoboCasa365(57.4%)、VLABench(59.1%)和RoboDojo(13.93)。 该模型还展现出极高的数据效率,平均每个新任务仅需不到10小时的演示数据即可完成适应。
然而,实际部署的复杂性往往远超模拟基准测试所体现的程度。训练后阶段主要依赖于在真实家庭环境中收集的超过 7,200 小时的内部真实机器人数据。尽管这是一套规模可观的数据集,但它所涵盖的环境仍属有限。 对 Xiaomi-Robotics-1 的真正考验,将在于其在与训练数据存在显著差异的非结构化、新型环境中的表现。从成功的演示到可靠且可扩展的部署之间存在的差距,仍然是机器人行业面临的一大障碍。
许多观察者认为,在基准测试中取得高成功率就直接意味着具备商业可行性。但残酷的现实是,在大多数商业应用中,75%的成功率是无法接受的。在制造环境中,一台25%的时间都会掉落零部件的机器人是负担,而非资产。在医疗保健环境中,对错误的容忍度甚至更低。 要将研究突破转化为可部署的产品,必须弥合这一可靠性差距,这通常需要进行大量针对具体现场的工程设计和严格的安全测试。基准测试证明了模型能够高效学习,但并不能证明它已准备好在关键应用中进行无监督部署。
开放式机器人架构与性能指标的对比
该官方报告将“小米机器人-1”与pi0基准模型进行了对比,突出了其在任务成功率方面的显著提升,特别是在仅通过极少真实机器人演示即可适应新任务方面。
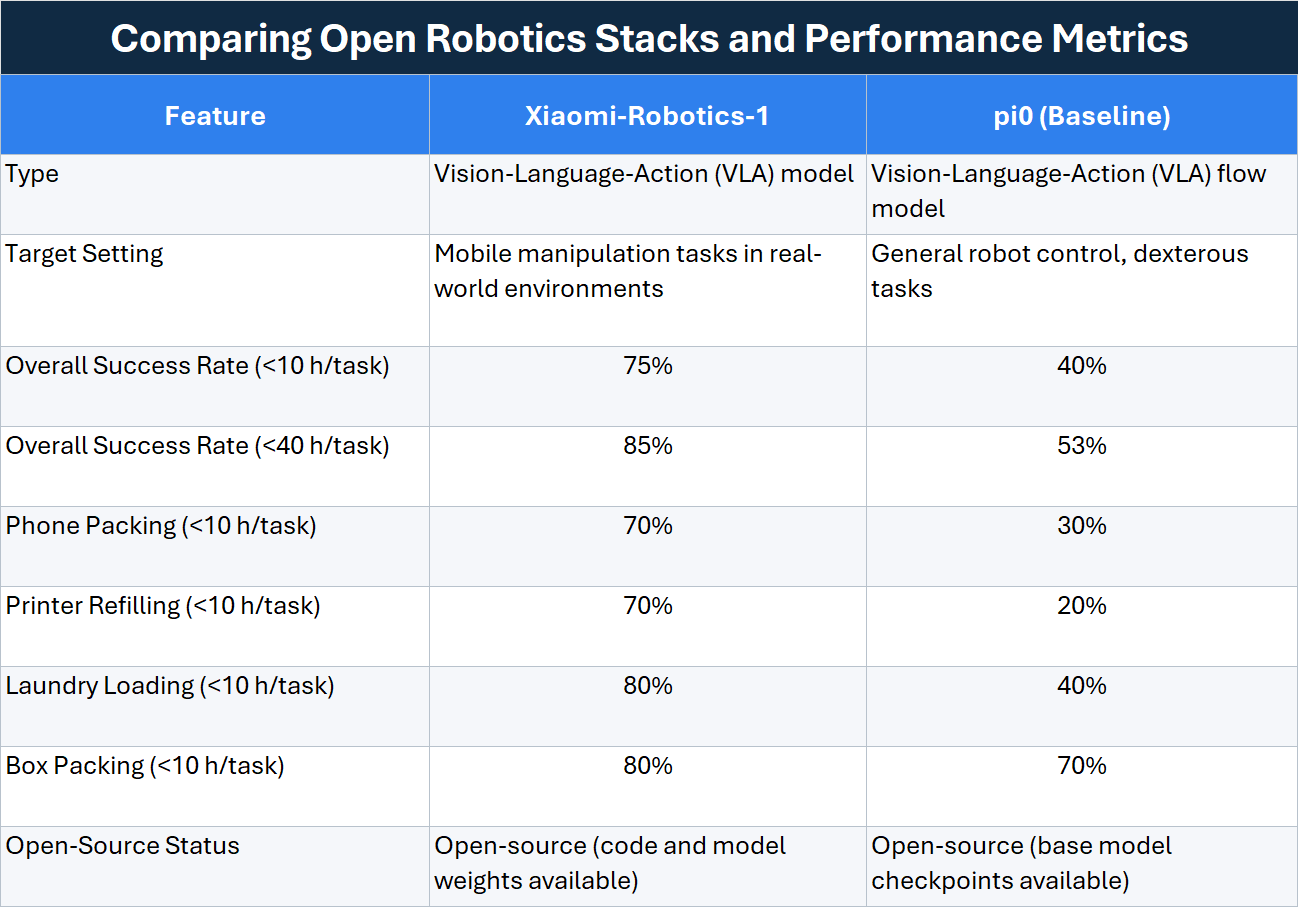
注:数据基于在仅需极少真实机器人演示的情况下高效适应新任务的情况。在小米-Robotics-1官方报告中,pi0被用作主要基线模型。
对比结果显示,数据效率实现了显著飞跃。仅凭不到10小时的任务专用数据便达到75%的总体成功率,这是一个关键里程碑。这表明预训练阶段成功使模型掌握了对物理交互的稳健理解,使其能够基于少量演示实现泛化。 这一点在洗衣机装衣等复杂任务中尤为明显:Xiaomi-Robotics-1 在此类任务中实现了 80% 的成功率,而基线模型的成功率仅为 40%。
对自动化采购方的商业与运营意义
Xiaomi-Robotics-1作为开源模型发布,其源代码和模型权重均已公开,这对机器人研究人员和开发者具有重要意义。通过提供基于海量数据集训练的即用型基础模型,小米降低了开发先进机器人系统的门槛。这有望加速各行业新应用的开发与部署。
“Xiaomi-Robotics-1 证明,大规模的无具身预训练能够突破机器人数据瓶颈,实现可预测的扩展,从而带来更出色的开箱即用型真实机器人性能。”
对于采购团队和
对于自动化领域的采购方而言,像 Xiaomi-Robotics-1 这样的开源基础模型的出现带来了新的考量。虽然这些模型具备强大的功能,但在实施和适应具体应用场景时,也需要相当高的技术专业知识。该模型需要经过两阶段的训练过程,并且依赖于复杂的架构。 采购方必须权衡这些先进模型的潜在优势与集成挑战以及对专业工程人才的需求。此外,该模型的开源性质改变了机器人市场的竞争格局。它提供了一种功能强大的替代方案,既可定制又无需支付许可费,从而对专有模型构成了挑战。 然而,总体拥有成本必须考虑训练后和推理所需的计算资源,以及将模型集成到特定硬件平台所需的工程投入。
机器人行业正从狭窄的、针对特定任务的编程范式,转向通用化的、数据驱动的学习范式。“小米机器人-1”正是这一转变的明确信号,彰显了大规模数据采集和预训练的强大威力。 随着这些模型的持续改进和普及,它们将从根本上改变机器人开发、部署以及融入我们日常生活的方式。随着系统智能成为主要差异化因素,关注重点将日益从硬件设计转向数据采集和模型训练。
本分析综合了公司声明以及公开的市场或政策信息。
免责声明:本文仅供参考,不构成投资、财务、法律、采购或其他专业建议。读者应自行核实规格、价格、供货情况及监管要求
在做出决定之前,请直接与相关公司或主管部门确认具体要求及商业条款。










