
Xiaomi、10万時間の体現型トレーニングデータを搭載した「Robotics-1」を発表
Xiaomi Roboticsは、具現化AIにおけるデータ不足という課題を解決するため、10万時間以上の実世界の軌跡データを用いて学習させた「Robotics-1 Vision-Language-Action」モデルを公開した。
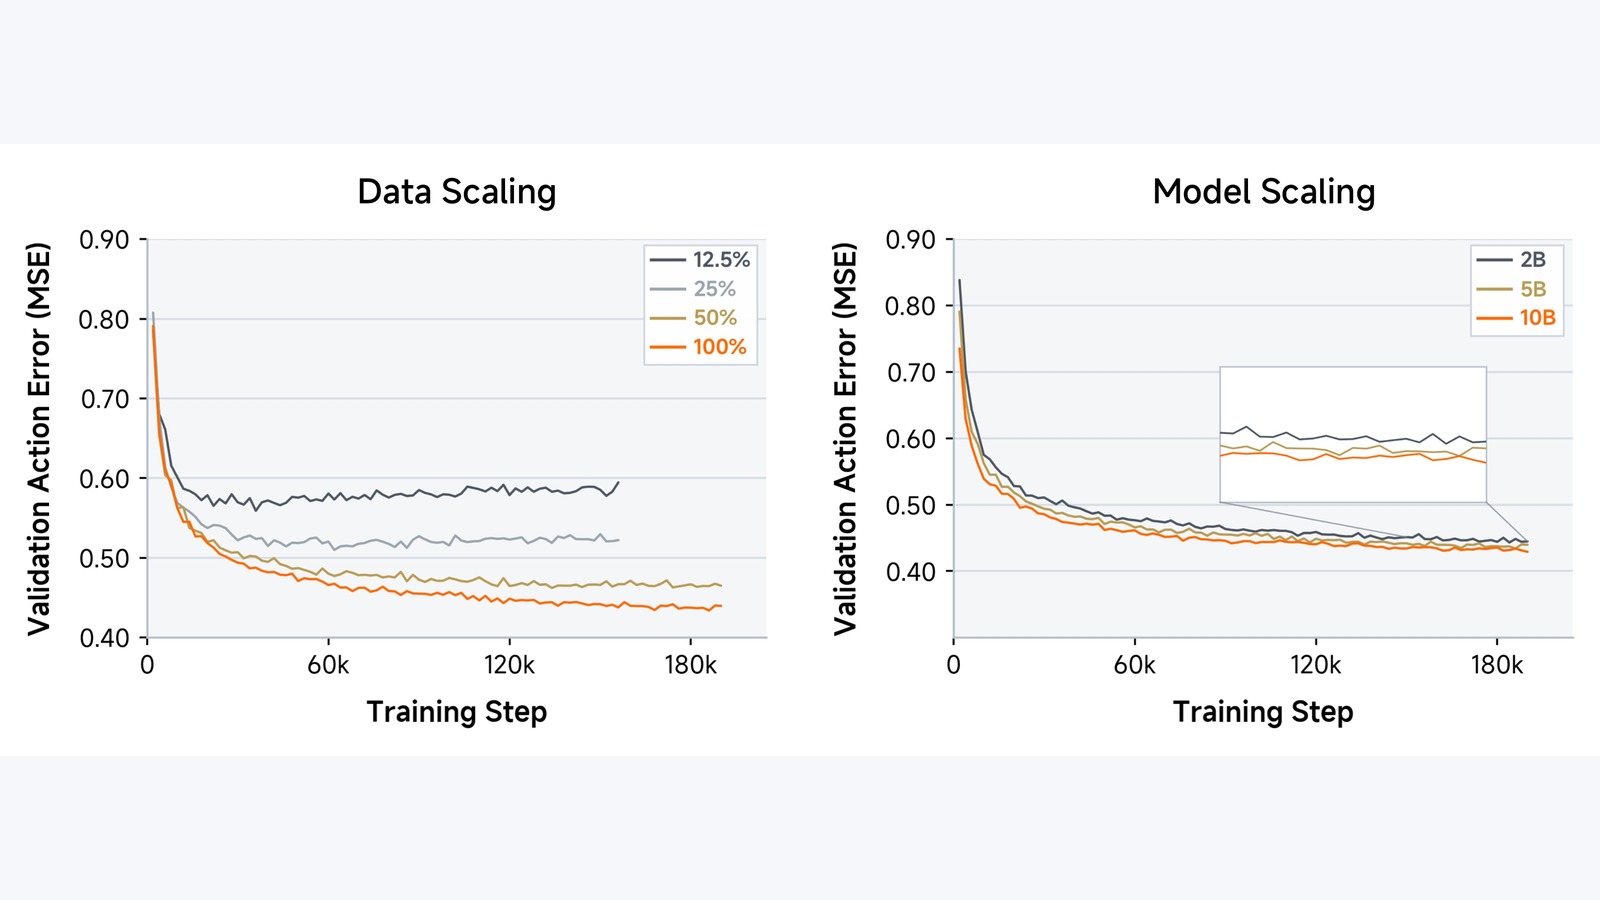
ロボット産業は、データ不足という根本的な制約により、人工知能分野における大規模化の波をほとんど捉えられてきませんでした。大規模言語モデルがインターネット上のあらゆる情報を処理する一方で、従来のロボットの軌跡ラベリングでは、タスクのセマンティクスや言語によるアノテーションに基づく手作業でのセグメンテーションが必要とされていました。この労働集約的なプロセスが、ポリシーモデルの拡張可能性を制限していたのです。 2026年7月16日、Xiaomi Roboticsは、10万時間以上の実世界における操作軌跡で学習された、すぐに使えるロボット基盤モデル「Xiaomi-Robotics-1」をリリースし、大規模なエンボディメントフリーの事前学習によってロボットのデータボトルネックを打破できることを実証した。
世界的な家電・スマート製造企業であるシャオミのロボット事業部門であるXiaomi Roboticsは、先進的なロボットシステムと体現型人工知能の開発に注力しています。「Xiaomi-Robotics-1」のリリースは、スケーラブルで汎用的なロボット制御モデルを構築するための同社の取り組みにおける重要な一歩となります。 このモデルは、ソファの整理、靴箱の整理、台所用品の片付け、携帯電話の梱包、プリンターのインク補充、洗濯物の投入、箱詰めなどの家事を含む、実世界環境における移動型操作タスク向けに設計されています。 中核となる技術的成果は、大規模なエンボディメントフリーの事前学習によってロボットのデータボトルネックを打破し、予測可能なスケーラビリティを実現することで、実ロボットにおける「箱から出してすぐ」の性能向上につながることを実証した点にある。
Xiaomiのデータとベンチマーク結果は何を立証しており、報告された評価設定以外ではまだ証明されていないことは何でしょうか?
Xiaomiの証拠は、大規模なエンボディメントフリーの事前学習が、実ロボットにおける「箱から出してすぐ」の性能を向上させ、高いデータ効率を実現し、タスクごとに10時間未満のデモンストレーションで75%の成功率を達成することを立証している。しかし、構造化されていない環境におけるモデルの信頼性については、
報告された評価環境以外の新たな環境における有効性については、トレーニング後の検証が特定の実際の住宅で収集された社内データに大きく依存していたため、依然として実証されていない。リリース規模と学習アーキテクチャ
Xiaomi-Robotics-1の最大の成果は、その膨大な量の学習データにある。このモデルは、10万時間以上に及ぶ実世界の操作軌跡を用いて学習された、ビジョン・言語・アクション(VLA)システムである。 この規模はオープンソースのロボティクス分野において前例がなく、汎用的なロボットポリシーの開発を阻害してきたデータ不足の問題に直接対処するものである。本モデルはデータ量とモデルサイズに応じて予測可能なスケーリングを示し、このスケーリングにより、未見の環境においても、実ロボットによる「箱から出してすぐ」の性能が向上する。
学習プロセスは、2つの異なる段階で構成されています。事前学習段階では、家庭、商業施設、工業用地、屋外空間など、1,700以上のシナリオにまたがる10万時間のエンボディメントフリーな軌跡データを活用しています。 この膨大なデータセットを処理するため、状態遷移を記述するビジョン・言語モデルを活用した自動アノテーションパイプラインが使用されている。 ポストトレーニング段階では、実際の家庭で収集された7,200時間以上の社内実ロボットデータ、フィルタリングされたオープンソースのロボットデータ、および高品質なエンボディメントフリーデータを含む、10,000時間以上のクロスエンボディメントデータセットが使用されます。 この段階では、モデルを実際のロボットの具現化形態や指示に従う能力と整合させます。
基盤となるアーキテクチャは「Mixture-of-Transformers」であり、事前学習済みのビジョン・言語モデル(具体的にはQwen3-VL)とディフュージョン・トランスフォーマーを組み合わせたものです。この組み合わせにより、モデルは複雑な視覚的および言語的入力を処理し、それらを正確かつ連続的な制御動作に変換することが可能になります。 特に注目すべきはディフュージョン・トランスフォーマーの採用であり、これにより滑らかな、
繊細な操作タスクに不可欠な、高精度な軌道。このアーキテクチャの選択は、大規模言語モデルの推論能力と拡散モデルの生成能力を組み合わせることが、汎用ロボット制御に向けた最も有望な道であるという、体現型人工知能コミュニティにおける合意の高まりを反映している。技術的な複雑さを人間の関心事へと変換する
子供に部屋の片付けを教えようとしているが、特定の隅にある特定のおもちゃを拾う方法しか見せられない状況を想像してみてください。 おもちゃの位置を変えたり、部屋を変えたりすると、子どもは完全に途方に暮れてしまいます。これが従来のロボットの学習方法です。タスクのあらゆるバリエーションに対して、手間のかかる手動による指導が必要となります。Xiaomi-Robotics-1は、ロボットに数千もの異なる部屋で家事をこなす人々の様子を10万時間分観察させることで、この状況を一変させます。 特定の動作を一つずつ覚えるのではなく、ロボットは「片付け」という一般的な概念を学習するため、新しい部屋や新しい物にもはるかに迅速に適応できるようになります。これは、狭義のプログラムされた動作と、汎用的で適応性のある行動との間のギャップを埋めるものです。
タスク特化型のプログラミングから一般化された学習へのこの転換こそが、具現化された人工知能が持つ根本的な可能性です。これは、ロボットが最終的には、これまで見たことのない環境でも、明示的にプログラムされていないタスクを実行できるようになることを意味します。病院の管理者にとっては、事前にルートが設定されていなくても、混雑した廊下を移動して物資を届けることができるロボットが実現するということです。 倉庫管理者にとっては、数週間にわたる再プログラミングを必要とせずに、新しい種類の梱包に対応できるシステムが実現することを意味する。この技術は、広範な肉体労働を自動化する可能性を秘めており、仕事の本質や生産性を根本的に変えるため、人間にとっての利害関係は極めて大きい。
導入の現実:実証 versus
シミュレーションのベンチマークベンチマークの結果は目覚ましいものですが、制御された環境下での実証済みの性能と、実世界での実用性を明確に区別することが極めて重要です。 このモデルは、4つの主要なシミュレーションベンチマーク(RoboCasa(74.5%)、RoboCasa365(57.4%)、VLABench(59.1%)、RoboDojo(13.93))において、最先端の結果を達成しています。 また、高いデータ効率も示しており、新しいタスクへの適応には、タスクあたり平均10時間未満のデモンストレーションで済んでいます。
しかし、実環境での展開の現実は、シミュレーションベンチマークが示唆するよりもはるかに複雑な場合が多い。トレーニング後の段階では、実際の家庭で収集された7,200時間以上に及ぶ社内実ロボットデータに大きく依存していた。これは膨大なデータセットではあるが、それでも有限の環境セットに過ぎない。 Xiaomi-Robotics-1の真価が問われるのは、トレーニングデータとは大きく異なる、構造化されていない新規環境における性能である。デモンストレーションの成功と、信頼性が高くスケーラブルな実運用との間には依然として大きな隔たりがあり、これはロボット産業にとって重大な障壁となっている。
多くの観察者は、ベンチマークでの高い成功率がそのまま商業的な実現可能性につながると想定している。しかし厳しい現実として、75%という成功率は、ほとんどの商用アプリケーションにおいて許容できない水準である。製造現場において、25%の確率で部品を落下させるロボットは、資産ではなく負債となる。医療現場では、エラーに対する許容度はさらに低い。 研究上のブレークスルーから実用可能な製品への移行には、この信頼性のギャップを埋める必要があり、それには多くの場合、現場に特化した大規模なエンジニアリングや厳格な安全性試験が伴います。ベンチマークは、モデルが効率的に学習できることを証明するものではありますが、重要な用途において教師なしでの導入が可能であることを証明するものではありません。
オープンロボティクス・スタックと性能指標の比較
公式レポートでは、Xiaomi-Robotics-1をpi0ベースラインと比較しており、特に実ロボットのデモンストレーションを最小限に抑えて新しいタスクに適応する場合において、タスクの成功率が大幅に向上していることが強調されている。
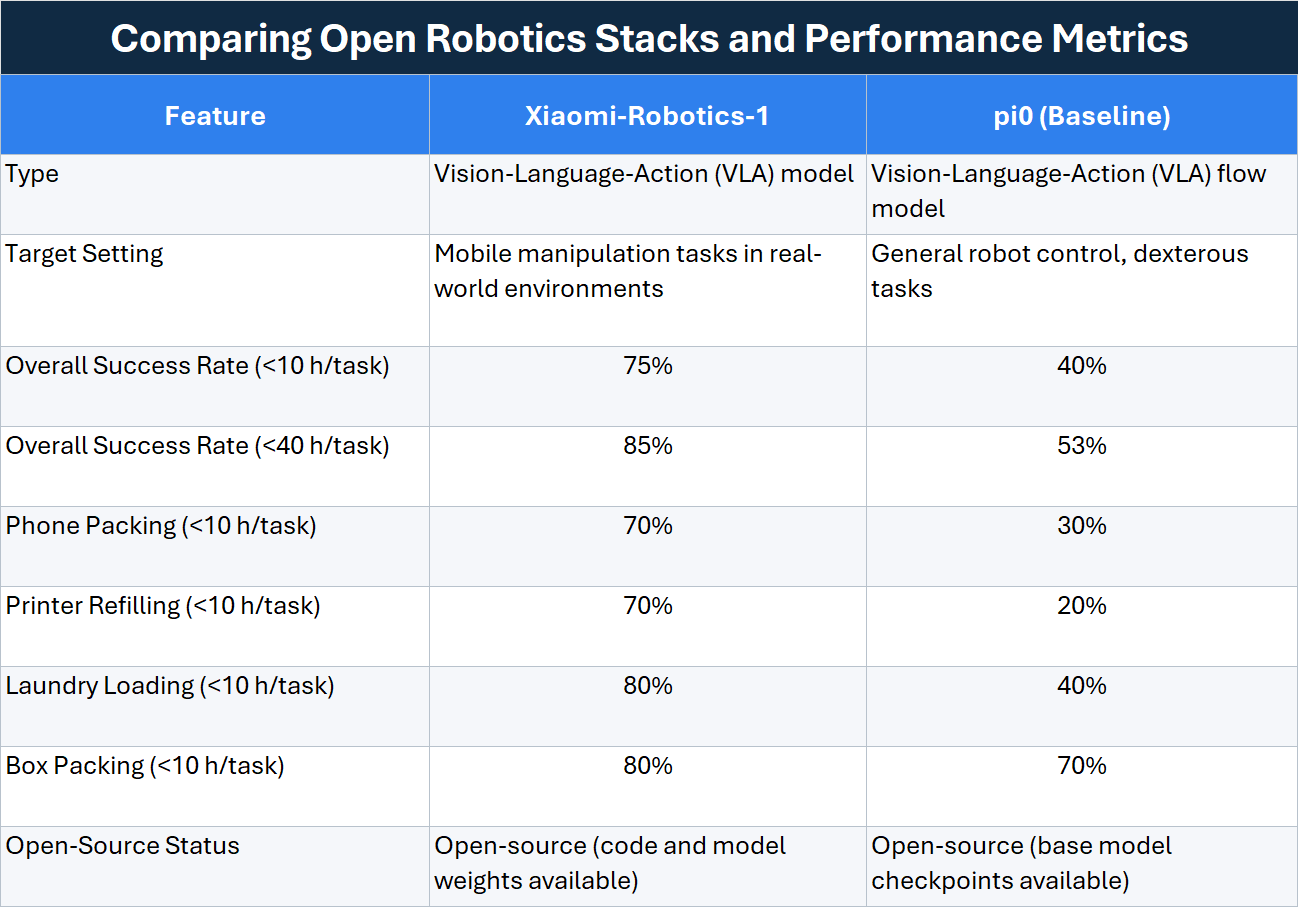
注:データは、実ロボットのデモンストレーションを最小限に抑えた状態での新規タスクへの効率的な適応に基づいています。Xiaomi-Robotics-1の公式レポートでは、pi0が主要なベースラインとして使用されています。
この比較により、データ効率において飛躍的な向上が明らかになりました。タスク固有のデータが10時間未満で、全体的な成功率75%を達成したことは、極めて重要なマイルストーンです。これは、事前学習段階において、モデルに物理的な相互作用に関する堅牢な理解が十分に植え付けられ、少数のデモンストレーションから汎化が可能になったことを示唆しています。 これは、洗濯物の投入のような複雑なタスクにおいて特に顕著であり、Xiaomi-Robotics-1は、ベースラインの40%に対し、80%の成功率を達成している。
自動化導入企業にとっての商業的・運用上の意義
コードやモデル重みが公開されたオープンソースモデルとしてのXiaomi-Robotics-1のリリースは、ロボット工学の研究者や開発者にとって大きな意味を持ちます。Xiaomiは、膨大なデータセットで学習されたすぐに使える基盤モデルを提供することで、高度なロボットシステム開発への参入障壁を下げています。これにより、さまざまな業界における新しいアプリケーションの開発や導入が加速する可能性があります。
「Xiaomi-Robotics-1は、大規模なエンボディメントフリーの事前学習によってロボットのデータボトルネックを打破し、予測可能なスケーリングを実現することで、実ロボットにおける『箱から出してすぐ』の性能向上につながることを実証しています。」
調達チームや
自動化システムの購入者にとって、「Xiaomi-Robotics-1」のようなオープンソースの基盤モデルの登場は、新たな検討事項をもたらします。これらのモデルは強力な機能を提供する一方で、実装や特定のユースケースへの適応には高度な技術的専門知識が必要となります。このモデルは2段階のトレーニングプロセスを必要とし、複雑なアーキテクチャに依存しています。 導入を検討する企業は、これらの高度なモデルがもたらす潜在的なメリットと、統合に伴う課題や専門的なエンジニアリング人材の必要性を慎重に比較検討する必要があります。さらに、このリリースのオープンソースという性質は、ロボット市場の競争構造に変化をもたらしています。ライセンス料なしでカスタマイズおよび導入が可能な、高性能な代替案を提供することで、プロプライエタリなモデルに挑んでいます。 ただし、総所有コスト(TCO)を算出する際には、トレーニング後および推論に必要なコンピューティングリソースに加え、特定のハードウェアプラットフォームにモデルを統合するために必要なエンジニアリング工数も考慮に入れる必要があります。
ロボット産業は、狭義のタスク特化型プログラミングというパラダイムから、汎用的なデータ駆動型学習というパラダイムへと移行しつつある。「Xiaomi-Robotics-1」は、この変化を明確に示すものであり、大規模なデータ収集と事前学習の威力を実証している。 こうしたモデルが改良され、より利用しやすくなるにつれ、ロボットの開発、導入、そして日常生活への統合のあり方は根本的に変化していくでしょう。システムの知能が主要な差別化要因となるにつれ、焦点はハードウェア設計からデータ取得やモデルトレーニングへとますます移行していくでしょう。
本分析は、企業の発表および公開されている市場情報や政策情報を総合したものです。
免責事項:本記事は情報提供のみを目的としており、投資、財務、法律、調達、その他の専門的な助言を構成するものではありません。読者は、仕様、価格、入手可能性、規制
決定を下す前に、要件や取引条件について、関係する企業や当局と直接確認してください。










