日本将为工厂机器发放全国身份证
日本将对工厂设备进行编号,以便实体人工智能能够跨品牌对机器人和机床进行训练。目前缺失的关键环节是共享的车间数据,而不是又一场类人机器人演示。
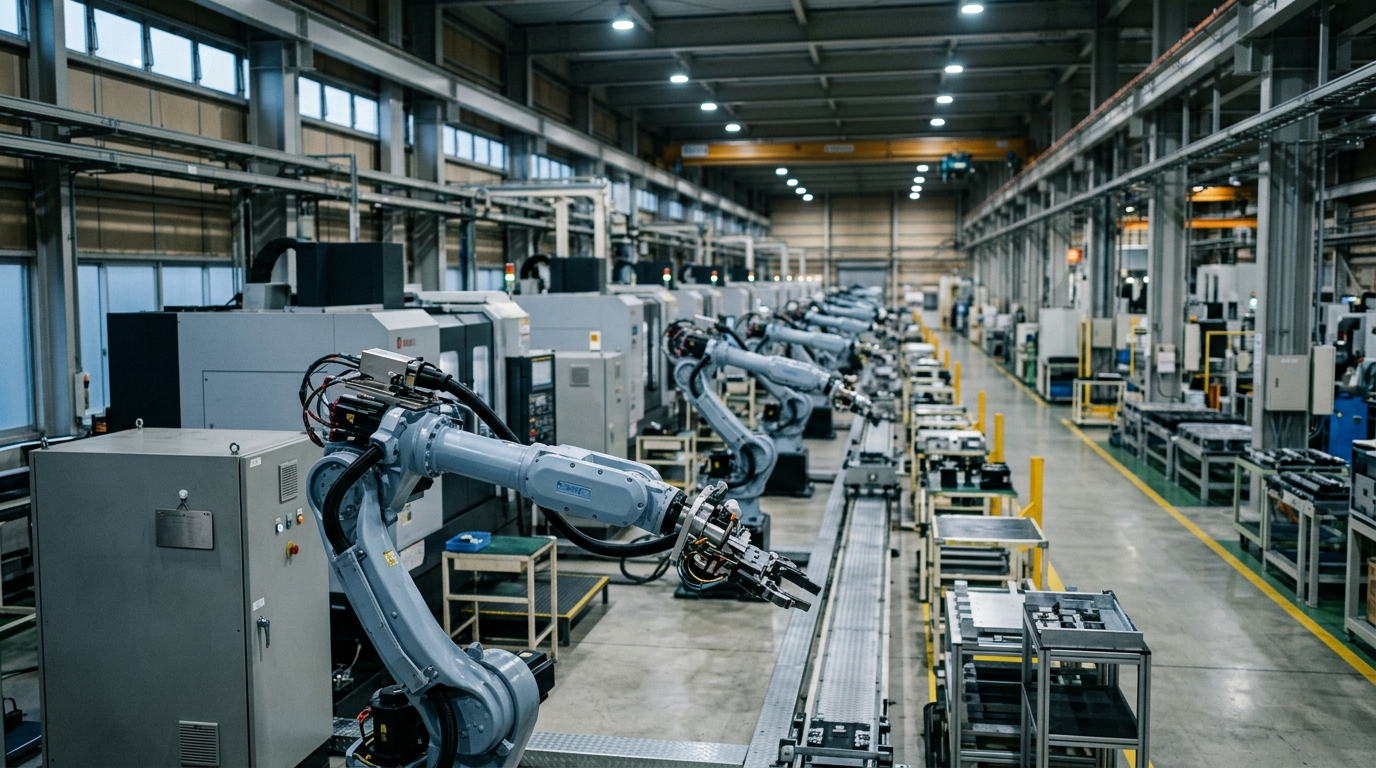
日本并不缺乏工业机器人,但缺乏让它们相互学习的方法。政府和领先的机械制造商将为每台工厂设备分配唯一的标识符,以便机器学习系统能够利用目前仅局限于各供应商内部的制造数据进行训练。 这项于2026年9月21日公布的计划,将铣削中心、冲压机或机械臂视为国家对待居民的方式:即作为具有名称的对象,其历史数据可以被收集、比较和重复利用。 这比又一款类人原型机更具深远意义,因为实体人工智能(AI)的失败并非首先源于电机故障,而是源于那些未标注、未共享且无法复现的车间数据。
采购团队早已熟悉这些硬件。发那科(FANUC Corporation)、安川电机(Yaskawa Electric Corporation)、川崎重工(Kawasaki Heavy Industries)、DMG Mori和小松(Komatsu)等企业,数十年来一直向实行三班倒的工厂提供设备。但他们尚未建立起一套关于这些机器昨日工作情况的通用语言。 一家供应商的焊接单元无法轻易将其工艺轨迹共享给另一家供应商的搬运单元。位于九州的一家工厂也无法以低成本复用在爱知县发现的工艺窗口。新的身份识别层旨在将日本现有的设备基数转变为训练集,而非一个充满互不兼容日志的“博物馆”。
隐藏在机器人超级大国背后的数据问题
日本仍占据全球工业机器人市场的大部分份额。这一事实已成为一种令人安心的叙事,但这是一种错误的叙事。该国可以出口机械臂、控制器和伺服套件,但无法默认汇总这些产品在安装到客户生产线后所产生的杂乱无章的运行记录。 物理人工智能——即必须在工厂、仓库及其他物理场所进行规划和行动的模型类别——需要海量的这些运行轨迹。孤立的原始设备制造商(OEM)数据湖无法提供海量数据,它们提供的只是零散片段。
周一的计划针对的是这一问题
问题出在资产本身,而非算法上。将向各生产商旗下的单台设备分配唯一的ID。在日本的框架下,该ID类似于“我的号码”(My Number),即用于居民的国家识别码。 这种类比既涉及技术层面,也涉及政治层面。它向工厂经理们传递了一个信号:国家希望对机器建立持久的管控,正如其早已希望对个人和企业建立持久的管控一样。它同时也向机器人供应商表明,下一阶段的竞争焦点不仅在于更快的控制器,更在于其已安装的设备能否输出可供国家级训练系统吸收的数据。这与西方类人机器人企业宣传的瓶颈截然不同。Figure AI、特斯拉及其同行们谈论的是家庭试用、仓库工时和基础模型。这些叙事都假设机器人本身就是数据工厂。而日本的故事则假设工厂本身已经就是数据工厂,机器人只是众多应贡献数据的机器类别之一。 一台记录主轴负载的数控(CNC)铣床、一台记录吨位曲线的压力机,以及一台记录关节扭矩的机器人,它们协同工作比单独运作更有价值。跨厂商数据采集才是关键,单一品牌的云平台则并非如此。
该计划背后的2040年工业目标并非新提法,也不应与周一的新闻混为一谈。 日本此前已表示,希望其人工智能机器人产业在全球市场中的份额超过30%,并达到20万亿日元的规模(按1美元兑154日元计算,约合1300亿美元)。这些数字只是政策设定的上限,并非身份识别方案行之有效的证据。 但这些数字确实解释了为何东京愿意将国家编号方案强加于私营工厂。如果该国无法将其机床和机器人存量转化为培训的动力,那么2040年的市场份额目标就只是个口号。
为何仅靠序列号还不够
每一家正规工厂都已对资产进行了标记。维护软件中也包含序列号。可编程
可编程逻辑控制器(PLC)网络拥有节点地址。机器人控制器则拥有软件许可证。 这些都不是能够贯穿整机生命周期——从原始设备制造商的生产车间到客户的生产单元,乃至后续翻新——的、跨越不同制造商的全国性标识。序列号是局部的。当生产线被出售、控制器被更换,或者系统集成商复制程序却未复制元数据时,这些标识就会失效。统一标识旨在使机器成为“一级数据主体”。如果两台发那科(FANUC)机械臂、一台安川(Yaskawa)机械臂和一台DMG Mori铣床都能通过共享的标识方案生成追踪记录,那么无论机柜由哪家厂商制造,模型都能识别出:特定的振动特征预示着换刀操作即将发生。这正是运营层面的核心价值。 这也正是治理风险所在。工厂会问:谁来存储这些记录?谁可以查询?竞争对手能否据此推断出工艺配方?当设备被出口时又会发生什么?这些疑问在公开报道的导语中并未得到解答。它们将决定该方案是成为训练数据集,还是变成合规方面的难题。
参与该项目的工业巨头名单显示了该计划的覆盖范围之广。 DMG Mori和小松(Komatsu)处于机械制造核心领域。发那科(FANUC)和安川电机(Yaskawa)则处于机器人领域。本田、索尼、软银集团和NEC出现在相关产业阵营中,因为在日本,物理人工智能正被定位为国家级技术体系,而非某家机器人公司的产品线。 在日本方面关于该数据收集计划的说明中,约有100家企业与DMG Mori被归为一组。这一数字应理解为联盟规模,而非已签署100份数据共享合同。组建联盟容易,但跨供应商数据架构的构建却非易事。
采购方应区分供应商试图混淆的三个层面。 第一层是身份识别:机器上的持久性标识符。第二层是遥测数据:机器被允许传输哪些数据、以何种频率传输,以及对生产配方进行何种屏蔽处理。第三层是模型权益:基于该遥测数据训练出的模型归谁所有,以及如果工厂
这涉及机器人品牌的变更。日本推行第一项措施比第二项或第三项更容易。对于没有数据合同的机器来说,“我的号码”不过是一个更悦耳的名称而已。与中国和美国的比较并不在于谁拥有更多类人机器人。中国一直将类人机器人的培训集中在共享中心和大规模试点项目中。 美国则将数据集中于少数几家同时拥有硬件和车队的机器人及汽车公司手中。日本正在尝试第三条路径:保留分散的OEM市场,维持庞大的设备基数,并通过标识符将机器连接起来,从而确保即使品牌变更,数据仍能流动。 如果这条路行得通,一家中型汽车供应商无需制造类人机器人,也能提供有用的数据轨迹。如果失败,日本虽然给机器都编了号,但模型训练仍将依赖模拟数据。
在设备标识码到位前,工厂采购方应提出哪些要求
真正的实践检验不在于某个部委能否打印编号,而在于生产工程师能否在不违反客户保密条款的情况下,使用其他工厂的匿名化工艺窗口。这一检验只需通过一份简短的核对清单即可。
首先,要问ID实际上指代的是哪个对象。机械臂、控制器、生产单元和工具是四种不同的事物。如果ID仅绑定在控制器上,那么经过翻新的机械臂将继承它本不该拥有的历史记录;如果ID仅绑定在机械单元上,那么软件升级就会被视为一台新机器。 采购条款应要求ID涵盖实际产生可追溯信息的组合:机械单元加控制器加主要末端执行器,并附有记录在案的变更日志。
其次,应要求制定一套跨供应商通用的最低遥测数据集。关节扭矩、循环时间、故障代码、能耗以及粗略的工艺类别(焊接、拾取、铣削、冲压)比仅有一个原始设备制造商(OEM)能解析的专有200字段数据导出更有价值。 物理AI团队往往要耗费数月时间来映射各供应商的模式。一个仍然
“每个品牌都需要一个定制解析器”这种说法纯属哗众取宠。第三,必须坚持设置工厂级别的关闭开关。某些数据痕迹属于竞争性资产。电池生产线的涂层配方并非公共产品。该方案能否存续,取决于客户能否在不被视为“非参与者”的情况下,贡献降级或延迟的数据,或者仅贡献故障模式。若采用非此即彼的规则,将导致最优秀的工厂退出。
第四,将模型溯源视为商业条款。如果用于机器人的基础模型是在联盟语料库上训练的,买家需要知道该模型是否已获得许可、是否可以在本地运行,以及日后从安川(Yaskawa)切换到发那科(FANUC)是否需要新的许可。 无法随生产设备迁移的数据,实质上是披着国家政策外衣的锁定机制。
第五,不要将这一身份计划与上周的产品新闻混为一谈。发那科(FANUC)已经展示了一款能够读取图纸并编写电弧焊接程序的AI焊接代理,计划于2026年12月底开始向客户交付。安川(Yaskawa)则一直在为装配单元增加更多自主性。 这些产品可以从国家级数据集受益,但并不能取代它。一个仅从发那科工厂学习焊接程序的焊接代理将面临发展瓶颈。国家级ID正是日本试图在不强行推举单一机器人领军企业的情况下,避免这种发展瓶颈的途径。
残酷的现实是,日本此前曾零星尝试过工业数据共享平台,但大多数项目都因原厂云服务条款与客户法务团队之间的博弈而夭折。为机器编号并不能抹去这段历史。但这确实提高了“袖手旁观”的成本——因为拒绝采用ID的工厂可能会发现自己被排除在未来机器人软件所预期的训练数据分发范围之外。 那些基于编号、跨厂商追踪数据进行训练的软件,在缺乏数据追踪、未命名的工作单元中表现会更差。这就是数据标准如何成为事实上的采购要求。
对于采购日本机器人的东盟工厂而言,即使该ID计划最初仅在国内推行,其影响也是立竿见影的。系统集成商将
开始质疑:柔佛或巴淡岛的一条生产线能否像北九州的那条生产线一样,按照相同的模式生成数据痕迹。那些指定采购日本设备却未明确数据权利的买家将会发现,真正的价值所在已从齿轮箱转移到了标识符上。机器人依然重要,但铭牌如今更为关键。一家无法为其机器命名的企业,就无法指导后续机器。日本已经认定,实体人工智能中缺失的那一块拼图,并非机器人行走的又一次演示,而是对那些已经投入运行的机器的登记册——以模型可读的形式记录下来。
本分析综合了企业声明和公开市场动态。
本文仅供参考,不构成投资、法律或采购建议。