日本、工場の機械に国民IDを付与へ
日本では、工場内の機械に番号を割り当てることで、物理的なAIがロボットや工作機械のブランドをまたいで学習できるようにする。欠けているのは、共有された現場データであり、新たなヒューマノイドのデモではない。
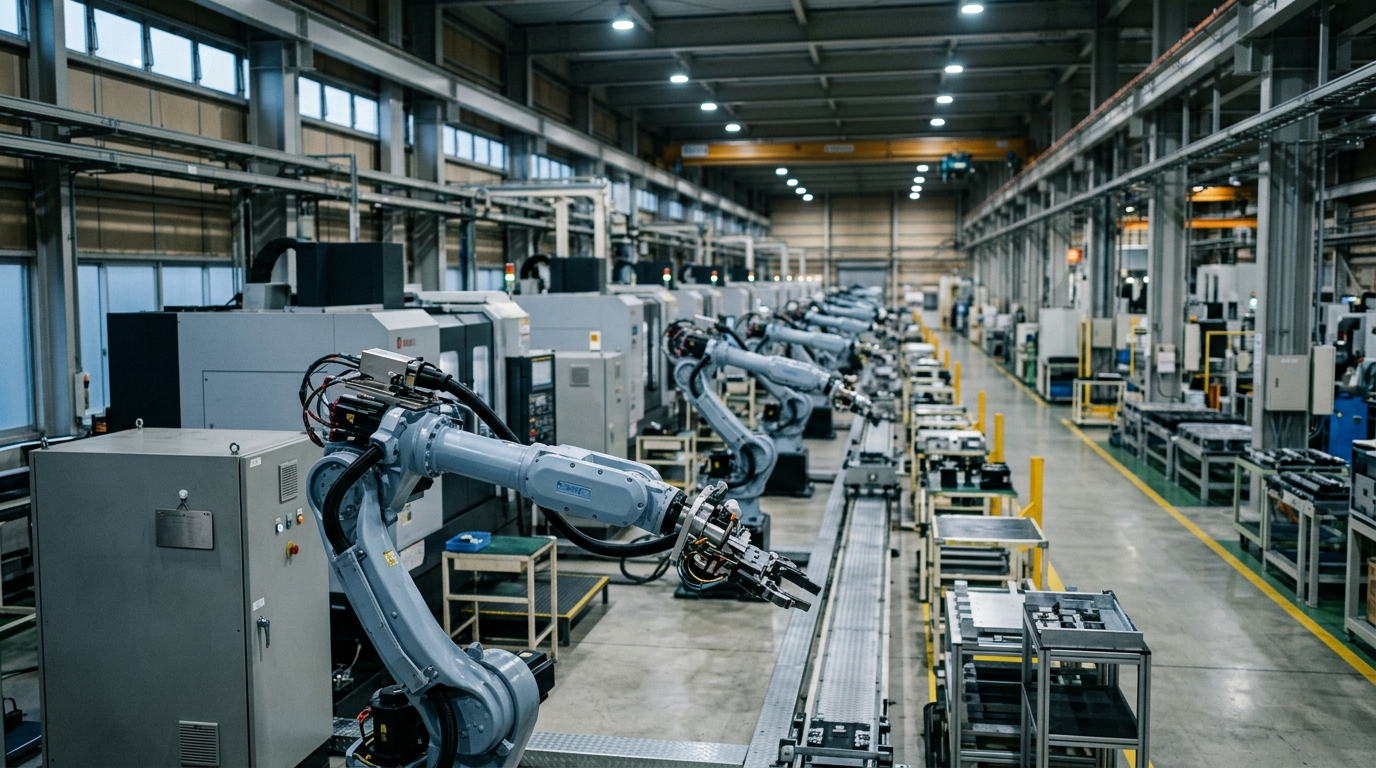
日本には産業用ロボットが不足しているわけではない。不足しているのは、ロボット同士が互いに学び合う仕組みだ。政府と主要な機械メーカーは、個々の工場設備に固有の識別子を割り当てることで、現在各ベンダーの社内で閉じ込められている製造データを用いて、機械学習システムが学習できるようにする。 2026年9月21日に公表されたこの計画では、フライス盤、プレス機、ロボットアームなどを、国がすでに住民を扱っているのと同じように、つまり、その履歴を収集・比較・再利用可能な「名前付きのオブジェクト」として扱う。 これは、また別のヒューマノイドのプロトタイプを開発するよりも、はるかに重要な賭けである。なぜなら、物理的な人工知能(AI)の失敗は、まずモーターの故障によるものではないからだ。その失敗は、ラベル付けされておらず、共有されておらず、再現不可能な現場のデータに起因する。
調達チームはすでにハードウェアについて熟知している。ファナック、安川電機、川崎重工業、DMGモリ、コマツは、数十年にわたり、3交代制で稼働する工場に機械を導入してきた。しかし、彼らが構築できていないのは、それらの機械が昨日何を行ったかについて共通の言語である。 あるベンダーの溶接セルが、そのプロセスの履歴を別のベンダーのハンドリングセルに容易に提供することはできない。九州にある工場が、愛知で見出されたプロセスウィンドウを安価に再利用することもできない。この新しい「アイデンティティ層」は、日本国内に導入済みの設備群を、互換性のないログの博物館ではなく、トレーニングセットへと変える試みである。
ロボット超大国に潜むデータ問題
日本は依然として世界の産業用ロボットの大きなシェアを占めている。この事実は「安心材料」となっているが、それは誤った認識だ。日本はアーム、コントローラ、サーボパッケージを出荷することはできる。しかし、それらの製品が顧客の生産ラインに設置された後に生成される雑多なトレースを、デフォルトで集約することはできない。 工場や倉庫、その他の物理的な現場で計画を立て、行動しなければならないモデル群である「フィジカルAI」には、大量のトレースデータが必要だ。個々のOEM(相手先ブランド製造業者)が保有するデータレイクでは、十分な量を提供できない。そこにあるのは断片に過ぎない。
月曜日の計画は、その問題に立ち向かうものである。
この問題はアルゴリズムではなく、資産そのものに起因するものです。各メーカーを問わず、個々の機器には一意のIDが割り当てられます。日本の制度に例えるなら、このIDは住民に付与される国民識別番号である「マイナンバー」に相当します。 この類比は、技術的な側面だけでなく政治的な側面も持つ。これは、工場管理者に対して、国がすでに人や企業に対して求めているのと同様に、機械に対しても永続的な管理権限を求めようとしていることを示唆している。また、ロボットベンダーに対しては、次の競争の層が単に高速なコントローラーだけではないことを示唆している。それは、彼らの導入済み機器群が、国家レベルのトレーニング・スタックが取り込めるデータを発信できるかどうかにかかっているのだ。これは、欧米のヒューマノイドロボット企業が宣伝するボトルネックとは異なるものだ。Figure AIやテスラ、および同業他社は、家庭での試験運用や倉庫での稼働時間、基盤モデルについて語っている。それらの話では、ロボットこそが「データ工場」であると想定されている。一方、日本のストーリーでは、工場自体がすでに「データ工場」であり、ロボットはそこに貢献すべき多くの機械のうちの一種に過ぎないと想定されている。 スピンドルの負荷を記録するCNCフライス盤、トン数曲線を記録するプレス機、関節トルクを記録するロボットは、どれか一つが単独で機能するよりも、組み合わせて使用した方がはるかに有用だ。メーカーを跨いだデータ収集こそが重要であり、単一ブランドのクラウドではない。
この計画の背景にある2040年の産業目標は新しいものではなく、月曜日のニュースと混同してはならない。 日本はすでに、AIロボット産業の世界市場シェアを30%以上にし、市場規模を20兆円(1ドル=約154円で計算すると約1,300億米ドル)に拡大したいと表明している。これらの数値は政策上の上限であり、識別スキームが機能する証拠ではない。 しかし、これらの数字は、なぜ東京が民間メーカーの機械に国家的な番号付けの構想を押し付けようとしているのかを説明している。もし日本が自国の工作機械やロボットの在庫を人材育成の糧に変えられなければ、2040年のシェア目標は単なるスローガンに過ぎない。
なぜシリアル番号だけでは不十分なのか
真面目に経営している工場なら、すでに資産にタグを付けている。メンテナンス用ソフトウェアにもシリアル番号がある。プログラム可能な
ロジックコントローラ(PLC)のネットワークにはノードアドレスがあります。ロボットコントローラにはソフトウェアライセンスがあります。 これらはいずれも、OEMの生産現場から顧客のセル、さらにはその後の再構築に至るまで、機械を追跡できる、メーカーを横断する全国的な識別子ではありません。シリアル番号は局所的なものです。生産ラインが売却されたり、コントローラが交換されたり、システムインテグレータがメタデータをコピーせずにプログラムを複製したりすると、そのシリアル番号は機能しなくなります。共通IDは、機械を「第一級のデータ市民」にしようとする試みである。もし2台のファナック製ロボットアーム、1台の安川電機製ロボットアーム、そして1台のDMGモリ製フライス盤が、共有された識別子スキームに基づいてトレースデータを送信できるなら、キャビネットの塗装業者が誰であろうと、特定の振動パターンが工具交換に先行することをモデルが学習できるようになる。これこそが運用上の最大のメリットである。 同時に、それはガバナンス上のリスクでもあります。工場側からは、トレースデータを誰が保管するのか、誰が照会できるのか、競合他社がプロセスのレシピを推測できないか、機械が輸出された場合はどうなるのかといった質問が寄せられるでしょう。こうした疑問は、公開された概要文では回答されていません。これらの点次第で、このスキームがトレーニング用コーパスとなるか、それともコンプライアンス上の頭痛の種となるかが決まるのです。
この取り組みに名を連ねる産業の顔ぶれは、その網がどれほど広範囲に及ぶことを想定しているかを示している。 DMGモリとコマツは機械製造の中核を担っている。ファナックと安川電機はロボット分野に位置する。ホンダ、ソニー、ソフトバンクグループ、NECが関連産業グループに名を連ねているのは、日本におけるフィジカルAIが、ロボット企業の製品ラインではなく、国家レベルの基盤として位置づけられているためである。 この取り組みに関する日本の報告書では、約100社がDMGモリとグループ化されている。この数字は、100件のデータ共有契約が締結された数としてではなく、連合の規模として捉えるべきである。連合としての広報活動は容易だが、ベンダー間のスキーマの整合は容易ではない。
購入者は、ベンダーが曖昧にしようとする3つの層を明確に区別すべきである。 第一は「識別子」:機械に付与される永続的なIDである。第二は「テレメトリ」:機械がどのような情報を、どの頻度で、レシピをどの程度マスキングして送信することが許可されているか。第三は「モデルの権利」:そのテレメトリを用いて学習されたポリシーを誰が所有するか、また、工場が移転する際にそのモデルを持ち出すことができるかどうかである。
ロボットのブランドが変わる。日本にとっては、2番目や3番目よりも、1番目を義務付けるほうが容易だ。データ契約のない機械向けの「マイナンバー」は、単に聞こえの良い名称に過ぎない。中国や米国との比較は、どちらがより多くのヒューマノイドを保有しているかという点ではない。中国は、共有センターや大規模なパイロット事業において、ヒューマノイドの訓練を集中的に行ってきた。 米国は、本体と車両の両方を所有する少数のロボット・自動車企業内にデータを集中させてきた。日本は第三の道を模索している。すなわち、細分化されたOEM市場を維持し、密集した導入基盤を維持しつつ、識別子を用いて機械を結びつけ、ブランドが異なってもデータが移動できるようにするのだ。 この道が成功すれば、中堅の自動車部品サプライヤーでも、ヒューマノイドを製造することなく有用なデータを提供できるようになる。もし失敗したとしても、日本は機械に番号を割り当て、シミュレーション上でモデルを学習させてきたことになる。
IDの導入前に、プラントの購買担当者が求めるべきこと
実用的な検証は、省庁が番号を割り当てられるかどうかではありません。生産技術者が、顧客の機密保持条項に違反することなく、他工場の匿名化されたプロセスウィンドウを利用できるかどうかです。その検証には、簡潔なチェックリストがあります。
まず、IDが実際にどの対象を指しているかを尋ねる。ロボットアーム、コントローラ、セル、そして工具は、それぞれ異なるものだ。IDがコントローラにのみ割り当てられている場合、再構築されたアームは、本来持つべきではない履歴を継承することになる。IDが機械ユニットにのみ割り当てられている場合、ソフトウェアのアップグレードがあたかも新しい機械であるかのように見えてしまう。 調達契約の文言では、IDが実際にトレースを生成する組み合わせ――機械ユニット+コントローラ+主要なエンドエフェクタ――を網羅し、変更履歴が記録されていることを要件とすべきである。
次に、ベンダーを問わず有用な最低限のテレメトリセットを求めるべきです。関節トルク、サイクルタイム、故障コード、消費電力、および大まかなプロセス分類(溶接、ピッキング、フライス加工、プレス)は、特定のOEMのみが解析できる独自の200項目のフィールドダンプよりも価値があります。 物理AIチームは、ベンダー固有のスキーマのマッピングに数ヶ月を浪費しています。依然として
ブランドごとにカスタムパーサーが必要というのは茶番だ。第三に、工場レベルでのオフスイッチを徹底すること。一部のトレースは競争上の資産である。バッテリー生産ラインのコーティングレシピは公共財ではない。この仕組みが成立するのは、顧客が、品質の低下したデータや遅延したデータ、あるいは故障モードのみを提供しても、非参加者として扱われない場合に限られる。単純な「参加か不参加か」というルールでは、優れた工場が離脱してしまうだろう。
第四に、モデルの出所を商業上の条件として扱うこと。ロボット用の基盤モデルが連合コーパスで学習されている場合、購入者は、そのモデルがライセンスされているか、オンプレミスで実行可能か、そして後で安川電機からファナックに切り替える際に新しいライセンスが必要になるかどうかを知る必要がある。 プラントに追随できないデータは、国家政策の看板を掲げたロックイン装置に他なりません。
第五に、このアイデンティティ計画を先週の製品ニュースと混同してはならない。ファナックはすでに、図面を読み取りアーク溶接プログラムを作成するAI溶接エージェントを公開しており、顧客への出荷は2026年12月末を目標としている。安川電機は組立セルにさらなる自律性を組み込んでいる。 これらの製品は、全国規模のデータコーパスから恩恵を受けることができますが、それに取って代わるものではありません。ファナックの拠点からのみ学習する溶接エージェントは、成長が頭打ちになります。全国IDは、単一のロボット「チャンピオン」を強制することなく、日本がその頭打ちを食い止めようとする試みです。
厳しい現実として、日本はこれまでにも断片的な取り組みやパイロット事業として産業用データコモンズを試みてきましたが、そのほとんどは、OEMのクラウド利用規約と顧客の法務部門との狭間で頓挫してしまいました。機械にIDを付与したからといって、その歴史が覆されるわけではありません。しかし、IDの付与を拒否した工場は、将来のロボットソフトウェアが想定するトレーニングデータの流通から取り残される可能性があるため、参加しないことのコストは高まるでしょう。 番号が割り当てられ、ベンダーを横断したトレースデータで学習されたソフトウェアは、情報源が不明で名前も付かないセルでは、期待通りの性能を発揮できなくなる。こうして、データ標準は事実上の購入要件となるのである。
日本のロボットを購入するASEANの工場にとって、たとえIDスキームが当初は国内限定であったとしても、その影響は即座に現れる。インテグレーターは
ジョホールやバタムの生産ラインが、北九州の生産ラインと同じスキーマでトレースを出力できるかどうかを問い始めよう。データ権利を明記せずに日本のロボットを指定するバイヤーは、価値のある要素がギアボックスから識別子へと移ったことに気づくだろう。ロボット自体は依然として重要だ。しかし、今や銘板の方がより重要になっている。自社の機械に名前を付けられない工場は、次の世代の機械を教育することはできない。日本は、物理的なAIにおいて欠けている要素は、ロボットが歩くという単なるデモンストレーションではないと結論付けた。それは、すでに稼働している機械の登録簿であり、モデルが読み取れる形式で記述されたものである。
本分析は、企業の声明および公開市場での動向を総合したものです。
本記事は情報提供のみを目的としており、投資、法律、または調達に関する助言を構成するものではありません。