
AGIBOT 开源了一套数据集,旨在教会机器人“为什么”,而不仅仅是“怎么做”
AGIBOT 已将“物理推理”(Physical Reasoning)开源,这是其 AGIBOT WORLD 2026 数据计划的第四个版本,旨在教会具身人工智能模型判断不断变化的状况并识别故障状态,而非仅仅重复预设的操作轨迹。

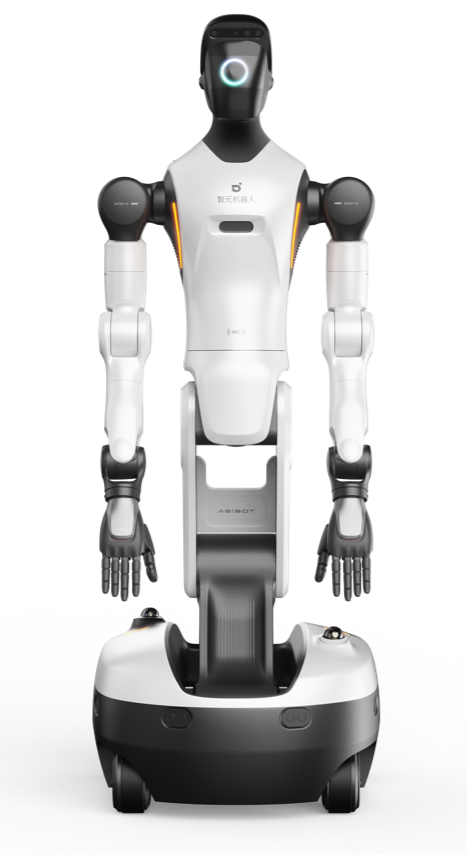
总部位于上海的人形机器人及具身人工智能制造商AGIBOT(正式注册名为AGIBOT Innovation (上海)科技有限公司,于2026年10月23日开源了一套新的训练数据集。该数据集旨在教会机器人在不断变化的条件下选择何种动作,而非仅仅执行预设的动作脚本。 该数据集名为“物理推理”(Physical Reasoning),是该公司“AGIBOT WORLD 2026”数据计划的第四期成果,目前可通过Hugging Face和AGIBOT WORLD项目网站下载。
对于正在评估具身人工智能供应商的采购团队而言,此次发布意义重大,因为它针对了一个具体的、具有商业相关性的弱点:在演示中能够可靠地执行抓取动作的机械臂或类人机器人,往往无法区分装满的抽屉和空抽屉,也无法识别任务是否已部分完成。 “物理推理”数据集正是针对这些判断决策进行标注,而不仅仅是标注随之而来的动作。
“观察动作”与“选择动作”之间的鸿沟
大多数机器人操作数据集仅记录单个任务的单一正确轨迹:拿起杯子,将其放在架子上。这种方法教的是模仿,而一旦环境发生训练数据中从未出现过的变化,这种模仿就会失效。本应是空的抽屉却装满了东西。 本应放三件物品的架子上只放了一件。从某个角度看似乎已经完成的任务,从另一个角度看却还缺一个步骤。
AGIBOT 正是针对这种失败模式直接设计了“物理推理”(Physical Reasoning)。该数据集并非通过提高操作难度来训练,而是保持任务目标不变,同时改变其周围的状态和约束条件,从而捕捉到即使基础技能未变,正确决策也会随之变化的现象。 每个样本都将一条高级指令与“密集提示”(即对动作的详细自然语言描述)配对,同时包含低级动作轨迹、包含边界框、点和轨迹线的空间标注,以及明确的子任务划分。
该架构的设计初衷是让开发者能够利用同一段标注好的事件,同时训练高级决策模型和低级动作策略,并运行AGIBOT内部所称的“决策-执行协同训练”,而非将感知、规划和控制视为三个各自独立的问题。这种区分听起来似乎只是学术上的,直到将其应用到实际作业现场。仓库拣货任务和酒店客房整理任务虽然可以共享几乎相同的操作技能——抓取、搬运、放置——但在“先做什么”、“跳过什么”以及“什么才算完成”等方面,却需要完全不同的判断。 目前市面上大多数商用机器人策略在通用技能方面表现强劲,但在判断层面上却较为薄弱,因为用于训练判断能力的数据,其采集难度更高、成本也比用于训练单一清晰轨迹的数据要大。
隐藏在日常琐事中的九项推理测试
该数据集围绕九项不同的推理技能进行组织。有些测试机器人能否根据物体的属性或周围环境挑选出正确的物体;有些则测试它能否判断某项操作在物理上是否可行,或者能否识别出某项动作所依赖的先决条件。 其余技能则进一步深入到规划领域:朝着目标进行搜索、跟踪随时间变化的数量和状态、按顺序保持一长串步骤、记住已经发生的事情,以及正确排序子任务。 这九项技能涵盖了十多种场景类型,并针对四种反复出现的现实世界复杂情况进行了压力测试:物体数量、物体是否部分被遮挡、已占用空间的大小,以及机器人遇到该任务时任务已进展到何种程度。
示例任务刻意设计得平淡无奇,这正是针对那些更关注部署就绪性而非演示视频的买家而言的关键所在。这些任务包括为酒店迷你吧补货、在多个抽屉中搜索特定的洗漱用品
取物、从障碍物后方取出钥匙、打扫客房、整理餐桌以及给零售货架补货。 每项任务均被评定为“简单”、“中等”或“困难”级别,其中“困难”任务结合了多个子目标、长时态状态追踪以及同时存在的多种约束条件——这正是单技能演示视频中从未需要做出的那种复合型判断决策。酒店业和轻型零售业是经过深思熟虑的试验场。这两个环境在结构上足够适合自动化,但在库存水平、房间布局、客人行为等方面又存在足够多的变数,导致仅基于纯干净操作数据训练的模型往往会“悄无声息地”失败:它会完成一个动作,却未察觉该动作解决的是错误的问题。 根据复合难度而非单纯的灵巧度来评估任务,使外部开发者能够精准地对这种失败模式进行基准测试,而不仅仅是评估抓取成功率。
AGIBOT 尚未披露数据集的规模、场景数量、视频时长、所用机器人平台或场景数量,这是一个值得指出而非轻描淡写的缺失。此前 AGIBOT WORLD 的发布往往将规模作为卖点;而此次则侧重于任务设计和标注深度。 购买方或研究合作伙伴在将“物理推理”与竞争对手的具身AI数据集进行对比时,应直接索取缺失的规模数据,而非假设推理多样性可以替代数据量——因为这两个因素都关系到训练后的策略在所展示场景之外的泛化能力。
教模型“不要做什么”
在“物理推理”中,更具结构意义的选择在于AGIBOT如何处理失败。 每个标注的事件都包含“成功片段”和“对抗性片段”,这意味着该数据集不仅记录了正确的决策序列,还记录了导致错误结果的决策——无论是选错了物品,还是放置的数量有误。AGIBOT对成功和错误的
在标注过程中平等地对待所有样本,而不是将失败案例视为可忽略的噪声。这与纯粹为了展示机器人能力而构建的数据集相比,是一种截然不同的设计理念。 仅基于成功轨迹训练的模型无法提供“为何替代动作是错误的”这一信号,而这恰恰是采购或集成团队所需的信息——当机器人必须在仓库过道、酒店走廊或零售后勤区等场景中作业时,这些环境永远不会与训练视频完全一致。 经过正确标注的负例,能让模型对规则进行泛化,而非仅仅死记硬背一条路径;而这恰恰是大多数商业数据供应商最不愿收集的样本,因为失败的轨迹既无法产生值得展示的视频素材,也无法带来明显的收益。
将此类数据开源,而非将其作为内部差异化优势保留,本身就是一种商业信号。这向市场表明,AGIBOT认为其优势在于其他方面——无论是机器人硬件、部署合作关系,还是基于此版本及此前版本训练的下一代模型,而非那些原始的标注视频本身。
数据已应用的领域
AGIBOT表示,该数据集已用于内部支持其下一代基础模型和即将推出的智能体框架,但未披露这两者的发布日期或基准测试结果。 这种先发布训练数据、再发布基于该数据训练出的模型的顺序,与AGIBOT今年在AGIBOT WORLD系列发布中一贯遵循的模式一致,这也使得外部开发者和学术实验室在获得相同数据后,能够独立验证或挑战该公司的推理主张。
其中蕴含的商业深意,是评估具身人工智能供应商的采购团队不应忽视的。演示视频仅展示了机器人在理想条件下的一次表现,而基于
分级难度、 明确的失败标注以及多约束长时域任务,这才是区分“仅适合单一受控试点”的系统与“能够应对实际设施中各种变数”的系统的关键依据——这也是演示系统与可部署系统之间的本质区别,而这一区别正是今年在类人机器人领域屡屡令供应商承诺落空的症结所在。因此,组织供应商比拼的采购方将获得一个具体的新问题:不仅要考察候选机器人在技能演示中的表现,还要看供应商能否展示其在分级、状态多变的任务中的推理表现——而“物理推理”(Physical Reasoning)现在已使此类任务的测试结果公开可复现。 如果某家供应商无法在其等效基准测试中产出可比数据,那么即使其操作视频看起来颇具竞争力,也等于在推理层面承认了失败。
对于实际采购而言,其启示远不止于“AGIBOT解决了机器人推理问题”。任何数据集的发布都无法证明基于该数据集训练的模型在实际运营场所中确实能弥合泛化差距;这仍需通过逐个试点项目来验证,且必须结合采购方自身场地的具体产品组合、楼层布局及人员配置模式。 “物理推理”真正改变的是可要求的举证责任。一旦针对酒店和零售类任务建立了分级且可公开复现的推理基准,负责评估任何具身人工智能供应商(包括AGIBOT)的采购团队,便可要求进行具体且可重复的测试,而非仅依赖供应商自行挑选的演示视频。
AGIBOT今年建立了业内最为积极的开放数据发布节奏之一,这一策略将公司自身的训练投入转化为整个行业衡量自身表现的事实上的基准,同时仍将其最先进的内部模型作为专有技术保留。 “物理推理”能否像此前发布的 AGIBOT WORLD 版本那样成为行业标杆,将取决于外部实验室
据此发布测试结果。第五个版本——即基于第4版构建的首批外部基准测试成绩——将是下一个值得关注的明确信号。本文基于该数据集发布方自身发布的材料及其公开的技术文档。本文仅供一般信息参考,不构成投资、采购、法律或工程方面的建议。










