
AGIBOT veröffentlicht einen Datensatz als Open Source, der Robotern nicht nur das „Wie“, sondern auch das „Warum“ vermittelt
AGIBOT hat „Physical Reasoning“ als Open-Source-Projekt veröffentlicht – die vierte Veröffentlichung im Rahmen seines Datenprogramms „AGIBOT WORLD 2026“, das darauf ausgelegt ist, verkörperte KI-Modelle dazu zu befähigen, sich ändernde Bedingungen einzuschätzen und Fehlerzustände zu erkennen, anstatt lediglich eine vorgegebene Manipulationsbahn zu wiederholen.

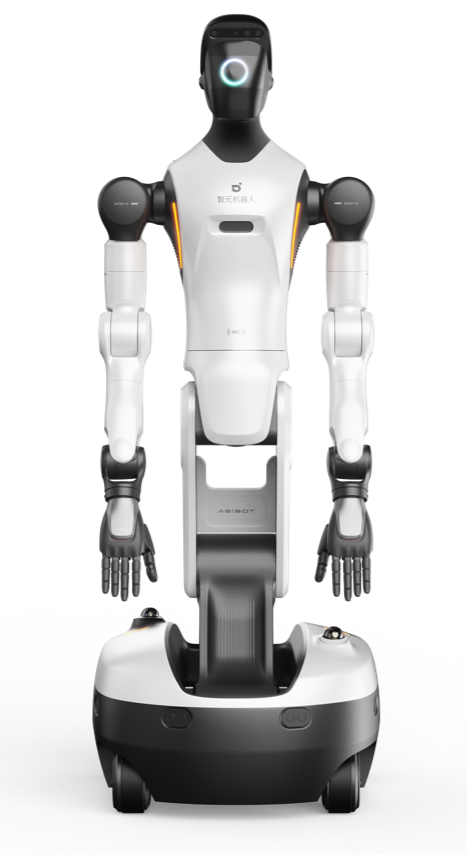
AGIBOT, der in Shanghai ansässige Hersteller von humanoiden Robotern und verkörperter KI, der offiziell als AGIBOT Innovation (Shanghai) Technology Co., Ltd., veröffentlicht am 23. Oktober 2026 einen neuen Trainingsdatensatz als Open Source. Dieser wurde entwickelt, um Robotern beizubringen, unter sich ändernden Bedingungen die richtige Aktion zu wählen, anstatt lediglich eine vorgegebene Bewegung auszuführen. Die Veröffentlichung mit dem Namen „Physical Reasoning“ ist der vierte Teil des Datenprogramms „AGIBOT WORLD 2026“ des Unternehmens und steht nun über Hugging Face sowie auf der Projektwebsite von AGIBOT WORLD zum Download bereit.
Für Beschaffungsteams, die Anbieter von verkörperter KI bewerten, ist diese Veröffentlichung von Bedeutung, da sie auf eine spezifische, kommerziell relevante Schwachstelle abzielt: Ein Roboterarm oder ein Humanoid, der in einer Demo zuverlässig einen Greifvorgang ausführen kann, ist oft nicht in der Lage, eine gefüllte Schublade von einer leeren zu unterscheiden oder zu erkennen, dass eine Aufgabe bereits teilweise erfolgreich abgeschlossen wurde. „Physical Reasoning“ dokumentiert genau diese Ermessensentscheidungen und nicht nur die darauf folgenden Bewegungen.
Die Kluft zwischen dem Sehen einer Handlung und der Wahl einer Handlung
Die meisten Datensätze zur Robotermanipulation erfassen eine einzige korrekte Bewegungsbahn für eine einzelne Aufgabe: die Tasse aufnehmen, sie auf das Regal stellen. Dieser Ansatz lehrt Nachahmung, und die Nachahmung versagt in dem Moment, in dem sich die Umgebung auf eine Weise verändert, die in den Trainingsdaten nie vorkam. Eine Schublade, die eigentlich leer sein sollte, ist voll. Ein Regal, das drei Gegenstände enthalten sollte, enthält nur einen. Eine Aufgabe, die aus einem Blickwinkel vollständig erscheint, lässt aus einem anderen Blickwinkel einen Schritt vermissen.
AGIBOT hat „Physical Reasoning“ direkt auf diesen Fehlermodus ausgerichtet. Anstatt den Schwierigkeitsgrad der Manipulation zu erhöhen, hält der Datensatz das Aufgabenziel konstant und variiert den Zustand sowie die damit verbundenen Einschränkungen, wodurch erfasst wird, wie sich die richtige Entscheidung ändert, selbst wenn sich die zugrunde liegende Fertigkeit nicht ändert. Jedes Beispiel kombiniert eine übergeordnete Anweisung und einen „Dense Prompt“ – eine detaillierte Beschreibung der Aktion in natürlicher Sprache – mit Aktionsverläufen auf niedriger Ebene, räumlichen Anmerkungen einschließlich Begrenzungsrahmen, Punkten und Bewegungslinien sowie einer expliziten Segmentierung in Teilaufgaben.
Diese Struktur ist so konzipiert, dass ein Entwickler aus derselben annotierten Episode sowohl ein hochrangiges Entscheidungsmodell als auch eine niedrigrangige Handlungsstrategie trainieren und das durchführen kann, was AGIBOT intern als „gemeinsames Training von Entscheidung und Ausführung“ bezeichnet, anstatt Wahrnehmung, Planung und Steuerung als drei voneinander getrennte Probleme zu behandeln.Diese Unterscheidung klingt akademisch, bis sie in die Praxis umgesetzt wird. Eine Kommissionieraufgabe im Lager und eine Turndown-Aufgabe im Hotel können nahezu identische Manipulationsfähigkeiten erfordern – Greifen, Tragen, Ablegen –, erfordern jedoch völlig unterschiedliche Erkundungsentscheidungen darüber, was zuerst zu tun ist, was übersprungen werden kann und was als erledigt gilt. Die meisten heute im Handel erhältlichen Roboter-Strategien sind stark in Bezug auf die gemeinsamen Fähigkeiten, schwach jedoch auf der Ebene der Entscheidungsfindung, da die Daten, die die Entscheidungsfindung trainieren würden, schwieriger und kostspieliger zu erheben sind als die Daten, die eine einzelne, saubere Bewegungsbahn vermitteln.
Neun Tests zur Schlussfolgerungsfähigkeit, versteckt in alltäglichen Aufgaben
Der Datensatz ist um neun unterschiedliche Denkfähigkeiten herum strukturiert. Einige prüfen, ob ein Roboter anhand der Eigenschaften eines Objekts oder seines Umfelds das richtige Objekt auswählen kann; andere testen, ob er beurteilen kann, ob eine Handhabung überhaupt physikalisch machbar ist, oder ob er die Voraussetzungen erkennt, von denen eine Aktion abhängt. Die übrigen Fähigkeiten gehen noch tiefer in die Planung hinein: das Streben nach einem Ziel, das Verfolgen von Menge und Zustand im Zeitverlauf, das Behalten einer langen Abfolge von Schritten in der richtigen Reihenfolge, das Erinnern an bereits Geschehenes und das korrekte Aneinanderreihen von Teilaufgaben. Diese neun Fähigkeiten umfassen mehr als zehn Szenariotypen, die anhand von vier wiederkehrenden Komplikationen aus der Praxis auf ihre Belastbarkeit geprüft werden: wie viele Objekte vorhanden sind, ob ein Objekt teilweise verdeckt ist, wie viel Platz bereits belegt ist und wie weit eine Aufgabe bereits fortgeschritten ist, wenn der Roboter darauf stößt.
Die Beispielaufgaben sind bewusst unspektakulär – was für einen Käufer, der die Einsatzreife und nicht etwa Demomaterial bewertet, genau der springende Punkt ist. Dazu gehören das Auffüllen einer Hotel-Minibar sowie das Durchsuchen mehrerer Schubladen nach einem bestimmten Toilettenartikel
Gegenstände, das Entnehmen eines Schlüssels hinter einem Hindernis, das Reinigen eines Gästezimmers, das Abräumen eines Tisches und das Auffüllen von Verkaufsregalen. Jede Aufgabe wird als „leicht“, „mittel“ oder „schwer“ eingestuft, wobei „schwere“ Aufgaben mehrere Teilziele, die Verfolgung von Zuständen über einen langen Zeitraum und mehrere Einschränkungen gleichzeitig kombinieren – genau die Art von komplexen Ermessensentscheidungen, die in einem Demonstrationsvideo mit nur einer einzigen Fertigkeit niemals getroffen werden müssen.Das Gastgewerbe und der Leicht-Einzelhandel wurden bewusst als Testumgebungen ausgewählt. Beide Umgebungen sind strukturiert genug, um automatisiert zu werden, aber gleichzeitig variabel genug – hinsichtlich Lagerbeständen, Raumaufteilungen und Gästeverhalten –, sodass ein Modell, das ausschließlich auf „sauberen“ Manipulationsdaten trainiert wurde, dazu neigt, stillschweigend zu versagen: Es führt eine Bewegung aus, ohne zu bemerken, dass diese Bewegung das falsche Problem gelöst hat. Die Bewertung von Aufgaben anhand des kombinierten Schwierigkeitsgrades statt anhand der reinen Geschicklichkeit bietet externen Entwicklern die Möglichkeit, genau diesen Fehlermodus zu messen, anstatt lediglich die Erfolgsraten beim Greifen zu bewerten.
AGIBOT hat den Umfang des Datensatzes, die Anzahl der Episoden, die Dauer des Filmmaterials, die verwendeten Roboterplattformen oder die Anzahl der Szenen nicht offengelegt – eine Lücke, die es zu hervorheben gilt, anstatt sie zu beschönigen. Frühere Veröffentlichungen von AGIBOT WORLD stützten sich auf den Umfang als Verkaufsargument; diese wird stattdessen auf die Aufgabengestaltung und die Tiefe der Annotation ausgerichtet. Ein Käufer oder Forschungspartner, der „Physical Reasoning“ mit einem konkurrierenden Datensatz für verkörperte KI vergleicht, sollte direkt nach den fehlenden Größenangaben fragen, anstatt anzunehmen, dass die Vielfalt der Schlussfolgerungen das Datenvolumen ersetzt, da beide Faktoren entscheidend dafür sind, inwieweit sich eine trainierte Strategie über die ihr vorgelegten Szenarien hinaus verallgemeinern lässt.
Einem Modell beibringen, was es nicht tun soll
Die strukturell bedeutendere Entscheidung bei „Physical Reasoning“ betrifft die Art und Weise, wie AGIBOT mit Fehlschlägen umgegangen ist. Jede annotierte Episode umfasst sowohl „Erfolgssegmente“ als auch „adversarische Segmente“, was bedeutet, dass der Datensatz nicht nur die korrekte Abfolge von Entscheidungen aufzeichnet, sondern auch jene, die zu einem falschen Ergebnis führen – sei es, dass der falsche Gegenstand ausgewählt oder die falsche Menge platziert wird. AGIBOT gewichtete erfolgreiche und fehlerhafte
die Stichproben im Annotationsprozess gleichberechtigt zu berücksichtigen, anstatt Fehler als verwerfbares Rauschen zu behandeln.Dies ist eine grundlegend andere Designphilosophie als bei einem Datensatz, der ausschließlich dazu dient, zu demonstrieren, wozu ein Roboter fähig ist. Ein Modell, das ausschließlich anhand erfolgreicher Bewegungsabläufe trainiert wurde, enthält keinen Hinweis darauf, warum eine alternative Aktion falsch war – und genau diese Information benötigt ein Beschaffungs- oder Integrationsteam, wenn ein Roboter in einem Lagergang, einem Hotelkorridor oder einem Hinterzimmer eines Einzelhandelsgeschäfts eingesetzt werden soll, die niemals genau wie das Trainingsmaterial aussehen werden. Negative Beispiele, die ordnungsgemäß annotiert sind, ermöglichen es einem Modell, eine Regel zu verallgemeinern, anstatt sich einen Pfad einzuprägen, und sie sind zudem die Beispiele, die die meisten kommerziellen Datenanbieter am wenigsten bereit sind zu sammeln, da eine fehlgeschlagene Bewegungsbahn weder demo-taugliches Bildmaterial noch offensichtliche Einnahmen liefert.
Die Veröffentlichung solcher Daten als Open Source, anstatt sie als internes Alleinstellungsmerkmal zu behalten, ist an sich schon ein kommerzielles Signal. Es signalisiert dem Markt, dass AGIBOT davon überzeugt ist, dass sein Vorteil woanders liegt – in der Roboterhardware, den Einsatzbedingungen oder dem Modell der nächsten Generation, das auf der Grundlage dieser und früherer Versionen trainiert wurde –, und nicht im rohen, annotierten Filmmaterial selbst.
Wo die Daten bereits zum Einsatz kommen
AGIBOT teilte mit, dass der Datensatz bereits intern zur Unterstützung seines Grundmodells der nächsten Generation und eines in Kürze erscheinenden Agenten-Frameworks genutzt wurde, ohne jedoch ein Veröffentlichungsdatum oder Benchmark-Ergebnisse für beides bekanntzugeben. Diese Vorgehensweise – die Veröffentlichung der Trainingsdaten vor dem darauf trainierten Modell – entspricht dem Muster, das AGIBOT bei seinen diesjährigen „AGIBOT WORLD“-Veröffentlichungen verfolgt hat, und bietet externen Entwicklern und akademischen Forschungslabors die Möglichkeit, die Behauptungen des Unternehmens hinsichtlich der Schlussfolgerungsfähigkeit unabhängig zu validieren oder zu hinterfragen, sobald sie Zugriff auf dieselben Daten haben.
Der kommerzielle Hintergrund ist ein Aspekt, den Beschaffungsteams bei der Bewertung von Anbietern für „embodied AI“ nicht übersehen sollten. Ein Democlip zeigt einmalig unter idealen Bedingungen, wozu ein Roboter fähig ist. Ein auf
gestaffelter Schwierigkeitsgrad, explizite Fehlerkennzeichnung sowie Aufgaben mit mehreren Einschränkungen und langem Zeithorizont – kommt der Art von Nachweis näher, die ein System, das für einen einzelnen kontrollierten Pilotversuch bereit ist, von einem System unterscheidet, dem man die Variabilität einer realen Anlage anvertrauen kann. Dies ist der Unterschied zwischen einer Demonstration und einem einsatzfähigen System, der in diesem Jahr die Behauptungen der Anbieter im gesamten Humanoid-Sektor immer wieder ins Wanken bringt.Käufer, die einen Anbietervergleich durchführen, erhalten dadurch eine konkrete neue Frage, die sie stellen können: nicht nur, wie sich ein in Frage kommender Roboter bei einer Fertigkeitsdemonstration schlägt, sondern ob der Anbieter eine Leistungsfähigkeit im Bereich des logischen Denkens bei abgestuften Aufgaben mit variierenden Zuständen nachweisen kann – wie sie „Physical Reasoning“ nun öffentlich reproduzierbar macht. Ein Anbieter, der keine vergleichbaren Zahlen anhand seines eigenen, gleichwertigen Benchmarks vorlegen kann, hat die Beurteilungsebene faktisch aufgegeben, selbst wenn sein Manipulationsmaterial wettbewerbsfähig erscheint.
Die praktische Erkenntnis für die Beschaffung ist enger gefasst als „AGIBOT hat das logische Denken von Robotern gelöst“. Keine Veröffentlichung eines Datensatzes beweist, dass ein darauf trainiertes Modell tatsächlich die Generalisierungslücke in einer realen Einrichtung schließt; dies muss weiterhin Pilotprojekt für Pilotprojekt nachgewiesen werden – unter Berücksichtigung der spezifischen Produktpalette, der Raumaufteilung und der Personalbesetzung am Standort des Einkäufers. Was „Physical Reasoning“ jedoch verändert, ist die Beweislast, die man einfordern kann. Sobald ein benoteter, öffentlich reproduzierbarer Benchmark für das logisches Denken bei Aufgaben im Gastgewerbe und im Einzelhandel existiert, verfügt ein Beschaffungsteam, das einen Anbieter von verkörperter KI – einschließlich AGIBOT – bewertet, über einen konkreten, wiederholbaren Test, den es anfordern kann, anstatt sich allein auf vom Anbieter ausgewählte Demomaterialien zu verlassen.
AGIBOT hat in diesem Jahr einen der branchenweit ehrgeizigsten Zeitpläne für die Veröffentlichung offener Daten etabliert – eine Strategie, die die eigenen Trainingsinvestitionen des Unternehmens in einen De-facto-Maßstab umwandelt, an dem der Rest der Branche gemessen wird, während die fortschrittlichsten internen Modelle weiterhin firmeneigen bleiben. Ob „Physical Reasoning“ ebenso zu einem Bezugspunkt wird wie frühere Veröffentlichungen von AGIBOT WORLD, hängt davon ab, wie schnell externe Labore
Ergebnisse dazu zu veröffentlichen. Eine fünfte Version – oder die ersten externen Benchmark-Ergebnisse auf Basis von Version 4 – ist das nächste konkrete Signal, das es zu beobachten gilt.Dieser Bericht stützt sich auf die eigenen Veröffentlichungsunterlagen des Datensatzanbieters sowie auf dessen veröffentlichte technische Dokumentation. Dieser Artikel dient ausschließlich allgemeinen Informationszwecken und stellt keine Anlage-, Beschaffungs-, Rechts- oder technische Beratung dar.










