KAIST-ETRI-Roboter gewinnt internationalen Navigationswettbewerb durch doppelte Selbstüberprüfung
Ein Team aus KAIST und ETRI gewann den ECCV 2026 VLNVerse-Navigationswettbewerb durch die Entwicklung eines Roboters, der sein Ziel vor dem Anhalten erneut überprüft – ein selbstüberprüfender Ansatz, der es Servicerobotern ermöglichen soll, in nicht kartierten Gebäuden zu arbeiten.

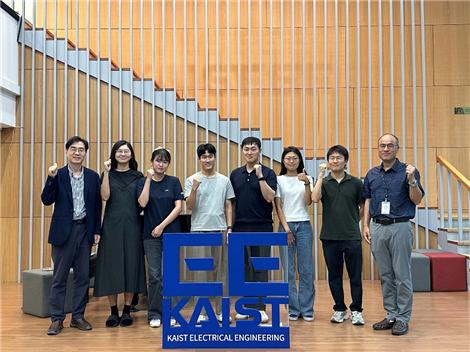
Ein Roboter, der eine Anweisung zwar perfekt befolgt, aber dennoch in den falschen Raum gelangt, ist der Fehlerfall, der bisher stillschweigend die Autonomie begrenzt hat, die Unternehmen einem mobilen Roboter in Innenräumen zugestehen. Ein gemeinsames Team der südkoreanischen KAIST und des Instituts für Elektronik- und Telekommunikationsforschung (ETRI) gab diese Woche bekannt, dass es sich bei der „VLNVerse Challenge“ – einem Teil der ECCV 2026-Konferenz für Computer Vision, die in Malmö, , die im Rahmen der ECCV 2026, einer Konferenz zum Thema Computer Vision, in Malmö stattfand, 111 andere Teams besiegt habe, indem es einen Roboter entwickelt habe, der seine eigene Arbeit überprüft, bevor er eine Aufgabe als abgeschlossen erklärt. Das Team mit dem Namen URL-FRRS, das sich aus dem Future-City-Robotiklabor der KAIST unter Professor Hyun Myung und der Forschungsgruppe für Feldrobotik des ETRI zusammensetzte, erzielte bei zwei Navigationsaufgaben eine durchschnittliche Erfolgsquote von 90,7 Prozent und setzte sich damit knapp gegen das zweitplatzierte Team durch, das zwar die gleiche Punktzahl erreichte, seine Ergebnisse jedoch später einreichte. Dasselbe zugrunde liegende System belegte zudem den zweiten Platz bei einem separaten Navigationswettbewerb, der parallel zur RSS 2026-Robotikkonferenz stattfand.
Die Aufgabe, anhand derer die Roboter bewertet wurden, wird als „Vision-Language-Navigation“ bezeichnet – ein Forschungsgebiet, bei dem ein mobiler Roboter eine gesprochene oder schriftliche Anweisung verstehen muss, beispielsweise den Auftrag, ein bestimmtes blaues Sofa in einem unbekannten Gebäude zu finden, und dann ausschließlich anhand von Kamerabildern und ohne vorgefertigte Karte des Raums dorthin zu gelangen. Vision-Language-Navigation ist aus kommerzieller Sicht von Bedeutung, da sie die technologische Schnittstelle darstellt zwischen einem Roboter, der nur in einer vorab kartierten Einrichtung operieren kann, und einem Roboter, der in einem neuen Krankenhaus, Lagerhaus oder Bürogebäude eingesetzt werden kann und dort sofort Anweisungen in einfacher Sprache von Mitarbeitern befolgt, die keine Robotikausbildung haben. ETRI ist Südkoreas führendes staatlich finanziertes Forschungsinstitut für Elektronik und Telekommunikation mit Sitz in Daejeon, und seine Forschungsgruppe für Feldrobotik hat jahrelang Navigationssysteme entwickelt, die letztendlich in kommerzielle Service- und Inspektionsroboter integriert werden sollen, anstatt sich auf akademische Maßstäbe zu beschränken.
Der Schritt der Selbstüberprüfung, der den Unterschied ausmachte
Das SiegerteamDie zentrale Innovation hinter dem Sieg von URL-FRRS ist eine Technik, die das Team als „CoRe-VLN“ bezeichnet – eine Abkürzung für „Coverage-Based Recovery for Vision-Language Navigation“ (abdeckungsbasierte Wiederherstellung für die Bild-Sprache-Navigation). Die meisten Bild-Sprache-Navigationssysteme stoppen ihre Bewegung, sobald ihr internes Modell schätzt, dass das beschriebene Ziel erreicht wurde – ein Ansatz, der immer dann versagt, wenn die Konfidenz des Modells falsch ist. Dies kommt in realen Gebäuden, die voller optisch ähnlicher Räume, Flure und Möbel sind, die aus der Perspektive einer Kamera gleich aussehen, häufig genug vor. CoRe-VLN lässt den Roboter stattdessen an seinem geschätzten Zielort innehalten, sich mithilfe eines multimodalen KI-Modells, das Bilder und Text gemeinsam interpretiert, umschaut und drei Dinge erneut überprüft, bevor er sich festlegt: ob der Standort mit den erhaltenen Angaben übereinstimmt, ob Farbe und Form eines Objekts mit dem übereinstimmen, was er finden sollte, und ob sich das Ziel tatsächlich in Reichweite befindet und nicht nur in der Ferne sichtbar ist. Sollte eine dieser Überprüfungen fehlschlagen, hält der Roboter nicht einfach an und meldet einen Fehler. Er setzt die Suche auf einem neuen Weg fort, anstatt seine erste beste Vermutung als endgültig zu betrachten.
Dieses Erholungsverhalten ist genau der Mechanismus, den eine einzeilige Zusammenfassung wie „der Roboter überprüft sich selbst“ oft verflacht, und es ist auch das Detail, das für jeden am wichtigsten ist, der beurteilt, ob diese Art von Navigationssystem kurz vor der Marktreife steht. Ein Roboter, der seine eigene Unsicherheit erkennen und entsprechend handeln kann, anstatt selbstbewusst den falschen Raum als richtig zu melden, wandelt eine Kategorie stiller Fehler in eine Kategorie langsamerer, aber selbstkorrigierender Erfolge um – was ein wesentlich anderes Risikoprofil für jeden Betreiber darstellt, der den Einsatz autonomer Navigation in einem Gebäude mit echten Patienten, Beständen oder Mitarbeitern in Betracht zieht. Stille Fehler sind bei kommerziellen Einsätzen die kostspieligere Art, da sie sich nicht als gemeldeter Fehler, sondern als verwirrter Nutzer zeigen und im Nachhinein wesentlich schwieriger zu beheben sind als bei einem Roboter, der sichtbar umkehrt und es erneut versucht.
A
Zweites System, das auf der Aufteilung der Aufgabe auf Spezialisten basiertDas Team erzielte bei der Navigations-Challenge der RSS-2026-Konferenz den zweiten Platz mit einem verwandten, aber architektonisch unterschiedlichen System namens PRISM-Nav, das die Navigationsaufgabe auf mehrere kleinere KI-Modelle verteilt, anstatt sich auf ein einziges großes Modell zu verlassen, das jeden Aspekt des Problems gleichzeitig bewältigt. Im Design von PRISM-Nav ist ein Modell dafür zuständig, wahrscheinliche Ziele zu identifizieren, die einer gesprochenen Anweisung entsprechen; ein zweites Modell hat speziell die Aufgabe, Gefahren wie Treppen zu erkennen, die ein Rad- oder Raupenroboter nicht sicher hinabfahren kann; und ein drittes Modell erkennt räumliche Regeln, beispielsweise welche Wege Fußgängerwege und welche Fahrspuren oder Sperrzonen sind. Ein vom Team selbst durchgeführter Vergleich ergab, dass dieser spezialisierte, auf mehreren Modellen basierende Ansatz größere Ein-Modell-Systeme übertraf, die dieselben Aufgaben zu bewältigen versuchten – ein Ergebnis, das der Annahme widerspricht, dass die Navigationsleistung in der Robotik in erster Linie davon abhängt, wie groß oder universell das zugrunde liegende KI-Modell ist.
Dieses Ergebnis hat direkte Auswirkungen auf Unternehmen, die Navigationsstacks für kommerzielle Serviceroboter statt für Forschungsdemonstrationen entwickeln: Eine Systemarchitektur, die kleineren, spezialisierten Modellen eindeutige, enger gefasste Aufgaben zuweist, lässt sich möglicherweise kostengünstiger betreiben und im Einsatz leichter debuggen als ein einziges großes Modell, das gleichzeitig Ziele, Gefahren und Verkehrsregeln auswerten soll, ohne dabei an Genauigkeit einzubüßen. Rechenkosten und Inferenzlatenz sind keine rein akademischen Belange mehr, sobald ein Navigationssystem kontinuierlich auf der integrierten Hardware eines Roboters statt auf dem Servercluster eines Forschungslabors laufen muss; zudem bietet eine spezialisierte Multi-Modell-Pipeline dem Bediener einen besseren Überblick darüber, welche spezifische Komponente verantwortlich ist, wenn sich ein Roboter unerwartet verhält, im Vergleich zu einem einzigen monolithischen Modell, dessen interne Schlussfolgerungen weitaus schwieriger zu überprüfen sind.
Der umfassendere Wettlauf, Roboter von vorab kartierten Umgebungen unabhängig zu machen
SchienenDie meisten mobilen Roboter, die derzeit in Krankenhäusern, Lagerhäusern und Hotels eingesetzt werden, sind nach wie vor darauf angewiesen, dass die Räumlichkeiten im Voraus kartiert und markiert werden – sei es durch fest installierte Magnetstreifen, vorab geladene Grundrisse oder einen speziellen Kartierungsdurchlauf, den ein Techniker durchführt, bevor der Roboter unbeaufsichtigt arbeiten darf. Diese Abhängigkeit verursacht erhebliche Einsatzkosten: Jede neue Etage, jeder neue Flügel oder jede saisonale Umstellung der Möbel in einem Krankenhaus oder Lagerhaus kann einen erneuten Kartierungsdurchlauf erfordern, bevor man einem Roboter wieder zutrauen kann, sich darin zurechtzufinden – und dieser Wartungsaufwand steigt proportional zur Anzahl der Standorte, die ein Betreiber automatisieren möchte. Die Forschung zur bild- und sprachgestützten Navigation, einschließlich der in dieser Woche von KAIST und ETRI vorgestellten Arbeiten, zielt direkt darauf ab, diese Abhängigkeit zu beseitigen, indem ein Roboter eine neue, nicht kartierte Umgebung so interpretieren kann, wie es ein menschlicher Mitarbeiter tun würde: indem er sich umschaut und gesprochene Anweisungen befolgt, anstatt einen vorab erstellten digitalen Grundriss zu konsultieren.
Forschungsgruppen an anderen Universitäten und in Unternehmenslabors, darunter auch Teams, die mit NAVER Labs Europe verbunden sind, haben in den vergangenen Monaten konkurrierende Ansätze für dasselbe zugrunde liegende Problem veröffentlicht – ein Hinweis darauf, dass sich die Bild-Sprach-Navigation von einem akademischen Nischenbereich zu einer der am intensivsten umkämpften Forschungsfronten in der mobilen Robotik entwickelt hat. Die spezifischen technischen Ansätze unterscheiden sich: Einige legen den Schwerpunkt auf eine Anpassung an neue Umgebungen ohne Nachtrainieren, andere auf die Selbstverifizierung und die Spezialisierung auf mehrere Modelle, die die Beiträge von KAIST und ETRI auszeichneten; das gemeinsame Ziel all dieser Bemühungen ist jedoch dasselbe: ein Roboter, der in ein neues Gebäude geliefert und noch am selben Tag in Betrieb genommen werden kann, anstatt erst nach einem kostspieligen Kartierungs- und Kalibrierungsprozess. Käufer sollten die Vielfalt der technischen Ansätze als Zeichen dafür werten, dass die zugrunde liegende Technologie rasch ausgereift ist, anstatt sich auf die proprietäre Methode eines einzelnen Unternehmens zu konzentrieren – was die Wahrscheinlichkeit erhöht, dass eine Version dieser Technologie
kommerzielle Produkte verschiedener Anbieter in den nächsten Jahren zu nutzen, anstatt an das Labor gebunden zu bleiben, das als erstes Ergebnisse veröffentlicht.Warum ein nicht zertifiziertes Forschungsergebnis dennoch den Zeitplan einer Beschaffung beeinflusst
Siege bei akademischen Robotik-Benchmarks allein reichen nicht aus, um ein Produkt in den Lagerbeständen zu etablieren, und CoRe-VLN sowie PRISM-Nav bleiben Forschungssysteme und sind keine kommerziellen Produkte mit einem festgelegten Veröffentlichungstermin oder Lizenzierungsweg. Was ein solches Ergebnis jedoch verändert, ist das Maß an Vertrauen, das Einkäufer von Servicerobotern und Anlagenautomatisierung in die Vision-Language-Navigation als kurzfristige Fähigkeit setzen können – und nicht als langfristiges Forschungsvorhaben –, da die ECCV und die RSS zu den wettbewerbsintensivsten und am aufmerksamsten verfolgten Veranstaltungen im Bereich Computer Vision bzw. Robotik zählen, und eine Erfolgsquote von 90,7 Prozent im Vergleich zu 111 konkurrierenden Teams stellt eine deutlich höhere Messlatte dar als das interne Demomaterial eines Anbieters, das in der Regel unter Bedingungen gedreht wird, die das System eher im besten Licht erscheinen lassen, anstatt es einem Stresstest zu unterziehen.
Betreiber von Einrichtungen und Systemintegratoren, die mobile Innenraumroboter für Krankenhäuser, Hotels oder Logistikstandorten sollten dieses Ergebnis als Anstoß nehmen, den in die engere Wahl gekommenen Anbietern eine spezifischere Frage zu stellen als „Versteht Ihr Roboter Sprachbefehle?“: ob das zugrunde liegende Navigationssystem überhaupt über einen Selbstüberprüfungs- oder Wiederherstellungsmechanismus verfügt oder ob es lediglich einen Erfolg meldet, sobald sein interner Konfidenzwert einen Schwellenwert überschreitet, ohne über einen Mechanismus zur Erkennung eigener Fehler zu verfügen. Dieser Unterschied, der in einer Verkaufsdemo weitgehend unsichtbar bleibt, ist genau die Lücke, die CoRe-VLN schließen soll, und er dürfte zu einem Standard-Bewertungskriterium werden, da immer mehr Anbieter die Bild-Sprach-Navigation in den nächsten Produktzyklen aus akademischen Benchmarks heraus und in kommerzielle Pilotprojekte überführen werden.
Der eigene Bericht des KAIST-ETRI-Teams über den Sieg kehrt immer wieder zu demselben operativen Detail zurück: Ein Roboter, der den Auftrag erhält, ein blaues Sofa zu finden, überprüft dennoch, ob
Ankunft, dass das Sofa davor tatsächlich blau ist, bevor es zum Stillstand kommt.Diese Analyse stützt sich auf öffentliche Erklärungen und Forschungsbeschreibungen, die von der KAIST und dem Forschungsinstitut für Elektronik und Telekommunikation (ETRI) zu den Ergebnissen des VLNVerse- und des RSS-2026-Navigationswettbewerbs veröffentlicht wurden. Sie dient ausschließlich allgemeinen Informationszwecken und stellt keine Anlage-, Finanz- oder Rechtsberatung dar.
Bildnachweis für das Titelbild: KAIST.