
Die Index-Plattform von Figure AI investiert 1 Milliarde US-Dollar in crowdsourced Roboter-Daten
Die Crowdsourcing-Datenplattform „Index“ von Figure AI hat 16 Millionen von Mitwirkenden eingereichte Videos erfasst und 15 Millionen US-Dollar ausgezahlt, während das Unternehmen über 1 Milliarde US-Dollar für Daten und Rechenleistung bereitstellt, eine Wette darauf, dass von Verbrauchern bereitgestellte Videos physischer Aufgaben – und nicht nur die Fernsteuerung von Robotern – der schnellste Weg sind, um den Datenengpass in der humanoiden Robotik zu überwinden.

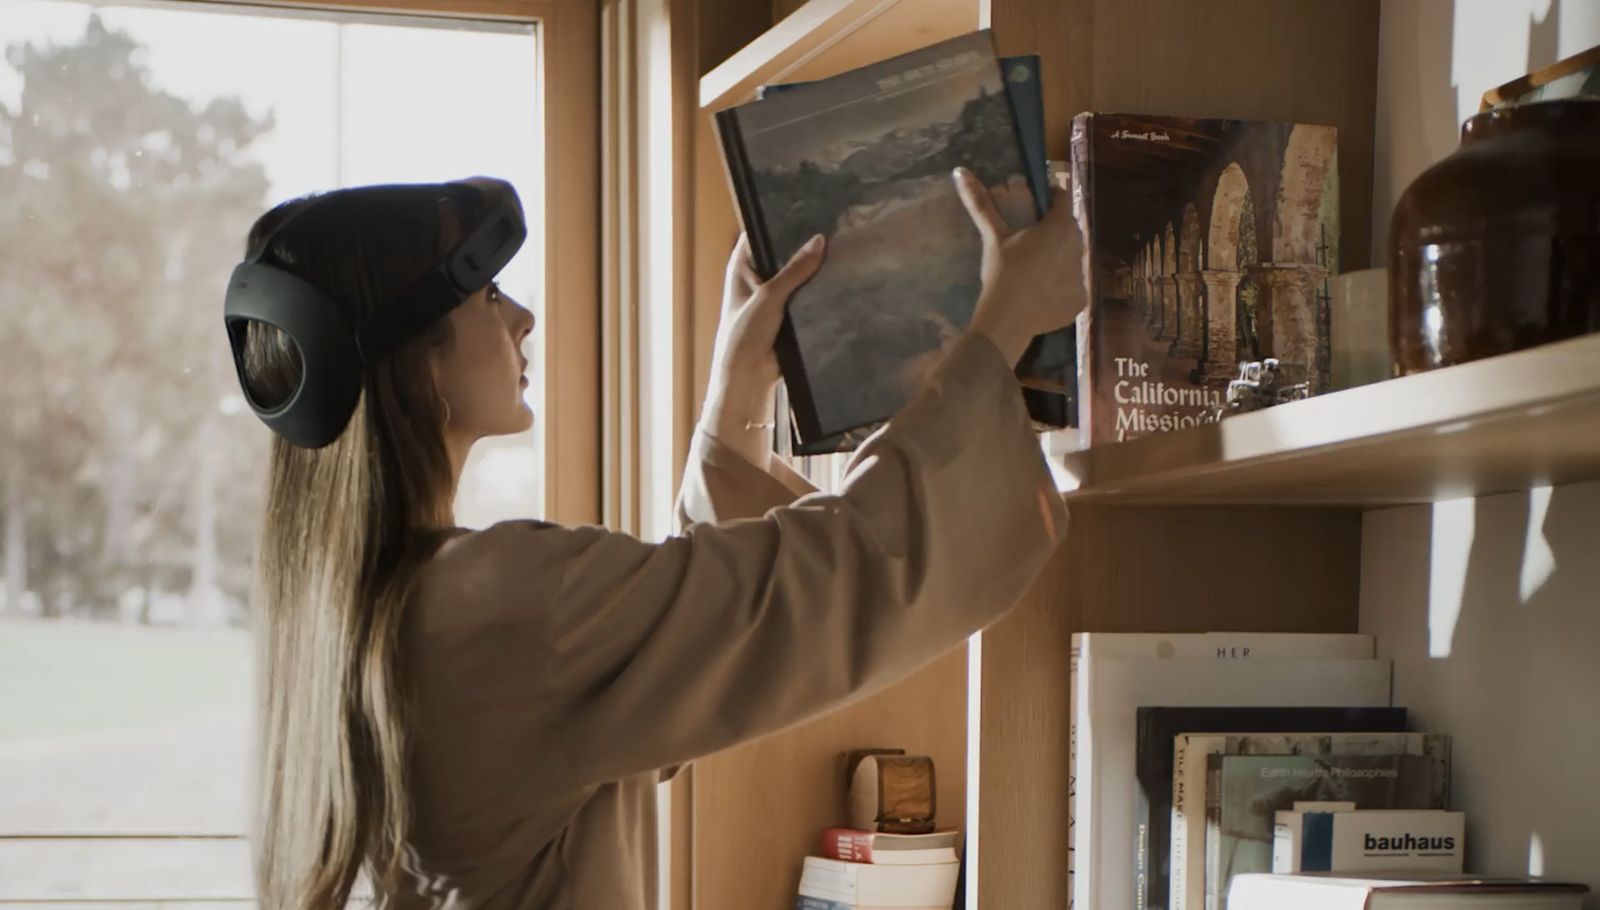
Der Datenengpass, aus dem sich die Humanoid-Robotik nicht freikaufen kann
Figure AI gab am Dienstag bekannt, dass seine auf Crowdsourcing basierende Plattform für Roboterschulungsdaten, „Index“, seit ihrer Einführung in mehr als 100 Ländern über 264.000 App-Downloads verzeichnet hat, wobei mehr als 44.000 wöchentlich aktive Nutzer über 16 Millionen Videos von alltäglichen körperlichen Tätigkeiten hochladen. Das Unternehmen gab bekannt, dass es bislang 15 Millionen US-Dollar an Mitwirkende ausgezahlt hat und für die nächsten 12 Monate Ausgaben in Höhe von mehr als 1 Milliarde US-Dollar für Daten und Rechenleistung zugesagt hat – eine Summe, die „Index“ von einem Nebenprojekt zu einer Investition macht, die gemessen am finanziellen Engagement zu einer der größten Wetten, die ein Unternehmen im Bereich der humanoiden Robotik jemals auf eine einzige strategische These gesetzt hat: dass die für die Entwicklung eines Allzweckroboters erforderlichen Daten aus der physischen Welt nicht im Internet vorhanden sind und von Grund auf neu erfasst werden müssen – eine Haushalts- und Lageraufgabe nach der anderen.
Die These selbst ist nicht neu. Jeder ernsthafte Entwickler im Bereich humanoider Robotik und verkörperter KI vertritt seit mindestens zwei Jahren eine Variante der Aussage „Die Daten existieren noch nicht“. Was Index besonders interessant macht, ist, dass Figure dieser Behauptung nun ein konkretes, überprüfbares Geschäftsmodell zugrunde gelegt hat, anstatt sie nur als Gesprächsstoff stehen zu lassen – und das gewählte Modell, eine Verbraucher-App, die normale Menschen dafür bezahlt, sich bei der Ausführung physischer Aufgaben selbst aufzunehmen, stellt eine deutlich andere Strategie dar als der Ansatz, den die meisten Wettbewerber verfolgt haben.
Warum Roboterdaten nicht einfach „gescrapt“ werden können
Der auf dem Internet basierende Ansatz mit Trainingsdaten, mit dem große Sprachmodelle aufgebaut wurden, lässt sich nicht ohne Weiteres auf die Robotik übertragen, und es lohnt sich, die Darstellung des Problems durch Figure für bare Münze zu nehmen und nicht als Marketing-Schönfärberei abzutun. „Die Daten, die für die Skalierung eines wirklich universell einsetzbaren Roboters benötigt werden, existieren nicht im Internet, sie müssen aus der realen Welt stammen: eine globale Stichprobe physikalischer Phänomene, die in jeder Umgebung auf der Erde erfasst wurde“, erklärte das Unternehmen in seiner Ankündigung. Texte und Bilder sind im Internet in praktisch unbegrenzter Menge vorhanden, da Menschen
Drei Jahrzehnte lang wurden diese Daten als Nebenprodukt der Kommunikation generiert. Videoaufnahmen einer Person, die einen Geschirrspüler aus einem bestimmten Blickwinkel belädt – mit Informationen zu Tiefe und Kraft, aus denen das Manipulationsmodell eines Roboters lernen kann –, existieren bei weitem nicht in diesem Umfang, da niemand Haushaltsarbeiten zu diesem Zweck aufgezeichnet hat, bevor Robotikunternehmen darum baten.Diese Knappheit ist die eigentliche Einschränkung hinter der in der Branche viel diskutierten „Sim-to-Real-Lücke“. Simulationen können unbegrenzt synthetische Trainingsdaten generieren, doch ein ausschließlich in der Simulation trainiertes Verfahren versagt in der Regel unter den chaotischen, physikalisch inkonsistenten Bedingungen einer echten Küche oder eines Lagerraums – genau diese Lücke soll Index schließen, indem es reale physikalische Interaktionen in großem Umfang erfasst. Die von Figure selbst veröffentlichten Kennzahlen vermitteln einen Eindruck davon, wie detailliert diese Erfassungsbemühungen sind: Pro 1.000 Stunden gesammeltem Videomaterial protokolliert die Plattform 373 einzigartige Aufgaben, 1.146 einzigartige Objekte und 116 einzigartige Umgebungen – eine Variationsdichte, die sich durch die interne Datenerfassung eines einzelnen Unternehmens kaum nachbilden lässt, ganz gleich, wie gut dieses finanziert ist, da hierfür der Zugang zu wirklich vielfältigen Wohnungen, Küchen und Arbeitsräumen erforderlich ist und nicht nur zu einer kontrollierten Laborumgebung.
Eine andere Datenstrategie als im übrigen Bereich der humanoiden Robotik
Die meisten Unternehmen im Bereich der humanoiden Robotik erstellen Trainingsdaten auf einem von zwei Wegen: entweder durch Teleoperation, bei der ein menschlicher Bediener einen physischen Roboter aus der Ferne steuert, um Aufgaben auszuführen, während das System die daraus resultierenden Sensor- und Aktionsdaten aufzeichnet, oder durch interne Flotten von beauftragten Datenerfassern, die unter Aufsicht des Unternehmens vordefinierte Aufgaben ausführen. Beide Ansätze liefern hochwertige, gut beschriftete Daten, doch beide lassen sich nur schwer linear skalieren, da eine Verdopplung des Datenvolumens in der Regel eine Verdopplung der Anzahl der beteiligten Roboter, Bediener oder beauftragten Datenerfasser erfordert. Index kehrt diese Kostenstruktur um, indem es anstelle von Hardware für die Roboter-Fernsteuerung eine Smartphone-App für Verbraucher als Erfassungsinstrument nutzt
Gerät, das es den Mitwirkenden ermöglicht, Aufgaben mit ihren Smartphones zu erfassen, anstatt den Zugang zu einem tatsächlichen Roboter zu erfordern, und bei dem sie pro Beitrag bezahlt werden, anstatt direkt angestellt zu werden.Diese Umkehrung bringt einen offensichtlichen Kompromiss mit sich. Smartphone-Videos fehlen die präzisen Kraft-, Drehmoment- und propriozeptiven Daten, die eine teleoperierte Robotersitzung von Natur aus erfasst. Das bedeutet, dass Index-Daten wahrscheinlich einer anderen, früheren Phase des Modelltrainings dienen als Teleoperationsdaten und eine umfassende visuelle und aufgabenstrukturelle Abdeckung bieten, anstatt der feinkörnigen Manipulationsdaten, die ein Roboter für die Endphasen der geschickten Steuerung benötigt. Die von Figure für die nächsten 12 Monate zugesagte Investition in Höhe von 1 Milliarde US-Dollar in Daten und Rechenleistung deutet darauf hin, dass das Unternehmen Index als einen Teil einer umfassenderen Datenstrategie betrachtet und nicht als vollständigen Ersatz für Teleoperation und laborbasierte Datenerfassung, Doch das Ausmaß dieses Engagements und die Tatsache, dass es zusammen mit einer spezifischen Aufgaben- und Umgebungsdichte pro 1.000 Stunden offengelegt wird, deuten darauf hin, dass Figure die Breite der Abdeckung – und nicht nur die Tiefe eines einzelnen Datentyps – als den Engpass betrachtet, dessen Beseitigung derzeit am wichtigsten ist.
Was die Auszahlungsstruktur über die Wirtschaftlichkeit für Mitwirkende aussagt
Die bisher an die Mitwirkenden ausgezahlten 15 Millionen US-Dollar bei einer Plattform mit mehr als 44.000 wöchentlich aktiven Nutzern deuten auf eine bescheidene durchschnittliche Vergütung pro Mitwirkendem hin, was mit einem Modell übereinstimmt, das auf hochvolumigen, reibungslosen Mikrobeiträgen basiert und nicht auf einer kleinen Anzahl professionell vergüteter Datenspezialisten. Das von Figure offengelegte Modell umfasst zudem eine On-Demand-Stufe, bei der Mitwirkende für bestimmte Aufgaben oder geschäftliche Tätigkeiten gebucht werden können und nicht nur eigenständig Daten erfassen – dies fungiert als Hybrid zwischen reinem Crowdsourcing und einem stärker strukturierten On-Demand-Arbeitsmarkt. Diese Struktur ist für jedes Unternehmen von Bedeutung, das prüft, ob ein ähnlicher Crowdsourcing-Ansatz für die eigene Datenstrategie funktionieren könnte: Die Wirtschaftlichkeit lässt sich nur in großem Maßstab realisieren, wenn die Vergütung pro Aufgabe so niedrig bleibt, dass eine Summe von 1 Milliarde US-Dollar
Durch eine jährliche Zusage können Millionen statt nur Zehntausende von Beiträgen finanziert werden, was wiederum voraussetzt, dass die zugrunde liegende Aufgabenbibliothek so einfach gestaltet ist, dass gewöhnliche Verbraucher – und nicht geschulte Spezialisten für die Datenerfassung – diese zuverlässig und ohne den Einsatz eines Roboters ausführen können.Die für den Einkäufer relevante Frage hinter einer Verbraucherdatenplattform
Für Beschaffungs- und Technologiebewertungsteams, die Anbieter humanoider Robotik bewerten, ist Index ein nützlicher Ansatzpunkt für eine Frage, die in Gesprächen mit Anbietern selten direkt gestellt wird: Woher stammen die Trainingsdaten dieses Unternehmens tatsächlich, und lässt sich diese Quelle in dem Maße skalieren, wie es die Roadmap des Unternehmens erfordert? Ein Anbieter, der sich in erster Linie auf interne Teleoperationsdaten stützt, ist durch die Größe seiner eigenen Flotte und die Anzahl seiner Bediener datenmäßig eingeschränkt – ein Engpass, der in etwa linear mit den Investitionen in Hardware und Personal wächst. Ein Anbieter mit einer funktionierenden Crowdsourcing-Pipeline in der von Index angegebenen Größenordnung – 16 Millionen Videos und steigend, verfügt über einen strukturell anderen und potenziell schnelleren Weg zur Aufgaben- und Umgebungsvielfalt, die ein Allzweckroboter benötigt, bevor er zuverlässig in den vielfältigen physischen Umgebungen eingesetzt werden kann, die die Einrichtungen eines echten gewerblichen Käufers tatsächlich bieten – im Gegensatz zu dem enger gefassten Satz an Aufgaben und Umgebungen, anhand dessen ein im Labor trainiertes Modell validiert wurde.
Diese Unterscheidung sollte künftig maßgeblich beeinflussen, wie ein Käufer die Leistungsversprechen eines Anbieters humanoider Roboter bewertet. Eine Roboterdemonstration, bei der eine Aufgabe in einer kontrollierten Umgebung fehlerfrei ausgeführt wird, sagt relativ wenig darüber aus, wie derselbe Roboter dieselbe Aufgabe in der tatsächlichen Anlage eines Käufers bewältigt – mit deren spezifischen Lichtverhältnissen, Unordnung und Objektvielfalt –, es sei denn, das zugrunde liegende Modell wurde während der Entwicklung anhand von Daten trainiert, die eine dieser Variationen nahekommende Situation erfassten. Einen Anbieter direkt zu fragen, welcher Anteil seiner Trainingsdaten aus Umgebungen stammt, die der eigenen Einsatzumgebung des Käufers ähneln – anstatt eine Demo für bare Münze zu nehmen –, ist eine sinnvollere Frage im Rahmen der Sorgfaltsprüfung, als es auf den ersten Blick erscheinen mag
Dies erscheint zunächst sinnvoll, und die Entscheidung von Figure, detaillierte Kennzahlen zur Dichte sowie Aufgaben, Objekte und Umgebungen pro 1.000 Stunden offenzulegen, bietet Käufern eine Vorlage für die Art von Konkretheit, die es sich lohnt, von jedem Anbieter einzufordern, der allgemeine Leistungsfähigkeit verspricht.Die strukturelle Strategie hinter der Milliarden-Dollar-Zahl
Die nennenswerte Tatsache für alle, die die Kapitalallokation in der humanoiden Robotik verfolgen, ist, dass Figure nun über einen Zeitraum von 12 Monaten mehr als 1 Milliarde US-Dollar speziell für Daten und Rechenleistung bereitstellt – eine Ausgabenkategorie, die weder physische Roboter, keine auslieferbare Hardwareeinheit und keine unmittelbaren Einnahmen in einer Größenordnung, die den Ausgaben vieler Wettbewerber für die Hardwarefertigung einer gesamten Produktlinie entspricht oder diese sogar übersteigt. Diese Mittelzuweisung ist an sich schon eine Aussage darüber, wo die tatsächliche Grenze der Branche liegt. Wenn Figure Recht hat, dass Daten – und nicht Aktuatoren, Sensoren oder Fertigungskapazitäten die entscheidende Einschränkung für die Leistungsfähigkeit von Allzweckrobotern darstellen, verschafft sich das Unternehmen, das die größte und sichtbarste Summe auf die Lösung dieses spezifischen Problems setzt, einen strukturellen Vorteil, den ein hardwareorientierter Wettbewerber nur schwer schnell aufholen kann, da der Aufbau einer gleichwertigen Datenpipeline Jahre des Wachstums eines Mitwirkernetzwerks erfordert und nicht nur eine einzige große Kapitalzufuhr. Sollte Figure sich irren und physische Daten auf Manipulationsniveau weiterhin eine teleoperierte „Robot-in-the-Loop“-Erfassung erfordern, die eine Verbraucher-App nicht vollständig nachbilden kann, wird das Milliarden-Dollar-Engagement eher zu einem kostspieligen Umweg als zu einem Wettbewerbsvorteil. Welches Ergebnis sich durchsetzen wird, wird sich nicht anhand der nächsten Finanzierungsankündigung von Figure zeigen, sondern daran, ob die nächste Generation der Helix-basierten Roboter eine messbar breitere Verallgemeinerung von Aufgaben in der realen Welt demonstriert als Wettbewerber, die sich hauptsächlich auf ferngesteuerte oder im Labor erhobene Daten stützen – ein Vergleich, den die Branche innerhalb der nächsten Produktzyklen anstellen können wird.
Haftungsausschluss: Dieser Artikel dient ausschließlich allgemeinen Informationszwecken und stellt keine
stellen keine Anlage-, Rechts- oder Beschaffungsberatung dar. Leser sollten die Angaben anhand von Primärquellen überprüfen, bevor sie geschäftliche Entscheidungen treffen.










