為什麼 Skild AI 選擇教機器人踢足球,而不是讓它從事倉儲工作
Skild AI 運用「自我對弈」而非人類示範,來訓練人形機器人踢足球,藉此測試機器人是否能學會超越任何人類教師所能示範的肢體技能。

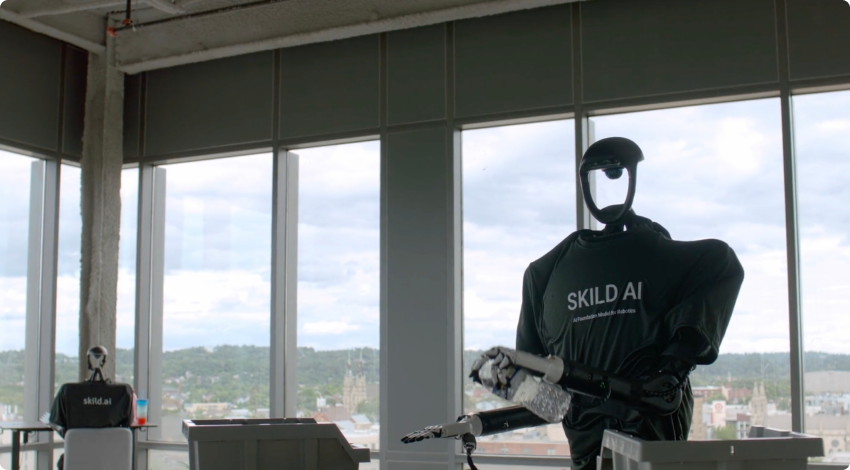
每個透過模仿人類來學習移動的機器人,都會繼承該人類的能力上限。 一隻基於數千小時人類遠端操作影片訓練而成的機械手臂策略,雖然能在影片中捕捉到的任務上表現得非常出色,但其表現無法超越所展示的示範,因為模仿學習的優化目標在於匹配人類的行為,而非超越人類的行為。Skild AI, 這家總部位於匹茲堡的機器人基礎模型公司,由卡內基梅隆大學研究員迪帕克·帕塔克(Deepak Pathak)和阿比納夫·古普塔(Abhinav Gupta)於 2023 年創立,並獲得由軟銀領投的融資輪支持,使其估值突破 140 億美元。該公司本月發表的研究結果指出,另一種訓練方法——自對弈(self-play)——能夠突破這個上限。 該公司訓練了一台類人型機器人踢足球,過程中完全未參考任何人類的足球示範,隨後將模擬環境中產生的策略轉移至實體硬體上。
訓練在 NVIDIA 的 Isaac Sim 模擬器中進行,獎勵函數中僅設定單一目標:進球。Skild 並未單獨編程處理帶球、鏟球、護球或從跌倒中恢復等動作。 這些行為皆是政策反覆嘗試擊敗對手時自然產生的副產品——該對手在每一輪中都是該政策的微幅改良版本。這與 DeepMind 用於訓練 AlphaGo 戰勝人類冠軍的「自我對弈」結構相同,也是 OpenAI 與 DeepMind 用於訓練《星海爭霸 II》和《Dota 2》競技代理的相同架構。 此處的創新之處不在於訓練方法——該方法在純數位遊戲中已有十年的先例——而在於其應用於實體人形機器人身上,該機器人必須將模擬策略轉化為真實的關節扭矩、真實的平衡限制,以及真實的跌倒風險。
為何「人類數據天花板」是真正的商業限制
對於評估機器人學習供應商的買家而言,「人類數據上限」並非抽象的研究議題。大多數已商業部署的
當今的機器人操作系統——包括用於倉庫揀貨、裝配線任務,以及日益普及的服務工作——至少部分是透過人類遙控操作或影片示範資料進行訓練的,因為收集這類資料比設計一個足夠複雜的獎勵函數來讓機器人從頭開始發現良好的策略要容易得多。 其權衡之處在於,廠商所生產的機器人技能水平,至多只能達到生成其訓練資料的示範者之水準;而若要以足以涵蓋部署過程中最終可能遇到的所有邊緣案例的規模來收集示範資料,不僅成本高昂,且耗時甚久。 僅透過示範抓取動作進行訓練的倉儲機器人,若遇到示範中未曾出現的物體形狀或方位,便會陷入困境;而透過對抗獎勵信號進行自我對戰訓練的機器人,原則上能持續針對該信號無限期地改進,且不受任何人類操作員示範內容的限制。正是基於這項區別,Skild 才將足球示範視為更廣泛能力主張的佐證,而非產品本身。畢竟沒有人會為了工廠生產線而購買會踢足球的人形機器人。 值得深入檢視的主張在於:這項底層技術——讓策略針對自身越來越困難的過往版本進行優化,而非依賴固定的人類示範資料庫——能否推廣至物流、建築及現場服務工作中常見的、充滿接觸且具有物理對抗性的任務: 在這些任務中,機器人必須從意外碰撞中恢復、適應不斷變化的負載,或處理行為與訓練資料預期不符的物體。
從模擬目標到能站立的機器人
這類研究中真正的實務難題,從來都不是讓策略在模擬器中表現出色。強化學習多年來已能產生令人印象深刻的模擬行為。真正的難點在於轉移步驟:一套針對模擬器進行調校的策略
當將近似物理模型、近似摩擦模型以及近似感測器雜訊載入到實際機器人中時——該機器人具備真實的馬達反向間隙、負載下的真實電池電壓下陷,以及模擬器未能精確建模的真實地面表面——這些模型往往會失效,有時甚至會造成危險。 Skild 的示範確實完成了這項轉移,將從 Isaac Sim 訓練出的足球策略移植到實體人形機器人上,並讓其在現實世界中與對手對戰,這正是該成果中更具挑戰性且更具商業價值的部分。 若僅停留在模擬階段,這項成就頂多只是研究界的奇聞軼事;而能成功跨越到實體硬體並存活下來的策略,則彰顯了其底層訓練方法的穩健性。據 Skild 本人所述,在訓練初期,模擬機器人幾乎無法行走。從這個起點發展到能夠帶球繞過防守者、 用身體擋住對手、執行鏟球,並在被撞倒後恢復平衡的策略,這段進程充分展現了「自主對戰」的真正優勢:它能從稀疏且簡單的目标中,發掘出廣泛的行為模式,而非需要工程師預先預測並手動編寫機器人可能面臨的每種情境。 這與基於示範的訓練過程有實質性的差異——在後者中,每種新行為通常都需要人類收集該特定行為的新範例。
多代理實驗對協調性的啟示
Skild 還進行了早期的四個代理足球實驗,從單一機器人對抗單一對手的模式,進階到多個機器人需要作為隊友進行協調的階段。 該公司報告指出,傳球與協調行為同樣在這些實驗中自然產生,同樣未經明確編程。若此結果能在更嚴謹的測試中得到驗證,則預示著一項超越體育領域的直接應用潛力:協調的多機器人行為,正是運作中的倉庫所需要的
一支移動式機械手臂機隊,或是同一座建築結構上運行多台機器人的施工現場,實際上究竟需要什麼;這在歷史上一直是多機器人系統中較為棘手的問題之一,因為協調失誤會以單一機器人失誤所沒有的方式產生累積效應。Skild 表示,其下一階段的研究將把「自主對戰」方法延伸至協作操作與導航任務,並更廣泛地應用於足球示範本身之外的日常機器人應用。 該公司提出的商業論點是,此技術能減少機器人學習系統為達到特定能力水準所需的人工示範數據量;若此論點能在商業部署所需的規模下成立,將能降低建構通用型機器人基礎模型時,其中一項成本最高且進展最緩慢的支出項目。
此方法與競爭對手針對同一問題的解決方案有何不同
試圖突破機器人學習在模仿方面的瓶頸,Skild 並非唯一一家。Physical Intelligence、 Figure 以及其他多家資金雄厚的機器人基礎模型公司,都分別發表了在基於示範的預訓練上疊加強化學習的各種變體;而「從模擬到實境的轉移學習」,多年來一直是人形機器人實驗室的熱門研究課題,包括 NVIDIA 自身在內——Skild 正是利用 NVIDIA 的 Isaac Sim 平台進行這項研究。 這些努力之間的差異,與其說是底層技術——自我對弈和強化學習都是成熟的工具——不如說是各家公司選擇用來展示該方法的具體領域,以及該領域能多直接地轉化為可銷售的商業能力。 關於行走與平衡的示範,這與多數腿式機器人研究團隊所發表的內容較為接近,能相當直接地對應到倉儲或現場服務機器人「保持直立並可靠移動」的核心需求。至於球類運動的示範,則與多數
商業應用案例,這正是 Skild 明確指出足球比賽結果僅是能力驗證而非產品的原因;而該公司所宣示的下一步——將相同的自主對戰架構應用於協作操作與導航——才是採購團隊在將此視為短期內可部署能力的證據之前,實際上應等待的成果。這個特定研究課題的競爭 stakes 極高,因為無論哪家基礎模型供應商能率先展示最具說服力、 最具通用性的自主對戰成果,便有充分理由宣稱擁有持久的技術領先優勢:當企業試圖涵蓋更多任務與更多機器人實現形式時,這種訓練方法能持續提升機器人的技能上限,且無需成比例增加昂貴的人工資料蒐集規模,其成本效益遠高於純模仿方法。 這正是為何像 Skild 這樣擁有雄厚資金與高估值的公司,會對「機器人足球」這類範圍如此狹窄的成果給予如此高度關注的商業邏輯:這是一項公開且可驗證的測試,用以檢驗該公司押注於更廣泛產品路線圖的訓練方法論,而非單純的產品發布。
示範與可部署系統之間的差距
上述任何因素都無法使「自主對弈」取代 S1 基礎模型現有的基於示範的預訓練,而 Skild 也並未如此宣稱。 S1 於 2026 年 8 月推出,其預訓練數據包含人類影片、手套捕捉數據、模擬數據及遙操作數據;而本月所描述的自我對弈研究,明確被定位為疊加在該基礎模型之上的後訓練擴展,而非取代原有訓練流程。 換言之,實際的架構仍以人類數據為起點,用以建立合格行為的基準線,隨後利用自我對戰將特定技能提升至超越僅憑基準數據所能教導的水平。這項主張比「自我對戰取代
「完全基於人類數據」,而這正是評估 Skild 的採購團隊——或任何提出類似論點的競爭對手基礎模型供應商——應要求該公司恪守的主張版本。隨著未來一年越來越多機器人供應商發布自主對戰結果,買家應不斷回歸「示範」與「可部署系統」之間的區別。踢足球的人形機器人所處的環境是受控、定義明確且獎勵稀疏的:進球與控球都容易精確測量,而失敗的策略也毫無歧義。 商業部署環境則更加混亂,獎勵訊號極難明確界定,例如「成功完成此訂單且未損壞庫存」;此外,測量系統也無法總是向供應商的自主遊玩迴路明確指出,某次嘗試是否真正成功。 Skild 的技術能否從擁有明確計分板的遊戲,轉移應用至成功定義遠較模糊的倉庫作業現場,正是此次示範所提出而非解答的開放性問題;而對於任何援引此結果作為其機器人正趨近通用能力證據的供應商而言,這正是值得直接提出質疑的問題。
本文綜合了 2026 年 10 月 16 日關於 Skild AI 自主對戰足球示範的報導,並參照截至所述發佈日期該公司融資歷史及其 S1 基礎模型的公開報導進行交叉核對。
本文僅供一般資訊參考之用,並不構成投資、採購、法律或工程方面的建議。數據反映上述來源截至所述資訊截止日之狀況,並可能在未經通知的情況下有所變動。