深入解析 OriginFlow 對肌肉訊號機器人數據的押注
清華大學博士候選人秦申濤創立一年之久的初創公司 OriginFlow 已籌集逾 6,900 萬美元資金,用於開發名為 NeuroScale 的系統。該系統採用手環式裝置,透過讀取肌肉訊號來擷取體感式人工智慧所需的力學與接觸數據,並將其封裝為可轉讓的「人體代幣」(Human Tokens)。

那個無人願意承認的瓶頸,才是真正的瓶頸
每家致力於開發通用機器人手臂的具身人工智慧公司,在行銷話術的表象之下,其實都在追逐同一個稀缺資源:足夠多的人手執行任務的記錄範例,這些範例必須精準、可重複,且以模型能夠實際學習的格式呈現。遙控操作裝置運作緩慢,且大規模運作的成本高昂。 動作捕捉服雖能追蹤位置,卻無法擷取決定抓握是否成功的力與接觸資訊。僅靠影片——這雖是最便宜且最豐富的数据來源——卻無法告訴模型手部施加了多大的力,或是指尖何時打滑;而這些正是機器人操作比剛性塊體更精細物件時所必需的關鍵資訊。 OriginFlow 是一家成立不到一年的北京新創公司,已募得超過 5 億元人民幣(約 6,900 萬美元),其論點在於:正是這項數據缺口——而非模型架構——才是限制類人型機器人與機械手臂操作能力實際提升速度的關鍵瓶頸。
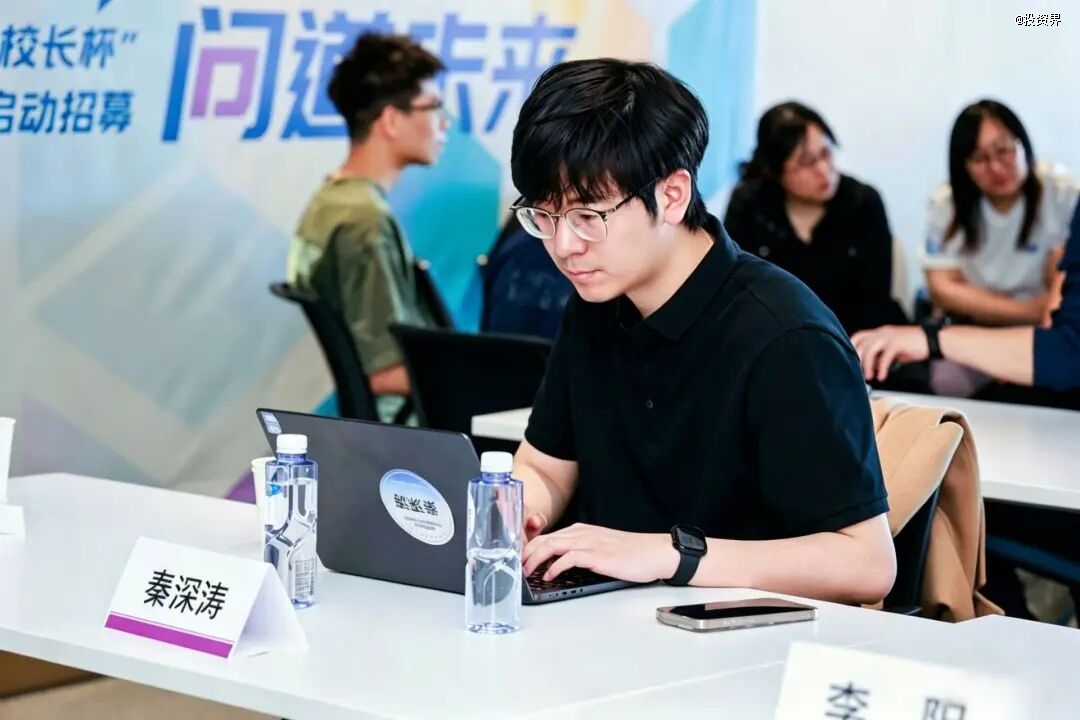
OriginFlow 由 25 歲的秦申濤於 2025 年 8 月創立,他目前是清華大學車輛與移動學院的博士生,本科畢業於哈爾濱工業大學機電工程學院。 在不到一年的時間內,該公司完成了天使輪、戰略投資及Pre-A1輪融資,投資方包括元和普華、 藍湖資本及綠洲資本,這樣的募資速度即使以今年中國競爭激烈的具身人工智慧(embodied AI)融資市場標準來看也屬罕見,這反映出該領域資金充裕的企業已迫切意識到,必須針對數據問題提出可行的解決方案。
NeuroScale 實際捕捉的內容
OriginFlow 的解決方案是一種名為「NeuroScale」的數據收集範式,其核心是基於非侵入式神經-運動介面,而非相機、手套或外骨骼。該公司的 OriginKit Gen 1.0 硬體是一款腕帶,可讀取表面肌電圖,該
肌肉收縮時產生的電訊號,是直接從皮膚擷取,而非事後追蹤手部位置。 該公司自研的模型「PULSE」能將這原始的電訊號解碼為連續的手部姿勢、施加的力道以及觸覺回饋數據——這些資訊是基於攝影機的系統無法獲取的,因為該系統從一開始就無法取得產生該動作的肌肉訊號。追蹤手部位置與讀取指揮該動作的神經訊號之間的區別,正是 OriginFlow 技術策略的核心。動作捕捉系統可以告訴模型指尖最終停留在何處; 卻無法告知模型該動作背後施加了多少力道、握力是正在加強還是已經開始滑脫,或是手部在動作過程中如何因應物體的意外阻力而進行調整——正是這類細緻的回饋迴路,區分了能輕拿細放、不壓碎雞蛋的機器人,與僅能處理堅硬且耐撞擊物體的機器人。 透過直接擷取肌肉訊號,OriginFlow 試圖精確還原那些力道與接觸資訊——這正是具身人工智慧產業最難大規模蒐集的數據類別。
從肌肉訊號到「人類標記」
該公司宣稱的目標不僅止於為收集更好的手部數據而收集。OriginFlow 將解碼後的姿勢、力道與觸覺資訊整合成所謂的「人類代幣」(Human Tokens)——這是一種可透過機器學習進行分析的動作表徵,旨在跨不同機器人實體進行轉移,而非僅限於用於收集數據的特定硬體。 這種框架直接借鑒了大型語言模型處理文本的方式:代幣是模型可從中學習的資訊單位,無論其最初來自哪份文件;而 OriginFlow 押注於物理互動資料也能以相同方式進行代幣化,如此一來,在某條手環上記錄的抓取動作,便能用於訓練由另一家廠商打造的機器人手。
完全不同的製造商。秦以直白的方式闡述了根本問題:他表示,現實世界缺乏一層能夠將複雜的物理互動資訊抽象化為可訓練表徵的層級——這正是文字與圖像資料在過去十年間,透過建構的標記化與嵌入管道所已具備的層級。 如果這個缺口如 OriginFlow 的論點所假設的那樣根本,那麼無論哪家公司率先建立出廣泛採用的物理互動數據抽象層,都將有機會成為整個具身人工智慧產業的基礎設施供應商,而不僅僅是向個別機器人實驗室銷售手環的硬體廠商。
為何投資者行動如此迅速
這輪為期五個月、規模達 5 億元人民幣(約合 6,900 萬美元)的融資進程,背後有個多數報導都忽略的背景。 2026年,中國具身AI領域的大部分時間都在將投資焦點從機器人硬體轉移——該市場已因數十家追逐相似規格的人形機器人製造商而日趨擁擠——轉向決定這些機器人實際投入使用速度的數據與模擬基礎設施。 一家能夠合理宣稱同時服務所有硬體製造商——而非與之競爭——的資料蒐集公司,其投資邏輯在結構上與支持另一家人形機器人新創公司截然不同;而中國數家最活躍的機器人投資機構已得出結論:相較於硬體領域,此類投資標的的估值被低估了。
這並不意味著該投資論點已獲證實。OriginFlow自身的商業化計畫—— 包括與未具名的領先企業建立工業製造合作夥伴關係,以及與58同城集團在家庭服務領域的數據收集合作,目前仍處於初期階段,處於逐案洽談的階段;而數據基礎設施公司的實際價值,完全取決於是否有足夠多的機器人製造商採用其數據格式,而非自行建立競爭性的數據管道。在此階段支持OriginFlow的投資者
當前階段的投資者對「抽象層」理論的背書,遠比任何當前的營收數據更為關鍵;這是一場對產業瓶頸未來將轉移至何處的賭注,而非著眼於當前的瓶頸所在。每項數據基礎設施投資都面臨的「採用難題」
相鄰產業中基礎架構層的發展歷史,在此提供了寶貴的警醒。一種資料格式只有在達到臨界量,並被下游使用者廣泛採用為共享標準(而非單一供應商的專有工具)時,才會真正具備價值;而這道採用門檻,所淘汰的極具潛力基礎架構公司,遠比任何技術缺陷所造成的損失還要多。 OriginFlow 的「Human Token」格式,不僅要與競爭對手的 sEMG 或遙控操作資料供應商抗衡,更要對抗每家類人型機器人製造商將自有訓練資料保留為專有資產、而非採用外部供應商格式的動機——特別是當製造商已投資建立自有資料管道之後。
Meta 針對消費級擴增實境控制所進行的神經介面手環研究,同樣基於類似的 sEMG 原理,這提醒我們:OriginFlow 並非唯一將肌肉訊號擷取視為具潛力介面層的企業;儘管 Meta 的努力旨在人機互動而非機器人訓練資料, 這代表著不同的商業目標與不同的採用路徑。對 OriginFlow 而言,更直接的競爭壓力來自於中國本土具身人工智慧領域內的遙操作數據公司及「模擬優先」數據供應商, 其中數家企業今年憑藉自身數據基礎設施的商業模式,已募得規模相當甚至更大的資金輪次,這意味著 OriginFlow 將「Human Tokens」確立為業界通用格式(而非眾多專有選項之一)的窗口期,可能比其募資速度所顯示的更為狹窄。
宣傳話術背後的數據所有權問題
OriginFlow 的商業模式也引發了一個問題,這是每個具身人工智慧訓練數據的買家最終都必須面對的,而這個問題早在此次事件之前就已存在
特定公司,並將超越該公司的存續期:當人類佩戴某公司的手環執行任務時所產生的數據歸誰所有?一旦這些數據被出售或授權給機器人製造商,該公司對由此產生的「人類代幣」仍保有何種權利? 隨著實體互動數據集從內部收集的副產品轉變為可交易的商業資產,這正是每位系統整合商都將面臨的數據所有權問題, 而 OriginFlow 迄今為止公開的資料,對其資料蒐集方法的描述遠比資料權利與授權條款更為詳盡——這種失衡現象在業界雖屬常見,但隨著該公司與 58 Group 的家政服務合作夥伴關係開始在人們家中(而非工廠內)蒐集資料,此問題的重要性將日益凸顯。事實上,家庭服務應用是 OriginFlow 發展藍圖中,在商業與倫理層面皆更為複雜的一環。工業製造數據的蒐集是在企業自有場地內,依據現有的職場同意框架進行; 而家庭服務的數據蒐集——旨在記錄個人執行清潔、烹飪或照護任務的過程,以便機器人最終能學習相同的動作——則涉及在私人住宅內進行活動記錄;在此情境下,同意、數據保留及重新識別的風險,遠比工廠車間來得高得多。 OriginFlow 與 58 集團如何規劃這項合作夥伴關係的同意與資料處理條款,很可能將決定未來其他家用機器人公司對與基於 sEMG 的資料蒐集商合作感到多麼安心。
什麼能證明這個論點是正確的
證明此論點正確的最明確訊號,並非另一輪融資,而是某家具名機器人製造商——理想情況下應是尚未與 OriginFlow 建立股權或合作關係的廠商——公開採用「Human Tokens」作為其商用產品的訓練資料。在該情況發生之前,本輪融資僅能證明投資人認同此論點
這雖具說服力,但並不能證明市場已將 OriginFlow 的格式視為優於競爭對手的選擇。對於那些不將這則新聞視為單純的募資頭條,而是視為「具身人工智慧」實際瓶頸正朝何處發展之訊號的人來說,這項區別至關重要。未來十二個月將揭曉,該領域針對資料瓶頸所做的各項競爭性押注中,哪一種是正確的:機器人操作的限制究竟在於硬體精度、模型架構,還是如 OriginFlow 所主張的那樣,在於缺乏一個能像語言模型抽象化文字那樣,將物理互動資料抽象化的層級。 若秦晟濤的論點成立,那麼擁有其他機器人所學習之代幣格式(token format)的公司,對產業發展軌跡的影響,最終可能比任何單一人形機器人製造商本週展示的新演示更為關鍵——無論 OriginFlow 自身的商業路線圖今後如何展開,這都是一個值得關注的可能性。
免責聲明:本文僅供一般資訊參考,不構成投資、法律或專業建議。讀者應在做出商業決策前,向原始來源核實相關細節。