Skild AIが、倉庫作業ではなくロボットにサッカーを教えた理由
Skild AIは、ヒューマノイドロボットにサッカーをさせるための訓練において、人間のデモンストレーションではなく「セルフプレイ」を採用し、ロボットが人間の教師が示しうる範囲を超えた身体的スキルを習得できるかどうかを検証した。

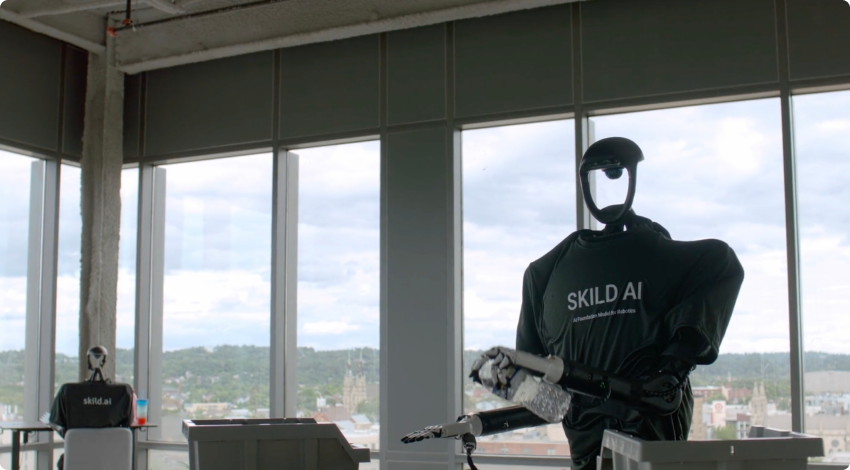
人の動きを模倣して移動を学習するロボットは、すべてその人の「限界」を受け継いでしまう。 数千時間に及ぶ人間の遠隔操作映像を用いて学習されたロボットアームのポリシーは、その映像に収録されたタスクを非常にうまくこなせるようになるが、提示されたデモンストレーション以上のパフォーマンスを発揮することはできない。なぜなら、模倣学習は人間の行動を上回ることを目指すのではなく、それに一致させることを最適化するためである。Skild AIは、 2023年にカーネギーメロン大学の研究者ディパック・パタク氏とアビナブ・グプタ氏によって設立され、ソフトバンク主導の資金調達ラウンドにより企業価値が140億米ドルを超えたピッツバーグを拠点とするロボット基盤モデル企業であるSkild AIは、今月、別のトレーニング手法である「セルフプレイ」によってその限界を打破できるとする研究結果を発表した。 同社は、サッカーに関する人間のデモンストレーションを一切使用せずにヒューマノイドロボットにサッカーをプレイさせるよう訓練し、その結果得られたポリシーをシミュレーションから実機へと転移させた。
トレーニングはNVIDIAのIsaac Simシミュレーター内で実行され、報酬関数には「ゴールを決める」という単一の目的のみが設定された。Skildは、ドリブル、タックル、ボールのシールド、転倒からの立ち上がりといった動作を個別にプログラムしなかった。 これらの行動はすべて、毎ラウンドごとに少しずつ改良された「自分自身」という対戦相手に繰り返し勝利しようと試みるポリシーの副産物として、自然に現れたものである。これは、DeepMindがAlphaGoを人間のチャンピオンを凌駕するレベルまで訓練するために用いたのと同じ「セルフプレイ」構造であり、OpenAIとDeepMindの両社が『StarCraft II』や『Dota 2』で競争力のあるエージェントを訓練するために用いたものと同じである。 ここで新しいのは、純粋なデジタルゲームにおいて10年の実績があるトレーニング手法そのものではなく、シミュレートされたポリシーを実際の関節トルク、実際のバランス制約、そして実際に転倒するリスクへと変換しなければならない、物理的なヒューマノイドボディへのその応用である。
「人間データの上限」がなぜ真の商業的制約となるのか
ロボット学習ベンダーを評価する購入者にとって、「人間データの上限」は抽象的な研究上の懸念事項ではない。商用展開されているほとんどの
倉庫でのピッキングや組立ラインの作業、そしてますます増えつつあるサービス業務などを扱う今日のロボット操作システムは、少なくとも部分的には、人間の遠隔操作や動画によるデモンストレーションデータを用いて学習されています。これは、ロボットがゼロから適切な行動方針を発見できるようにするほど洗練された報酬関数を設計するよりも、そうしたデータを収集する方が現実的だからです。 その代償として、ベンダーのロボットが発揮できる技能は、その学習データを生成したデモンストレーターの技能の範囲内に限定されてしまう。また、実運用で最終的に遭遇するあらゆるエッジケースを網羅するために必要な規模でデモンストレーションデータを収集するには、コストがかかり、時間もかかる。 デモンストレーションされた把持動作のみで訓練された倉庫用ロボットは、たまたまデモンストレーションされなかった物体の形状や向きには対応できなくなる。一方、報酬信号を用いて自己プレイを通じて訓練されたロボットは、原則として、人間のオペレーターが示した内容とは無関係に、その信号に対して無期限に改善し続けることができる。この違いこそが、Skild社がサッカーの実演を、製品そのものとしてではなく、より広範な能力の証明として位置づけている理由である。工場現場でサッカーをするヒューマノイドを購入する人は誰もいないからだ。 精査に値する主張は、固定された人間のデモンストレーションのライブラリではなく、自らが過去に行った、難易度が徐々に高くなるバージョンに対してポリシーを改善させるという基盤となる技術が、物流、建設、現場サービス業務に見られるような、接触が多く、物理的に敵対的なタスクに一般化できるかどうかという点である: こうしたタスクでは、ロボットは予期せぬ衝突から回復したり、変動する荷重に適応したり、あるいは訓練データが示唆していたものとは異なる挙動をする物体を扱わなければならない。
シミュレーション上の目標から実機ロボットへ
この種の研究における実際的な難点は、シミュレータ内でポリシーをうまく動作させることではありません。強化学習は長年にわたり、シミュレーション環境において印象的な挙動を生み出してきました。難点は転移の段階にあります。すなわち、シミュレータに対して調整されたポリシーが、
近似的な物理法則、近似的な摩擦モデル、および近似的なセンサーノイズは、実際のモーターのバックラッシュ、負荷時の実際のバッテリー電圧低下、そしてシミュレータが正確にモデル化していなかった実際の床面といった要素が存在する実際のロボットに組み込まれた場合、しばしば機能不全に陥り、時には危険な事態を招くこともあります。 Skild社のデモンストレーションでは、その転移を完全に成し遂げ、Isaac Simで学習したサッカーのポリシーを物理的なヒューマノイドに移植し、実世界で対戦相手と試合を行うことに成功した。これは、この成果の中でもより困難であり、商業的にもより重要な部分である。 シミュレーション内での成果だけでは、単なる研究上の珍事にとどまっていたでしょう。しかし、物理的なハードウェアへの移行を乗り越えたポリシーは、その根底にある学習アプローチの堅牢性を示す証左となります。Skild氏自身の説明によると、トレーニングの初期段階では、シミュレーション上のロボットはかろうじて歩くことしかできなかった。その出発点から、ディフェンダーの間をドリブルで抜け、 相手からボールを守り、タックルを決め、倒された後にバランスを取り戻すというポリシーへの進展は、「セルフプレイ」が実際に得意とすることを如実に示している。すなわち、ロボットが直面しうるあらゆる状況をエンジニアが予測し、手作業でコーディングすることを要求するのではなく、疎で単純な目的から幅広い行動レパートリーを発見することである。 これは、デモンストレーションベースのトレーニングとは本質的に異なる開発プロセスである。デモンストレーションベースのトレーニングでは、通常、新しい行動ひとつひとつについて、人間がその特定の行動の例を新たに収集する必要があるからだ。
マルチエージェント実験が示唆する協調性について
Skild社は、単一のロボットが単一の対戦相手と対戦する段階から一歩進み、チームメイトとして協調する必要がある複数のロボットを用いた初期の4エージェントサッカー実験も実施した。 同社によれば、これらの実験からも、やはり明示的にプログラムされることなく、パスや協調行動が現れたという。この結果がより厳格なテストの下でも裏付けられれば、それはスポーツの枠を超えた直接的な関連性を持つ能力を示唆することになる。すなわち、協調的なマルチロボット行動こそが、倉庫運営において
移動型マニピュレーターの群れや、同じ構造物上で複数のロボットを稼働させる建設現場が実際に何を必要としているか、という点は、単一のロボットの障害とは異なる形で協調の失敗が累積してしまうため、多ロボットシステムにおいて歴史的に見て特に解決が困難な問題の一つである。Skild社は、今後の研究段階として、この「セルフプレイ」アプローチを協調的な操作やナビゲーションタスクへと拡張し、さらに広くはサッカーの実演そのものを超えた日常的なロボット工学の応用へと展開していくと述べている。 同社が掲げる商業的な論点は、これにより、ロボット学習システムが所定の能力レベルに到達するために必要な、人間が作成したデモンストレーションデータの量が削減されるという点である。これが商用展開に必要な規模で成立すれば、汎用ロボット基盤モデルを構築する上で、最もコストが高く、進捗の遅いコストセンターの一つを低減することになるだろう。
同じ問題に対する競合アプローチとの比較
ロボットの学習を模倣の限界を超えて推進しようとしているのは、Skildだけではない。Physical Intelligence、 Figure、および資金力のある他のロボット基盤モデル企業群は、それぞれデモンストレーションに基づく事前学習の上に強化学習を重ねた様々な手法を発表しており、シミュレーションから実環境への転移は、Skildが本研究で利用したNVIDIAのIsaac Simプラットフォームを含む、ヒューマノイドロボット研究ラボ全体で数年にわたり活発に研究されてきた課題である。 これらの取り組みにおける違いは、基礎となる技術(セルフプレイや強化学習はいずれも確立された手法である)というよりも、各社がそのアプローチを実証するために選択した具体的な領域、およびその領域が販売可能な商用機能にどの程度直接結びつくかにある。 移動とバランスのデモンストレーションは、ほとんどの脚型ロボット研究グループが発表してきた内容に近いものであり、直立状態を維持し確実に移動するという倉庫ロボットやフィールドサービスロボットの核心的な要件に、かなり直接的に結びつきます。一方、球技のデモンストレーションは、ほとんどの
商用利用のユースケースにおいて、まさにその理由から、Skild社はサッカーの試合結果が「製品」ではなく「機能実証」であることを明確にしており、同社が次なるステップとして掲げる「同じ自律プレイ構造を協調操作やナビゲーションに応用する」という取り組みこそが、調達チームがこれを「短期的に導入可能な機能の証拠」とみなす前に、実際に待つべき成果である。この特定の研究課題における競争の賭け金は高い。なぜなら、最も説得力があり、 最も汎用性の高いセルフプレイの結果を最初に示した基礎モデルベンダーこそが、持続的な技術的優位性を主張する説得力を持つことになる。なぜなら、高コストな人間によるデータ収集を比例的に増やすことなくロボットのスキル上限を向上させ続けるトレーニング手法は、企業がより多くのタスクやロボットの具現化に対応しようとする際、純粋な模倣アプローチよりも低コストでスケールできるからだ。 ロボットサッカーという狭い分野での成果が、Skildのような資金力と企業価値を持つ企業からこれほど注目を集めている背景には、こうした商業的論理がある。これは、同社が自社の広範な製品ロードマップの成否を賭けているトレーニング手法に対する、公開された反証可能な検証であり、それ自体が製品発表というわけではないのだ。
実証と実用可能なシステムとの隔たり
こうした点から、セルフプレイがS1基盤モデルの既存のデモンストレーションベースの事前学習に取って代わるものではなく、Skildもそのように提示してはいない。 S1は2026年8月に、人間の動画、グローブキャプチャデータ、シミュレーションデータ、および遠隔操作データを用いて事前学習されたモデルとして導入されたが、今月発表されたセルフプレイの研究は、代替となるトレーニングパイプラインではなく、そのベースモデルの上に重ねられた事後学習の拡張として明確に位置づけられている。 つまり、実際のアーキテクチャは依然として、適切な行動のベースラインを確立するために人間のデータから始まり、その後、セルフプレイを用いて、そのベースラインデータだけでは習得できない特定のスキルを向上させている。これは、「セルフプレイが置き換える」という主張よりも、より控えめで、より説得力のある主張である。
「人間のデータを完全に」という主張であり、Skildを評価する調達チーム、あるいは同様の主張を行う競合する基盤モデルベンダーを評価する際は、この主張を基準として同社を評価すべきである。今後1年間で、より多くのロボットベンダーが自律プレイの結果を公表していく中で、購入者は「デモ」と「実運用可能なシステム」の違いを常に念頭に置いておくべきである。サッカーをするヒューマノイドは、制御され、明確に定義され、報酬が希薄な環境である。得点やボールの保持状況は正確に測定しやすく、敗北という結果も曖昧さがない。 一方、商用展開環境はより混沌としており、「在庫を損傷することなくこの注文を無事に履行した」といった、明確に定義するのがはるかに難しい報酬シグナルが存在し、測定システムによっては、特定の試みが実際に成功したかどうかをベンダーの自己学習ループに常に伝えることができない場合もある。 Skild社の手法が、明確なスコアボードのあるゲームから、成功の定義がはるかに曖昧な倉庫現場へと転用可能かどうかは、この実証実験が提示した未解決の課題であり、この結果を「自社のロボットが汎用的な能力に近づいている」という証拠として引用するベンダーに対しては、直接問う価値のある問いである。
本記事は、2026年10月16日付のSkild AIによるサッカーの自己プレイ実証に関する報道を、同社の資金調達履歴およびS1基盤モデルに関する公開情報と照らし合わせてまとめたものであり、記載された公開日時点の情報を基にしています。
本記事は一般的な情報提供のみを目的としており、投資、調達、法律、または技術に関する助言を構成するものではありません。数値は、記載された情報の締め切り時点における上記情報源を反映したものであり、予告なく変更される場合があります。