
Simate 成立三個月後便登上 RoboDojo 排行榜榜首
成立僅三個月的北京新創公司 Simate,憑藉一款採用人工智慧驅動的自動化研究流程所開發的模型,而非僅仰賴人類工程師,在 RoboDojo 機器人操作基準測試中名列前茅。

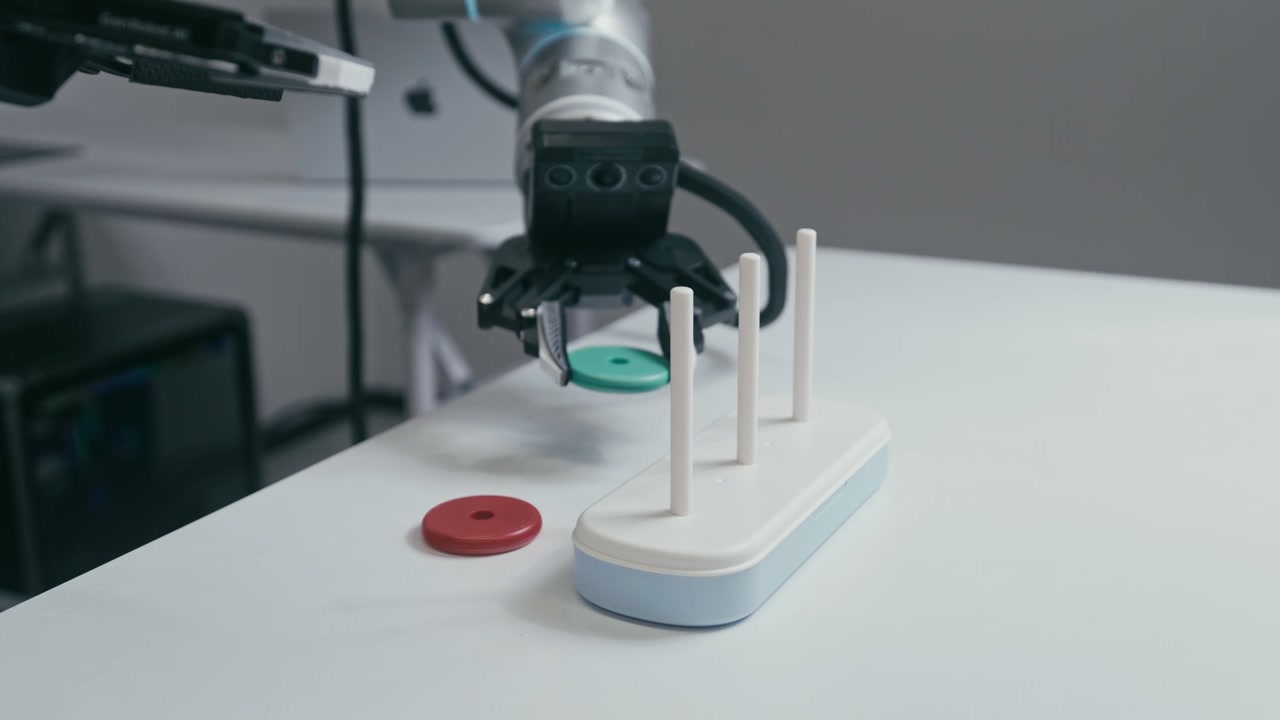
一家成立僅三個月的北京新創公司「Simate」,在廣受矚目的通用機器人操作基準測試「RoboDojo」中奪得最高分。該公司創辦人表示,其模型主要由其他人工智慧系統設計,而非僅由人類研究人員獨立開發。 Simate-beta 在 RoboDojo 上的平均分數為 33.95,任務成功率達 27.96%,在排行榜上領先所有其他參賽者,且並未針對該基準測試進行任何特定任務的調校。
Simate 由張英領軍,他曾擔任自動駕駛系統的核心技術負責人,並將該公司的底層方法描述為「物理 AI 的 AI」:利用自動化研究系統來設計、測試和優化機器人智能模型,其速度遠超單靠人類工程團隊所能達到的水準。 自三個月前成立以來,該公司已完成多輪融資,每輪估值均達數億元人民幣,此融資速度反映出,即使在企業生命週期的最早期、最未經驗證的階段,中國市場目前仍有大量資本正湧入實體AI研究領域。
Simate 總部位於北京,其業務處於一般所稱「物理 AI」或「具身 AI」領域的最早階段:建立基礎模型,讓機器人能夠在物理世界中感知並採取行動,這與主導文字和圖像生成領域的大型語言模型截然不同。 其核心產品「Sipai」是一套操作模型系列,其中包含運行於該公司稱為「Sinfra」的基礎設施層上的「Simate-beta」;而「RoboDojo」的成果,則是首個公開證據,證明該方法的表現足以與資金更雄厚的實驗室一較高下。
專為超越人類團隊迭代速度而建的自動化研究管道
Simate 與多數模型發布的區別,不僅在於基準測試分數本身,更在於該公司聲稱產生此分數的過程。Simate 建構了三個相互連結的系統:SiPAI 是一個模組化框架,使模型架構不僅對人類,更能對自動化分析清晰可讀
由誰撰寫的;AutoResearch 是一個系統,它從論文、程式碼儲存庫、先前實驗及內部資料中擷取即時情境,讓 AI 代理能自行提出並執行模型變更; 以及一個原生支援 AI 的基礎架構層,該層會在平行模擬中執行眾多候選實驗,再將表現最優的候選方案推廣至真實世界的機器人測試——這種彌合「模擬到現實」差距的方法,與 RobotAIGeek 在報導 SimFoundry 訓練資料自動化時所描述的自動化資料管線如出一轍。實際上,這意味著 AutoResearch 內的 AI 代理可以修改模型架構、調整訓練設定、啟動實驗、根據目標指標評估結果,並決定下一步該嘗試什麼;而人類研究人員只需設定戰略方向,而非親手編寫每項實驗。 Simate 將此定義為「物理 RSI(Physical RSI)」的連續光譜——即應用於機器人領域的遞迴自我改進,其範圍從「弱形式」(AI 協助執行例行實驗)到「強形式」(AI 驅動的迭代處理大部分研究循環,而人類則保留對追求哪些能力以及何時將結果視為可信並付諸實行的控制權)。
該公司現正向外部研究人員開放 AutoResearch,參與者包括來自麻省理工學院(MIT)、加州理工學院(Caltech)、清華大學及北京大學的研究人員,將最初作為內部工具的系統轉變為共享的研究平台。 這一步在商業層面與科學層面同等重要:若外部實驗室將 AutoResearch 作為其自身的實驗層,Simate 的自動化研究方法便會成為業界的參考基準,而非僅是某家公司的內部主張——這與早期開源模型訓練框架塑造了整整一代 AI 實驗室工作組織方式的情況如出一轍。
Simate-beta 的真正差異之處
該模型
該系統本身是圍繞公司稱為「四維物理感知」與「分層時間記憶」的兩項能力所建構。 前者旨在讓模型對物理特性(例如物體的重量、摩擦力與重心)產生實用的感知,而非將場景視為僅需進行模式比對的平面圖像;後者則旨在讓模型在漫長且多步驟的任務中保持情境記憶,而非將每個動作都視為從空白狀態開始。公開示範中,可看到機械手臂運用 Simate-beta 完成泡茶等任務——這套操作序列需要記住哪些步驟已完成、在拾取不同容器與器具時調整抓握方式與施力,並在中間步驟未按計畫進行時能流暢地恢復操作。 這些正是通用操作模型歷來難以突破的領域:業界常見的僅是單一技能的短暫示範,而能在長任務序列中保持穩定表現,並能針對微小錯誤進行逼真復原的模型,至今仍屬罕見。 RoboDojo 的設計初衷在於區分這兩類主張:它將記憶力、精準度、長時程執行能力與泛化能力作為獨立的能力維度進行評分,而非僅以單一的任務完成總分作為衡量標準;這也是為何在該平台上取得領先成績,其分量遠比在範圍較窄、僅測試單一技能的基準測試中奪冠更為重要。
Simate-beta 與排行榜上其他參賽者之間的差距相當顯著,絕非微不足道。在 Simate 參賽前的兩週內,該排行榜模擬項目中表現最佳的成績是 LiberAI 提交的 Liber-0 Preview, 其平均分數為 30.74,成功率為 25.52%;以及榜單上稱為 GPT-6-Astra 的參賽者,平均分數為 28.97,成功率為 22.48%。 另外兩項近期參賽作品——DeepSeek-Flash 以及標示為 GPT-5.5 的模型——在該排行榜更嚴格的評估設定下,得分低於 3.0,成功率亦低於 1%,這顯示出
一旦模型超出其訓練分佈範圍,表現便會急遽下滑。 Simate-beta 分別取得 33.95% 和 27.96% 的成績,在平均分數指標上領先第二名約 3 個百分點;據該公司表示,此成果是在未針對 RoboDojo 任務集進行模型微調的情況下達成的。模型背後自動駕駛人才的遷移
張英的背景是這則故事中結構上更引人入勝的部分。自動駕駛培育了一整代工程師,他們耗費數年解決的問題與具身人工智慧密切相關:在感測器雜訊下的即時感知、在不確定性下的規劃,以及建構必須在實驗室外而非僅限於示範環境中可靠運作的系統。 據描述,張英的團隊歷經三代架構演進——從基於地圖、到無地圖,再到端到端學習——建構出可與特斯拉「完全自動駕駛(Full Self-Driving)」系統相媲美的駕駛堆疊,這使團隊直接累積了恰恰是 AutoResearch 目前正試圖自動化的那種迭代式、數據驅動型模型開發經驗。
Simate 的其他核心聘僱也印證了同樣的模式。 香港科技大學助理教授詹方能(Zhan Fangneng)——其領導的實驗室專注於世界模型研究——以及研究員吉馬澤宇(Ji Mazeyu)——此前任職於一家專注於人形機器人控制、後被 Meta 收購的物理人工智慧新創公司——兩人都從相鄰的研究領域轉入通用操作領域,而非從該領域起步。 這種人才流動並非 Simate 獨有。隨著自動駕駛的投資週期趨於成熟,且相較於湧入具身人工智慧(embodied AI)領域的新資金而趨緩,一批資深工程師正持續從自動駕駛公司轉向人形機器人與操作機器人領域,帶來了純機器人研究團隊往往缺乏的生產工程紀律,這項轉變在
RobotAIGeek 對「世界模型時代」經濟學的分析,對於試圖將 Simate 置於更廣泛的浪潮之中、而非視為孤立事件的讀者而言,是一項有用的參考依據。為何應謹慎解讀成立僅三個月即奪得排行榜冠軍的現象
在成立三個月後取得的 RoboDojo 分數,確實是相當迅速的成果,但同時也屬於早期階段的表現。 在變化迅速的基準測試中,排行榜成績往往會在數週內被超越,因為競爭對手會針對相同的測試套件調整自己的模型;而且,基準測試的勝利並不能直接說明該模型能否可靠地部署在付費客戶的工廠車間或家庭環境中——在這些場所中,照明、 雜物與物體多樣性等變因,遠比基準測試中標準化的任務集更難以控制。Simate 尚未披露任何商業部署、付費客戶或量產時程;這項公告在商業層面之前,首先是一項研究與招募的里程碑。
值得關注的更持久主張,並非這個具體分數,而是 AutoResearch 能否真正產生疊加效應。 倘若透過 AI 輔助的迭代,Simate 能每隔數月便推出顯著改良的模型,而非遵循基礎模型開發常見的多年週期,該公司的優勢將來自研究速度,而非任何單一的架構構想;而這類優勢通常較難被競爭對手迅速複製。 反之,若在簡易優化方案耗盡後,自動化流程反而產生邊際效益遞減的現象,僅憑先發優勢所獲得的基準分數,將無法支撐這家公司與那些資金遠為雄厚、且已開始建構自身自動化研究工具的實驗室競爭。該公司承諾將於年底前發布的論文與開源貢獻,將是檢驗上述哪種模式正在演變的首個真正考驗。
對於採購團隊而言,以及
對於那些僅是觀察「具身人工智慧」市場、而非參與其研究競逐的自動化採購方而言,實際的啟示在於「耐心」而非「急迫感」。一家未公開客戶、未發表安全驗證報告、也無製造合作夥伴的基準測試領先者,雖值得密切關注,但目前尚不應列入候選供應商名單。 三至六個月後更值得重新審視的問題是:Simate 能否將研究進度轉化為系統整合商實際可取得授權並部署的解決方案?因為從排行榜成績到可實際應用的商業產品之間,正是過去兩年來多數快速崛起的實體人工智慧新創公司受阻之處。本分析綜合了截至 2026 年 9 月 27 日,關於 Simate「RoboDojo」成果的公司聲明、技術展示及公開報導。本文僅供一般資訊參考,並不構成投資或專業建議。
首圖來源:Simate。












