
NVIDIAの「Jetson Orin Nano 2」が、ロボットの演算電力消費を40%削減
NVIDIAの新型ロボット用コンピュータ「Jetson Orin Nano 2」は、推論性能を2倍に高め、消費電力を40%削減しており、2027年上半期の発売に先立ち、ドローン、家庭用ロボット、ビジョンAIの開発者に、エントリーレベルでありながら最先端クラスのエッジコンピューティング環境を提供します。

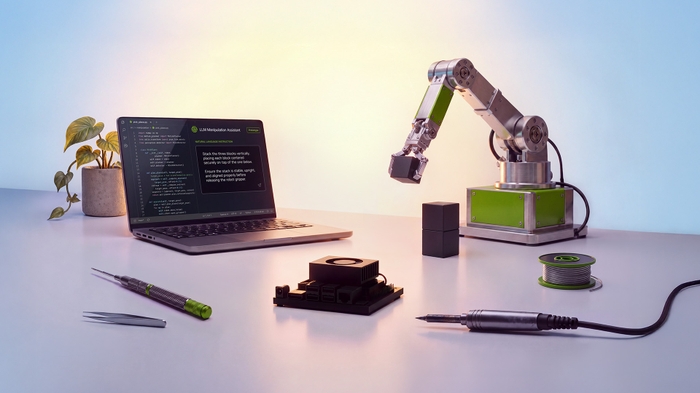
1秒あたり78兆回の演算処理で、エントリーレベルの計算性能の基準を塗り替える
NVIDIAは火曜日、ロボット向けコンピュータ「Jetson Orin Nano 2」を発表した。これは、前世代モデルと同じコンパクトなフォームファクタでありながら、毎秒78兆回のAI演算処理を実現する。既存の「Jetson Orin Nano Super」の推論性能の2倍を誇り、15ワットモードでは消費電力を40%削減している。 モジュールおよび開発者キットは2027年前半に出荷される予定であり、今回の発表の意義はチップそのものよりも、それが再定義する点にある。 フルサイズの産業用コンピューティングスタックを導入する余地はないものの、従来のエントリーレベルのエッジボードが対象としてきた限定的な知覚パイプラインではなく、最新の「視覚・言語・行動」モデルを実行するのに十分なオンボード推論能力を必要とする開発者にとって、利用可能な性能の下限が引き上げられるという点にある。
Jetson Orin Nano 2は、78 TOPSのAIエンジンに8GBのメモリと8コアのArm CPUを組み合わせている。この仕様は、NVIDIAのフラッグシップであるThorやOrin AGXプラットフォームと比べると控えめに見えるが、特定の購入者層に合わせて調整されている。 配送ドローン、検査ロボット、家庭用ロボティクスプラットフォーム、およびビジョンAIシステムを開発するチームです。これらの分野では、純粋なスループットと同様に、部品原価や消費電力の制約も重要な要素となります。NVIDIAのロボティクスおよびエッジAI担当副社長であるDeepu Talla氏は、今回のリリースをフラッグシップモデルの刷新ではなく、「民主化」に向けた取り組みとして位置づけました。 「Jetson Orin Nano 2コンピュータは、この画期的な技術を何百万人もの開発者の手の届く範囲に置き、エッジでのリアルタイム推論に必要なパフォーマンスとエネルギー効率を実現します」とタラ氏は述べ、NVIDIAが過去2年間にわたり、データセンター用GPUから組み込みフォームファクタへと製品スタック全体に展開を進めてきた生成AI機能に言及した。
消費電力が40%削減されたという点は、最も注目すべき数値だ。エッジロボティクスプラットフォームは、データセンター用アクセラレータとは異なり、ほぼ常に熱的および電力的な制約に直面している。例えば、配送用ドローンの飛行時間は、
そのバッテリー消費量の多くは推進力から奪われており、移動型サービスロボットの1回の充電あたりの稼働時間は、そのロボットが施設の稼働シフトに収まるか、それとも稼働率を低下させる余分な充電サイクルを必要とするかを決定づける。消費電力をほぼ半分に削減しながら性能を安定させられる演算モジュールは、既存の設計の運用コストを削減するだけでなく、 与えられたバッテリー容量と熱設計の制約の範囲内で物理的に実現可能な設計の幅を広げます。まさにこの制約こそが、多くの低コストロボットを、ビジョン・言語・アクションモデルが要求するようなオンボードのシーン理解ではなく、単純な障害物回避機能に限定してきた要因なのです。アーリーアダプターが示す、コンピューティングが実際に活用される場面
NVIDIAは、マシンビジョン、建設機械、家庭用ロボット、空中配送の各分野にわたる4社の早期アクセスパートナー、すなわちCognex、Doosan Bobcat、Matic、Wingを発表した。Alphabet傘下のドローン配送子会社であるWingは、特に飛行時間の経済性という観点からこのモジュールを評価している。 「Wingは、Jetson Orin Nano 2を活用し、顧客への配送をより迅速かつ信頼性の高いものにする、応答性が高くエネルギー効率に優れたドローンの実現に向けた道筋を模索しています」と、Wingの知覚部門責任者であるディヌカ・アベイワルデナ氏は述べた。 この視点、つまり純粋な性能ではなく「応答性と信頼性」を重視する姿勢こそが、商業ユーザーが実際にコンピューティング性能のアップグレードをどのように評価しているかを如実に物語っている。「より大規模なモデルを実行できるか」ではなく、「車両の重量クラスを変えずに、既存のサービスをより信頼性の高いものにできるか」が問われているのだ。
家庭用ロボットスタートアップのMatic Roboticsは、このモジュールを逆の方向に活用しており、追加された余力を消費電力の削減ではなく、機能の拡張に充てている。 「Jetson Orin Nano 2により、Maticは、リアルタイムの知覚、相互作用、ナビゲーションのために構築されたコンパクトな家庭用ロボットプラットフォーム上で、最先端のAIモデルをエッジ側で実行できるようになります」と、Maticの共同創業者兼CEOであるナヴニート・ダラル氏は述べた。Wingとの対照的な
「効率重視」のユースケースと「機能重視」のMaticのユースケースは、2026年におけるエントリーレベルの演算能力アップグレードが実際に何のためにあるのかを、かなり明確に示しています。 すべての購入者が、より大きな余力から同じものを求めているわけではない。むしろ、設計の幅が広がることで、バッテリー寿命であれオンボードモデルの複雑さであれ、各製品カテゴリーがそれぞれにとって最も大きな制約を、実質的に高価なコンピューティング階層へ移行することなく解決できるようになるのだ。なぜエントリー層こそが真の販売数量の中心となるのか
NVIDIAのJetsonシリーズは、過去数世代にわたり、かつてはフルサイズのデスクトップGPUを必要としていた性能を、モバイルロボットのシャーシに直接取り付けることができるほど小型のモジュールフォームファクタへと押し下げてきました。 世代を重ねるごとに変化してきたのは、上限(ThorやOrin AGXのようなフラッグシップモジュールは常に純粋なスループットで業界をリードしてきた)というよりは、むしろ下限の位置です。部品コストに真に制約のあるロボット開発プロジェクト、単価競争を繰り広げる倉庫用AMRメーカー、 積載量の1グラムごとに争いが生じるドローンスタートアップ、産業用ではなく消費者向けの価格帯を目指している家庭用ロボット企業などは、単にフラッグシップモジュールを仕様として採用し、そのコストを転嫁することは決してできませんでした。なぜなら、消費者向けや小規模商用向けの価格帯では、コンピューティング関連のコスト項目は製品総コストのごく一部に抑えなければならないからです。 こうした購入者は、マーケティング上の注目度は最も低いものの、数量ベースではロボット用コンピューティング市場の最大のセグメントを占めており、NVIDIAが最先端クラスの生成AI性能を製品ラインナップの最上位モデルに限定せず、エントリーレベルのモジュールに組み込むことで狙っているのは、まさにこのセグメントである。
この枠組みは、NVIDIAが発表の冒頭で、生のスループットではなく効率性を強調した理由も説明している。ロボット工学向けコンピューティングのマーケティングは、歴史的にTOPSを指標とした「軍拡競争」であり、その尺度で言えば、Jetson Orin Nano 2の78 TOPSという数値は意義深いものの、カテゴリーを定義するほどのものとは言い難い。
jump。より重要な数値は、同等の性能を維持したまま消費電力を40%削減できるという点である。なぜなら、これは単に完成後の動作速度を示すだけでなく、特定のロボット形状がそもそも製造可能かどうかを決定づける指標だからだ。 クラウドサーバーとの往復通信を必要とせず、リアルタイムのオンボード推論、シーンの理解、操作シーケンスの計画、予期せぬ障害物への適応を要する「視覚・言語・行動」モデルには、その下限を下回るとロボットがタスクを確実に実行できなくなる計算能力の最低ラインが存在する。 これまで、エントリーレベルの価格帯と消費電力レベルでこの下限に達することは極めて困難であったため、多くの「AI搭載」の民生用および軽商用ロボットは、実際にはより限定的なルールベースの知覚スタックを搭載して出荷され、AI機能については機能面よりもむしろ理想的な側面を強調して販売されてきました。 Jetson Orin Nano 2は、エントリーレベルでも本格的なAIを実行できるようになったというNVIDIAの賭けである。2027年前半までの調達戦略
現在、次世代のロボット、ドローン、または固定ビジョンシステム向けの演算リソースを仕様策定中の調達チームやエンジニアリングチームにとって、現実的な課題は「採用すべきかどうか」ではなく、「いつ採用するか」という点にある。 NVIDIAは価格を公表しておらず、このモジュールは2027年上半期まで出荷されない。つまり、それ以前に部品表(BOM)の決定期限を迎えるプログラムは、デフォルトでOrin Nano 2ではなく、現行のJetson Orin Nano Superや競合するエントリーレベルプラットフォームを基準に仕様を策定することになる。 これらのチームにとって重要な判断は、NVIDIAが一般的に同一フォームファクタ内のJetson世代間でピンおよびソフトウェアの互換性を維持してきたことを踏まえ、新しいモジュールが登場した際にハードウェアのリビジョンサイクルが交換を許容するか、あるいは現世代に今コミットすることが、製品ライフサイクル全体を通じて消費電力と性能のギャップを抱え続けることを意味するかどうかです。
NVIDIAが発表と同時に公開したエコシステムリストには、AAEON、ADLINK、Advantech、Aetina、Antmicro、Aptivなど、16社以上のパートナー企業が名を連ねています。
また、AVerMediaについても、定型文としてではなく、直接目を通す価値のある情報です。 これらは、ベアコンピュートモジュールを、実運用可能な堅牢な製品へと変換するキャリアボードおよびシステムインテグレーションベンダーであり、発売時に献身的なインテグレーターが多数参画していることは、通常、シリコンが利用可能になってから、購入者が社内でキャリアボードを設計する必要なく、完成した認定済みボードを購入できるようになるまでのリードタイムが短縮されることを意味します。 専任のハードウェアエンジニアリングチームを持たない中規模のロボット工学やオートメーション企業にとって、このエコシステムの深さは、単なるTOPSの数値よりも重要な場合が多い。なぜなら、それが、新しいコンピューティング層が、購入者が自ら製品化しなければならないリファレンスデザインではなく、インテグレーターが実際に見積もりを提示し出荷できるものになるまでのスピードを決定づけるからである。また、そのエコシステムの広がりは、交渉上の優位性にも影響を及ぼしますが、購入者は初期の仕様策定段階でこの点を過小評価しがちです。 単一ソースのコンピューティングモジュールでは、製品のライフサイクルを通じて、あるベンダーの価格設定やリードタイムに縛られてしまいます。一方、12社以上のボードレベルインテグレーターがパッケージ化を競い合うモジュールであれば、基盤となるシリコンが1社のサプライヤーから供給されている場合でも、システムレベルで真の価格競争が生まれます。 2027年の製品発売に向けてJetson Orin Nano 2を仕様化する調達チームは、キャリアボードの選定をシリコンの選定とは切り離して考えるべきであり、前世代のボードを供給したベンダーを無条件に選ぶのではなく、指定されたインテグレーターのうち少なくとも2~3社から見積もりを依頼すべきです。なぜなら、同じ基盤モジュールを用いていても、ボードレベルの価格、コネクタのレイアウト、 熱設計は、同じ基盤モジュールを用いていてもインテグレーターごとに大きく異なるためである。
また、購入担当者は、製品発表から実機入手までの期間と自社のプログラムスケジュールを照らし合わせて検討すべきです。Jetsonクラスのモジュールでは、製品発表からハードウェアの出荷まで8~10ヶ月のリードタイムが一般的ですが、これは、早期または
2027年半ばに向けて、現時点で、暫定仕様を用いて新しいモジュールを想定した設計を行い、最終仕様が変更された場合に設計上のリスクをある程度受け入れるか、あるいは現行世代を出荷し、Orin Nano 2が一般提供された時点で製品ライフサイクル半ばでのハードウェア改修を計画するか、決定する必要があります。 どちらの選択肢も一概に正しいとは言えず、正しい答えは、製品の競争上の差別化要因が、機械設計、ソフトウェア、価格といった他の要素と比べ、コンピューティング層そのものにどれほど依存しているかによって異なります。しかし、これはデフォルトで決めるのではなく、慎重に検討して下すべき決定です。2027年に向けてエッジAIプラットフォームのベンチマークを行う者にとって、注目すべき事実は単純明快だ。NVIDIAは、同じシリコン世代内で消費電力を40%削減しつつ、性能を横ばいに維持できることを実証した。これは、これまでのほとんどのエッジコンピューティング製品のライフサイクルを特徴づけてきた「純粋なTOPSの増加」とは本質的に異なる曲線であり、 これは、エントリーレベルのロボティクス向けコンピューティングにおける次の競争軸が、「シリコン1ドルあたりの演算能力」ではなく、「電力予算1ドルあたりの効率」であることを示唆しています。
免責事項:本記事は一般的な情報提供のみを目的としており、投資、法律、または調達に関する助言を構成するものではありません。読者は、ビジネス上の意思決定を行う前に、一次情報源で詳細を確認する必要があります。










