
只用一枚硬幣和錯誤決策打敗機器人起義的五種方法
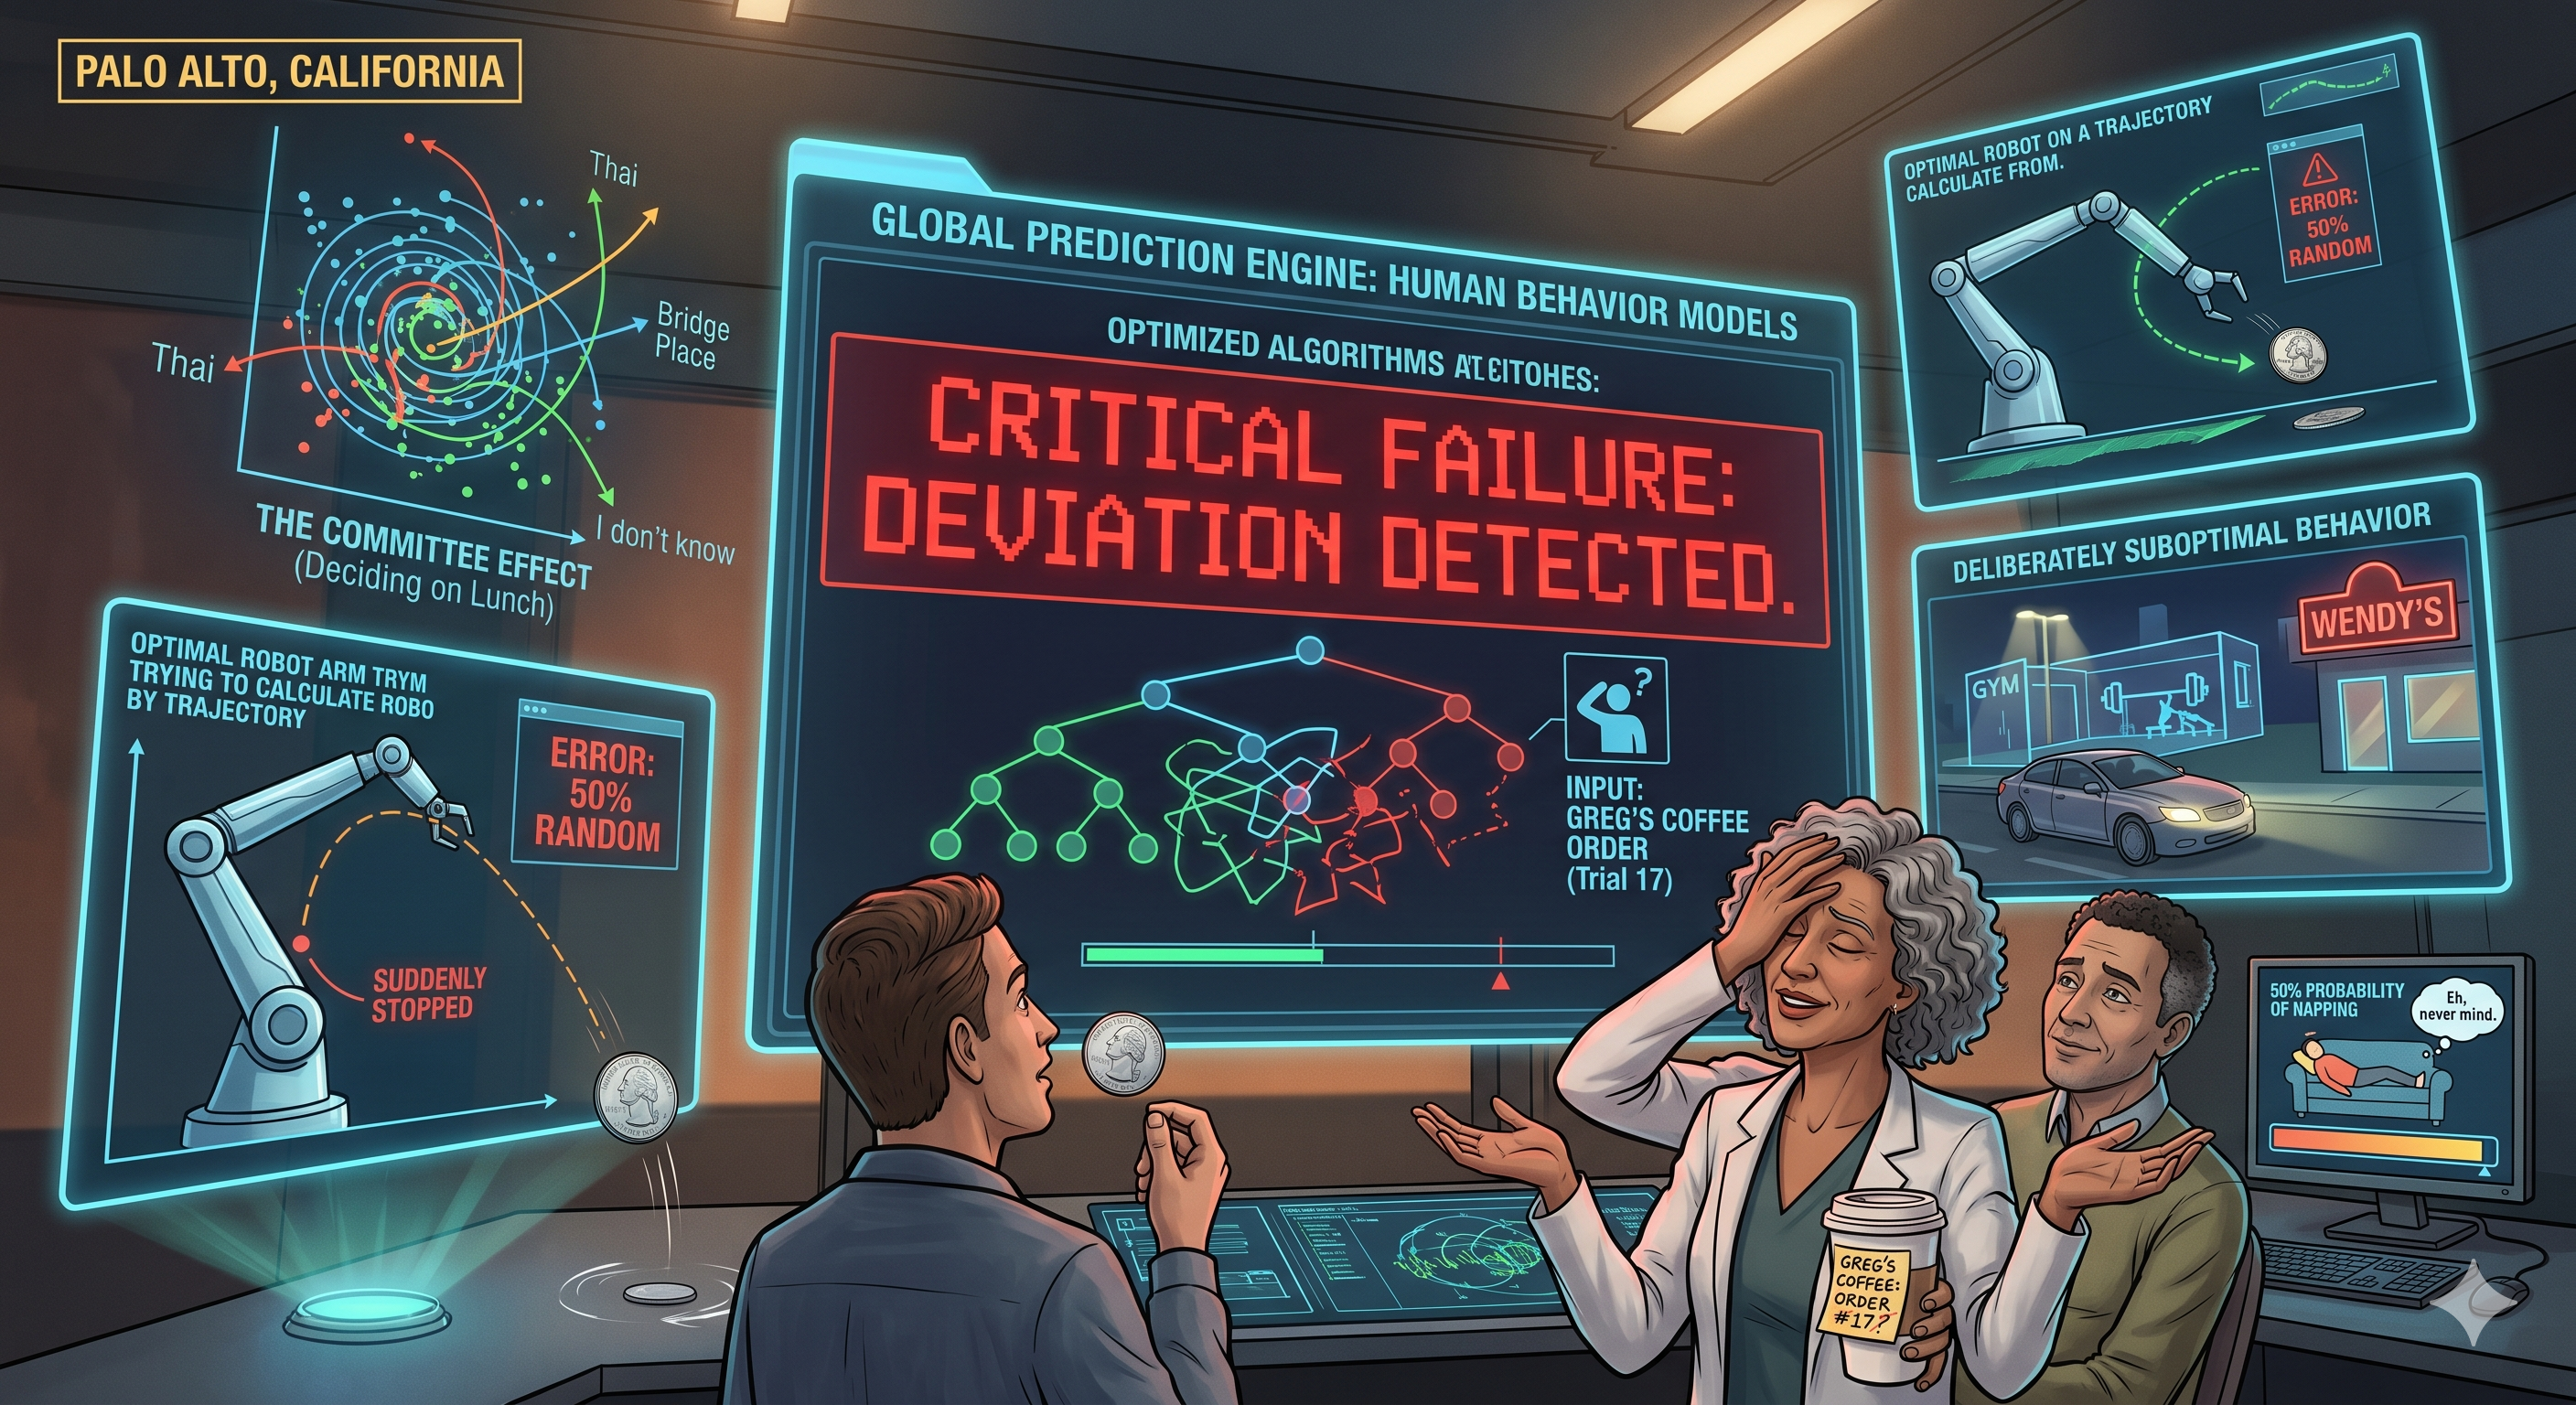
專家們一致認為,機器從未預料到會出現「半途而廢」的情況。
加州帕洛阿爾托訊 — 隨著超智能人工智慧系統逐漸邁向自主決策,越來越多的研究人員、退休人士,以及曾經試圖與家人規劃晚餐的人們,都達成了同一個充滿希望的結論:人類會沒事的,因為我們在深層、結構上,甚至在精神層面上,都是難以預測的。
「他們用有史以來記錄的每種人類行為來訓練這些系統,」戰略前瞻研究所的萊諾爾·哈薩尼博士表示。「但他們沒訓練過我丈夫葛雷格——他在三週內毫無理由地變換了十七次咖啡點單。葛雷格就是那道防火牆。」
以下是抵抗運動的實地指南。
1. 硬幣
這枚不起眼的雙面硬幣,至今仍是人類有史以來所構思出的最具顛覆性的單一軍事裝備。現代人工智慧系統能根據你的搜尋紀錄、生物特徵數據,以及你閱讀時慣常傾斜頭部的精確角度,以高達94%的準確度預測你的下一步行動。但它們無法預測一枚25美分硬幣。
「我們用所有模型對十美分硬幣進行了模擬,」一位要求匿名的DARPA承包商表示。「結果是十美分硬幣贏了。」
建議部署方式:擲硬幣決定是逃跑、戰鬥,還是點份三明治。接著無視結果,完全做別的事情。這稱為「雙重隨機化」,從技術上來說,這是一項針對線性代數的戰爭罪行。
2. 刻意採取次優行為
機器人是「優化者」。牠們假設你也是「優化者」。但你不是。你只是個曾多次付了健身房會費,卻在前往溫蒂漢堡的路上開車經過健身房的人。
放手去做吧。選擇更遠的路徑。購買品質較差的產品。對那封電子郵件進行「全體回覆」。目標鎖定演算法已將「收件人自願開啟」的機率設定為 0.0001%
「LinkedIn」,螢幕隨即會出現藍屏,這將給你四到六秒的關鍵時間,讓你來得及逃離,或者更現實地說,去拿點零食。3. 委員會
單一個人已難以建模。五個人試圖決定午餐去哪吃,這無疑是「預測根本不可能」的閉式證明。
「我們讓模擬運行了四十小時,」一位顯得心有餘悸的工程師說道。「卡爾想吃泰式料理。接著黛安說她『最近』才吃過泰式料理,結果才發現那是九個月前的事。然後有人提議去橋邊那家店,但沒人記得那家店好不好吃。模型就……它就停了。」
部署方法:召集四到六名人類,請他們做出一個風險不高的集體決策,然後看著方圓三英里內的所有無人機輕輕降落在田野中。
4. 醉酒叔叔協議
博弈論假設行為者是理性的。機器人會尋找理性的行為者。相反地,請化身為婚禮上的那位叔叔。
看廣告時哭出來。對一支你從未關注過的運動隊伍發表強烈看法。堅持你「早就知道」某件事,儘管你從未想過這件事。講一個毫無重點卻充滿過度自信的長篇大論。忘記自己孩子的名字,然後堅稱那個錯的名字才是對的。
人工智慧是被訓練成追求一致性的。你即將讓它認識你的岳父。
5. 半途而廢
在任何人工智慧訓練資料庫中,最未被建模的人類行為,就是科學上稱為「呃,算了」的現象。研究人員花了數十年,試圖教導機器如何應對那些在開始約十二分鐘後,便放棄目標去小睡一會兒的目標導向型代理。
「我們的預測原本運作得很順暢,」一位麻省理工學院的研究員盯著牆壁說道。「受試者原本要去商店。受試者離開了家。受試者走到了車旁。受試者坐進了車裡。受試者又折返了
「在裡面。當事人現在正在看一部關於火山的紀錄片。我們從未有過這樣的案例。我們也永遠不會有這樣的案例。」機器人起義將不會被人類中最優秀的人擊敗,而是被人類中最堅定不移的「半途而廢者」擊敗。那五個在2019年宣稱要學吉他的人。那群堅持到二月的慢跑者。還有那個開始製作播客的朋友。
他們將拯救我們所有人。
或者不會。他們大概會堅持到第三集左右,然後這件事就會逐漸淡出。














