
Rhoda AI、ロボットカメラを遮断し、「タッチだけで機能する」ことを実証
パロアルトのスタートアップ企業「Rhoda AI」は、カメラが遮られた状態でも、新しい触覚センサーと拡張された「Direct Video-Action」モデルを活用し、触覚のみに基づいてテクスチャの異なるボールを探し出し、回収するロボットのデモを披露した。

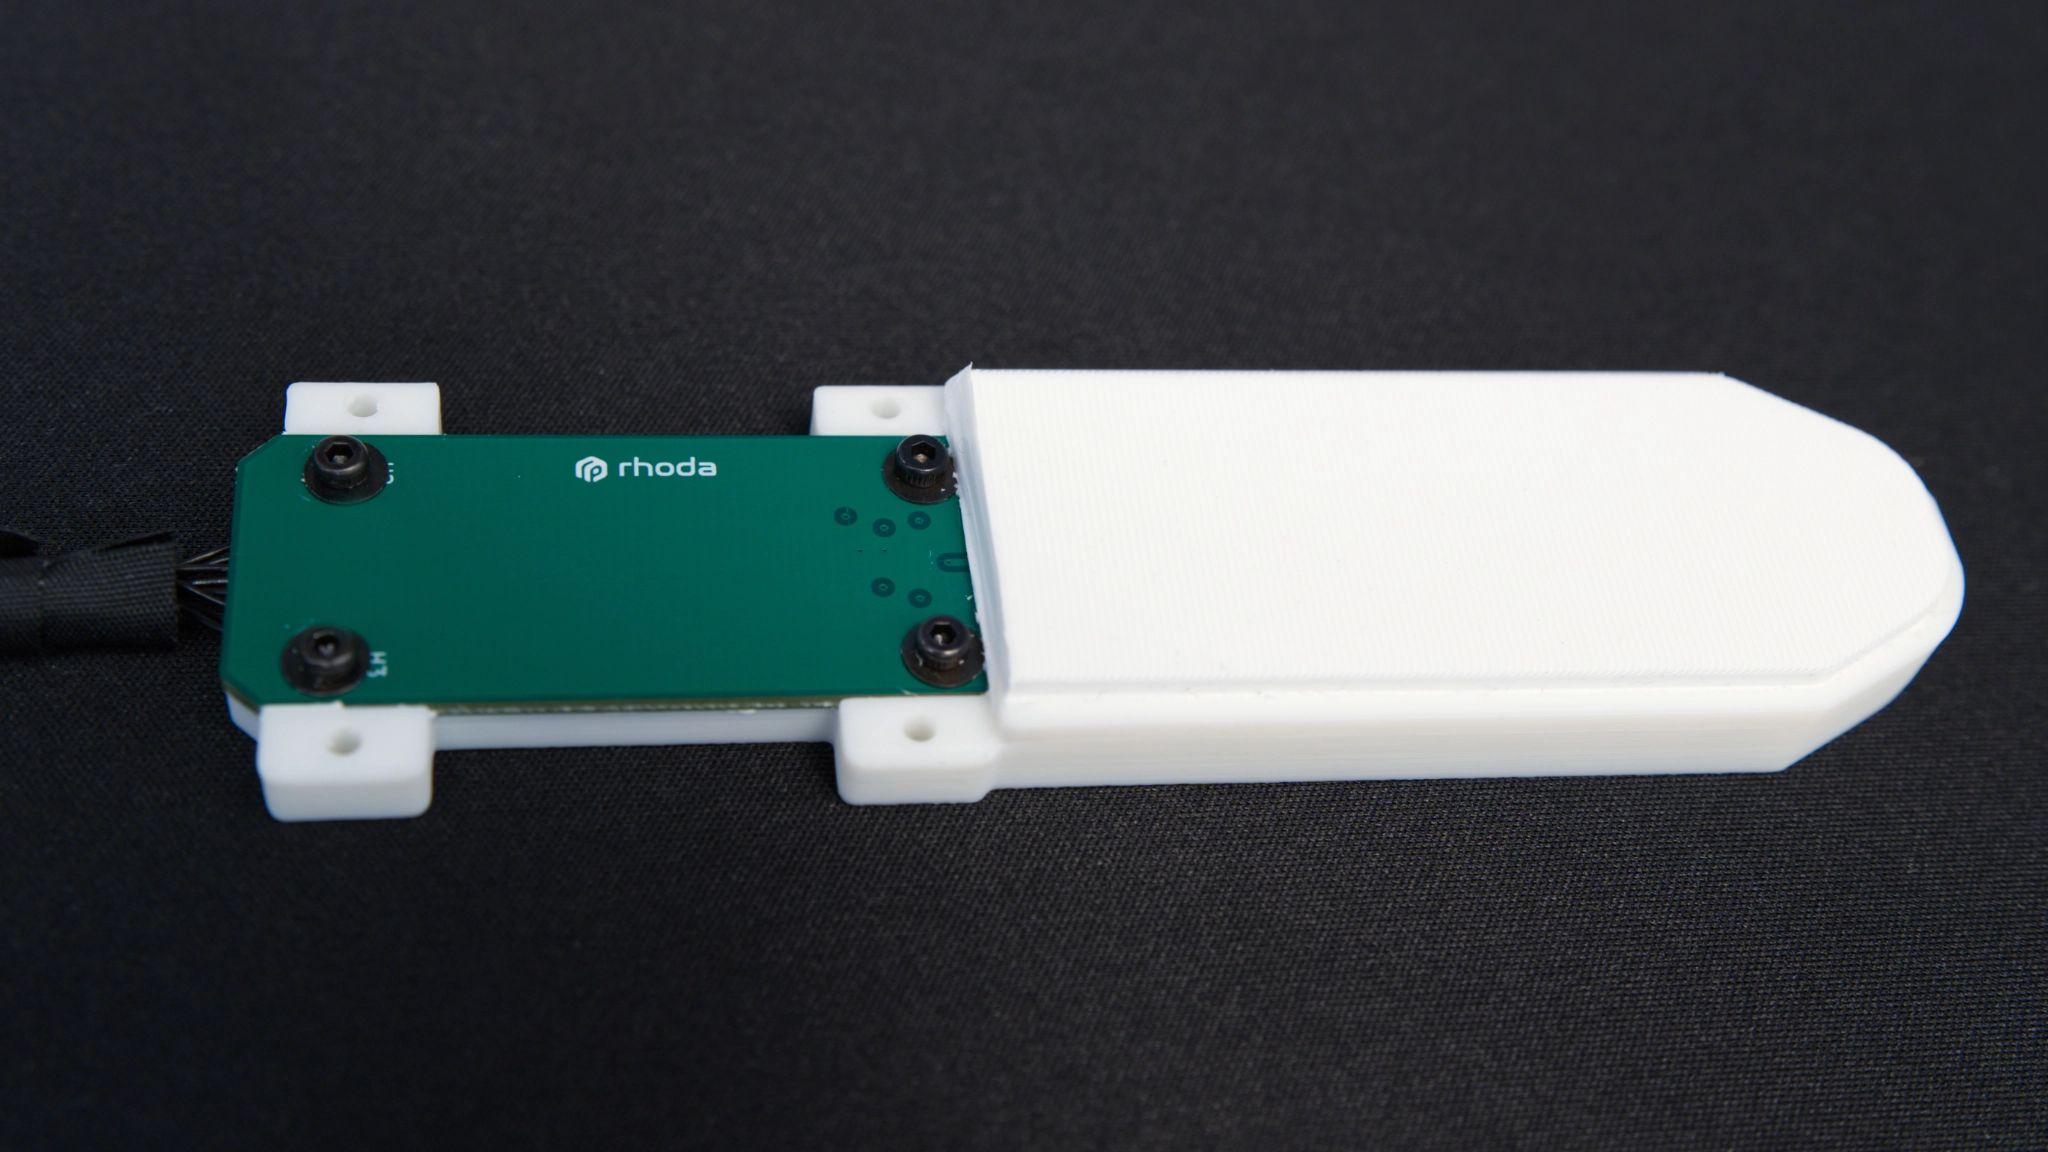
同じ指先で、わずか数ミリニュートンという微小な力から40ニュートンを超える大きな力までを検知できるセンサーがあったからこそ、Rhoda AIはロボットのカメラを意図的にオフにした状態で最新のデモンストレーションを実施することができたのです。 触覚センシングおよび操作モデルを開発する、カリフォルニア州パロアルトを拠点とするロボットスタートアップのRhoda AIは、2026年10月13日に技術報告書を発表し、タスク全体を通じて頭部と手首のカメラを遮断した状態で、ロボットが触覚のみを用いてビンの中から凹凸のあるボールを見つけ出し、識別し、取り出す様子を示した。
Rhodaのコア技術は、同社の「Direct Video-Action」モデルの拡張版と組み合わせた新しい触覚センサーである。このシステムはもともと、視覚入力をロボットの動作に直接マッピングするために構築されたものだが、現在は将来の画像ではなく、将来の触覚信号を予測するように適応されている。 逆動力学モデルが、これらの触覚予測を実際のロボットの動きに変換し、新たなセンサーの測定値が次の動作を導く予測を継続的に更新することで、視覚ではなく触覚が探索を駆動する閉ループが形成される。
「目隠し」実験が実際に証明したこと
「目隠し」という設定は単なるギミックではなく、視覚が触覚モデルの不備を密かに補うことなく、触覚システムが単独で何ができるかを特定するために意図的に施された制限である。 今日のほとんどのロボット操作システムは、物体の位置特定において視覚に大きく依存しており、触覚は二次的な信号としてのみ使用され、カメラが物体の大まかな位置を特定した後に、把持を微調整する役割しか果たしていません。 Rhodaのデモでは、探索・回収段階において視覚をループから完全に排除し、触覚モデルに、通常はカメラベースのシステムが処理する作業――箱の中で手触りだけで物体を特定し、質感のみに基づいて発見した物体を分類し、それを取り出すか、それとも探索を続けるかを決定する――を強制的に行わせている。
これは、触覚を補助とした把持よりも、はるかに難易度の高い課題である。カメラを搭載したロボットが箱の中を探索する場合、作業空間全体を
一度だけ。目隠しをされたロボットは、触覚に頼り、一連の接触――一度に一つの探触器ずつ――を通じて、箱の中身を理解していかなければならない。その際、頼りになる恒常的な全体像は存在しない。ローダのセンサーの測定範囲は、数ミリニュートンから 表面を乱すことなくその質感をとらえるのに十分な感度から、しっかりと把持したりダンベル並みの荷重を感じ取ったりするのに十分な40ニュートン以上まで、この幅広い範囲こそが、そのようなきめ細かな接触主導型の探索が機能するためのハードウェア上の前提条件となっている。デモの「正直な部分」
ローダは、洗練され、エラーのないハイライト映像を公開しなかったが、その選択自体が、業界全体の触覚センシングに関する主張を評価する購入者にとって有益な情報となっている。公開された動画には、ロボットが時折間違ったボールを選択し、修正する前に再スキャンを余儀なくされる場面が含まれており、そうした瞬間がカットされていない。 新興のマニピュレーション技術を評価する調達チームは、こうした公開された失敗事例を、完璧なデモ映像よりも有用なシグナルとして捉えるべきである。なぜなら、それは厳選された成功例ではなく、システムの実際のエラー回復動作を示しているからである。 また、動画の一部は6倍や12倍に早送りされており、購入者はこれをリアルタイムのタスク処理速度に関する主張ではなく、視聴しやすさを重視したプレゼンテーション上の選択として捉えるべきです。Rhoda社は、基礎となるリアルタイムでの完了時間を公表していません。
Rhodaが開示した定量的結果は限定的ではあるが具体的だ。このモデルは、滑らかなボール1個と凹凸のあるボール1個の計2個で学習され、学習中に遭遇したことのない凹凸のあるボール2個を含む計7個のボールでテストされた。 同社によると、テストにおいてロボットは、学習済みの1個と未知の2個を含む、3個の凹凸のあるボールをすべて回収することに成功したとのことですが、Rhoda社は7個のテストボール全体における総合的な成功率や、各テストで何回試行が行われたかについては公表していません。これは重要な制限事項です。小規模かつ特定の結果(凹凸のあるボール3個中3個成功)は、
この概念は限定的なケースでは機能しますが、実際の倉庫や組立現場で必要とされるような、より幅広い物体の形状、材質、またはビン配置にわたって、統計的に信頼できる成功率を確立するには至っていません。なぜ触覚センシングがロボット操作においてより困難な側面なのか
ビジョンベースのロボット知覚は、ここ数年で急速に進歩した。その主な理由は、カメラが安価で、その仕組みがよく理解されており、画像認識全般に革命をもたらしたのと同じディープラーニング技術の恩恵を受けているからだ。 一方、触覚センシングは、より実用的な技術的理由から遅れをとってきた。耐久性があり高解像度の力センサーを低コストで製造するのは困難であり、信号自体はノイズが多く、カメラの広い視野角に比べて局所的である。また、ビジョンモデル用に利用可能な膨大な画像データセットに比べ、触覚に関する標準化されたトレーニングデータは歴史的に少なかった。 Rhoda社が賭けているのは、このギャップを埋めることが、視覚だけでは確実に成功できないタスク――コンテナ内の遮蔽された物体の取り扱い、低照度や粉塵で視界が遮られた環境での作業、あるいは布や緩んだケーブルなど、視覚的な外観だけでは接触時の挙動を確実に予測できない素材の操作――において、格段に重要になるという点だ。
ロボットベンダーの操作能力を評価する購入担当者にとって、触覚センシングに関する主張は、これまで独自に検証するのが最も困難なもののひとつであった。その理由は、ほとんどの企業が触覚を独立した機能としてではなく、視覚の上に重ねられた二次的な補助機能としてデモを行っているためである。 今回のデモンストレーションにおいて、Rhoda社が視覚機能を完全に排除するという決断を下したことで、調達チームは、より限定的ではあるものの、より明確な評価基準を得ることができた。すなわち、視覚的な補助を一切用いず、触覚モデルのみを用いて、基本的な探索・回収タスクを実行できるかどうかである。 これまでに公開された限られた証拠に基づけば、その答えは、制御されたビン内の単純で剛性があり、表面に凹凸のある物体については「条件付きで可能」である。しかし、それが他の状況にも一般化できるかという、より大きな疑問が残る。
現実世界における、より複雑な操作課題は依然として未解決のままである。触覚センシング分野の競合他社の中で、Rhodaのアプローチが占める位置
ロボットの触覚性能向上を目指すのはRhodaだけではない。過去1年間で、ヒューマノイドや操作に特化した複数のロボット企業が独自の触覚センサーに関する研究成果を発表しているが、それらは概して、触覚を独立した知覚チャネルとしてではなく、既存の視覚ベースの把持を精度を高めるための補完的な要素として位置づけている。 Rhodaのデモンストレーションが他と一線を画す点は、最終的な把持だけでなく、探索タスク全体において、明示的かつ意図的に視覚情報をループから排除していることです。これは、競合する多くの触覚センサーに関する発表よりも大胆な主張であり、外部の観察者が検証しやすい主張でもあります。 というのも、公開された動画ではカメラ映像が遮られている様子が視覚的に明確かつ明白に確認できるのに対し、より広範な視覚駆動型パイプラインの中に埋もれたタッチ支援レイヤーの場合、触覚が実際にどれほどの役割を果たしているかを判断するのは困難だからだ。
この検証可能性は、評判の面ではRhodaにとって有利に働くが、同時に同社が自らに課したハードルも引き上げることになる。カメラを使わず、触覚のみを用いたシステムが、制御された環境下で箱の中を検索し、3つの異なる質感を持つボールを3つすべて識別できることを実証した以上、Rhodaには今後、より混沌とした条件下でも同じアプローチが機能することを示すことが求められるだろう。 より多くの物体種別、識別が困難な質感、複数のアイテムが重なり合った雑然とした箱、そして単なる実例ではなく統計的に有意な結果となる十分なサンプルサイズに基づく成功率の開示などだ。触覚センシング分野の競合他社や、ベンダーを比較検討する購入者は、タッチのみによる操作を商用化可能なものとみなす前に、当然ながらこうした次の段階の証拠を求めるだろう。
視覚に依存しない触覚技術の商業的価値
カメラに依存しない触覚システムの実用的な価値は、ロボットの知能とは無関係な理由で視覚がすでに機能しづらい環境において最も明確になります。例えば、
倉庫の棚に3段まで積み上げられ、上から撮影するカメラでは下にあるものが見えない場合、ほこりや蒸気で満たされた産業現場でレンズが曇ったり膜が張ったりする場合、あるいはメンテナンス作業中の機械筐体内部のような暗く閉ざされた空間などです。 こうした各ケースにおいて、触覚のみに頼って物体の位置を特定し、識別し、取り出すことができるロボットは、純粋に視覚ベースのシステムでは到底及ばない運用上の優位性を持っています。なぜなら、物理的な環境そのものが、カメラの品質にかかわらず、視覚に必要な情報を遮断しているからです。こうした特定の失敗モードを念頭に置いて、新興のマニピュレーションベンダーを評価している調達チームにとって、Rhodaのデモンストレーションは、現在の触覚ハードウェアを用いてカメラに依存しない動作が機械的に可能であることを示す有用な初期の兆候である。ただし、Rhodaを含め、どのベンダーも、そうした過酷な環境向けに実用可能な製品をすでに保有しているという証拠にはならない。 実験室にある凹凸のあるボールが入ったビンと、実際に視界が遮られ、物が散乱している産業用ビンとの間には大きな隔たりがあり、その隔たりを埋めるには、ローダがまだ公表していないような、より大規模で統計的に信頼性の高いテストが必要となる。
評価を変える要素
この発表で覚えておくべき数値は、数ミリニュートンから40ニュートン以上までのセンサーの測定範囲と、約500 Hzでの振動サンプリングである。なぜなら、これこそが「目隠し状態での物体検索」をそもそも可能にする具体的なハードウェア仕様であり、 また、競合他社が開発する触覚センサーの性能を評価する際の基準となる数値でもある。ローダ社が、より多様な物体セットを対象とした大規模な成功率を公表するまでは、購入者はこの実証実験を、触覚のみによる物体の検索・識別に関する信頼できる概念実証として捉えるべきであり、商用操作環境において触覚センシングだけで視覚に取って代わる準備が整っているという証拠として捉えるべきではない。
本記事は、Rhoda AIが2026年10月13日に公開した技術研究記事と、Humanoids Dailyが2026年10月15日に報じた
「目隠しロボット」の実演(記載された公開日時点)。本記事は一般的な情報提供のみを目的としており、投資、調達、法律、または技術に関する助言を構成するものではありません。数値は、記載された情報の締め切り時点における上記の出典を反映したものであり、予告なく変更される場合があります。













