
アント・グループのLingboは、LingBot-Depth 2.0と、空間ネイティブのエンボディッド・ビジョン基盤モデルであるLingBot-Visionをオープンソース化した。
アント・グループ傘下のLingbo Technologyは、「LingBot-Depth 2.0」を発表するとともに、境界構造を事前学習の主要なシグナルとする基盤モデル「LingBot-Vision」をオープンソース化した。
2026年7月7日、アント・グループ傘下の体現型AI子会社であるLingbo Technologyは、ロボットの知覚に関する2つの主要な構成要素を公開し、開発者向けに開放した。 1億5000万規模の深度データセットで学習された新しい空間知覚モデル「LingBot-Depth 2.0」は、現在、業界の深度補完ベンチマーク16種のうち12種でトップの成績を収めている。深度情報が大幅に欠落している最も難易度の高い屋内テストにおいて、そのRMSEは0.132から0.062へと低下した。 同社はまた、境界構造を第一級の事前学習目標として扱う基盤モデル「LingBot-Vision」をオープンソース化した。開発チームはこれを「空間ネイティブ」と呼んでおり、NYU-Depth v2への転移学習において、70億パラメータのDINOv3ベースラインを含む、最大7倍規模のモデルと同等かそれ以上の性能を発揮している。 0.3億パラメータのディスティルド・スチューデントモデルは、DINOv3スタイルのレシピの約10分の1の規模である1億6000万枚の画像を用いた事前学習コーパスを使用し、パラメータ数を約23分の1に抑えつつ、70億パラメータの参照モデルと同等の性能を維持している。
発表内容
Lingboが7月7日に発表した一連の成果には、具現化された環境で連携して動作するように設計された2つの独立したコンポーネントが含まれています。
・ LingBot-Depth 2.0は、実運用を志向した深度補完・推定モデルです。1億5,000万サンプルの規模で学習されており、屋内環境や、従来のセンサーを混乱させるような困難な素材において、新たな成果を挙げています。ガラスパネル、鏡、その他の透明または反射性のある表面の処理に特に強みを発揮します。
・ LingBot-Visionは、ViTバックボーン上に構築された自己教師付きビジョン基盤モデルであり、モデルに境界構造の復元を強制する事前学習タスクが組み込まれています。同社はこれを「空間ネイティブ事前学習」と位置付けています。これは、幾何学的構造を暗黙的に現れるままに任せるのではなく、トランスフォーマーに明示的な空間的目標を与えるためです。
両プロジェクトともコミュニティ向けに公開されている。LingBot-Vision
重みデータは4つのサイズが用意されており、おおむねViT-G、ViT-L、ViT-B、ViT-Sの各ティアに対応しています。コードはGitHubに、モデルカードはHugging Faceに掲載されています。技術報告書はarXivに2607.05247として掲載されています。境界構造を目的関数として設定することの重要性
自己教師付き視覚事前学習の多くは、特徴の形成に画像再構成、不変性、あるいはティーチャー・スチューデント蒸留を利用しています。これらのアプローチは強力な汎用記述子を生成してきましたが、学習された特徴が、表面や物体のエッジと一致する明確な空間的不連続性を確実に符号化しているとは限りません。 ロボットの知覚スタックでは、特に深度センサーが機能しない場合や、ロボットが部分的な観測情報の下で計画を立てなければならない場合、ナビゲーション、把持計画、シーン理解をサポートするために、まさにその情報が必要となることがよくあります。
LingBot-Visionは、境界を学習目標として位置づけています。研究チームは、「境界強制(boundary forcing)」とも呼ばれる「マスクされた境界モデリング」について説明しています。この手法では、モデルは文脈から意図的に隠された境界の手がかりを予測しなければなりません。このタスクを通じて、モデルは輪郭の連続性、深度の不連続性、およびオクルージョンの幾何学的構造に対してより敏感になります。 この帰納的なシグナルにより、深度推定や深度補完への下流への転移が簡素化される。また、空間的推論が重視されるタスクにおいて、ゼロショットまたはローショットでの性能も向上する。これは、バックボーンが、エッジがシーンの3D構造に関する最も有用な情報を担っている数百万もの事例を学習しているためである。
ロボット工学においてこの手法が好まれるのには、実用的な理由がある。ロボットは、能動型深度センサーを無効化してしまう反射面や透明面の中で動作する。ガラス窓、アクリル製のガード、研磨された金属などは、飛行時間法(ToF)や構造化光カメラに無効な測定値やノイズの多い測定値を出力させることがある。 境界を検出し、単眼の手がかりから幾何学的構造を推論するように調整されたビジョンモデルは、こうした障害モードを軽減できる。まさにこの点において、LingBot-Depth 2.0は、基盤モデルの特徴を最大限に活用するように設計されている。
根拠
ベンチマークとデータ効率についてLingboの報告によると、LingBot-Visionは、約10億パラメータのViT構成を中核とし、より小規模なディスティルド・スチューデントを組み合わせた構成となっている。NYU-Depth v2の深度推定転移学習において、メインモデルは、内部比較において7BのDINOv3リファレンスを含む、はるかに大規模なティーチャー型ベースラインの性能に匹敵するか、それを上回っている。 0.3Bのディスティルド・スチューデントは、サイズがわずか数分の1でありながら、パラメータ数が約23分の1であるにもかかわらず、7Bの結果と同等の性能を発揮すると報告されている。 事前学習用コーパスは1億6,000万枚の画像であり、これは同種の自己教師付き学習パイプラインで一般的に使用されるデータセットよりも1桁小さい規模です。多くのロボット工学チームには、1,000億サンプル規模の学習を実行するための予算や時間がないため、この効率性は運用上の重要な利点となります。
深度学習の分野では、LingBot-Depth 2.0が注目すべき成果を挙げています。 同社のテストマトリックスにおいて、公開追跡されている16の深度補完ベンチマークのうち、12で本モデルが首位を占めています。最も注目すべき数値は、広範囲の欠損領域がある最も困難な屋内シナリオにおいて、RMSEが0.132から0.062へと半減した点です。 ガラス、鏡、透明な物体についても改善例として挙げられており、これらは倉庫、小売、サービス環境における現実世界の運用上の課題に対応しています。これらの主張はOrbbecの深度ビジョン研究所によって認証されており、LingBotの内部検証に加えて第三者による測定結果が裏付けとなっています。
コミュニティ全体での独立した再現には時間がかかるものの、結果の傾向は、明示的な境界監督によって従来のエッジケースを克服できるという考えと一致している。特徴量を表面の境目に偏らせることで、モデルは直接的な深度測定値が得られない場合でも、形状やレイアウトを推論することができる。
LingBot-Visionと既存モデルの比較
エンボディッドビジョンは単一のタスクではなく、あらゆる下流の要件に適合する単一の事前学習目標は存在しません。とはいえ、いくつかのデフォルト設定が一般的になってきています。DINOスタイルの自己教師付きViTは依然として
表現学習のための強力な基盤。Metaの「Segment Anything Model」は、セグメンテーションワークフローにおいて圧倒的な性能を発揮し、下流タスク向けのプロンプト対応マスクを提供するが、深度推定を目的として設計されたものではない。従来のマスク付きオートエンコーダーは再構成能力を備えているが、幾何学的タスクで競争力を発揮するには、多くの場合、大幅な適応が必要となる。Lingboの貢献は、空間的な不連続性に対する単純かつ明示的なバイアスを追加し、この1つの変更だけで、10億枚の画像を用いた事前学習を実行することなく、強力な深度転移が得られることを示した点にある。 NYU-Depth v2において、7BのDINOv3リファレンスモデルと同等の性能を達成した0.3Bのディスティルド・スチューデントモデルは、この考え方を最も明確に体現している。これは、幾何学処理に必要なシグナルの多くが、グローバル不変性やティーチャーマッチングスコアだけでなく、境界線にも存在することを示唆している。
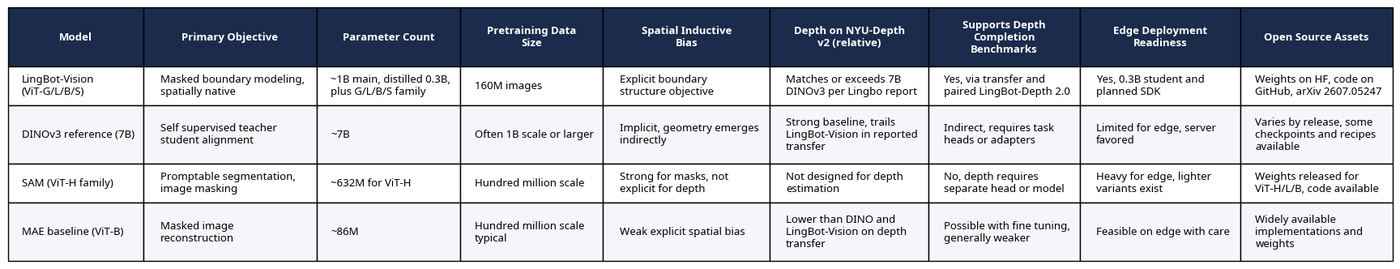
エンボディッドビジョンと深度知覚モデルの並列比較
以下は、エンボディッドビジョン研究における知覚バックボーンの一般的な選択肢を簡潔に比較したものです。ここでは、事前学習の目的、パラメータ規模、空間的バイアス、および深度タスクやエッジ展開への適性に焦点を当てています。
OrbbecおよびエッジSDKを用いた製品化
オープンソース化は物語の半分に過ぎません。LingboはOrbbecと連携して、実運用に向けた取り組みも開始しました。同社によると、Orbbecの深度ビジョンラボが主要な結果を認定したとのことです。両社は、Gemini 330シリーズの深度カメラ上でLingBot-Depthを最適化するために協力しています。 また、現場でのデータセットの拡張と評価を容易にするため、EGO RGB Dデータ収集デバイスへの適応も計画されている。Lingboはさらに、クラウドとの信頼性の高い接続を維持できないモバイルロボットにとって重要な、エッジ利用に特化したSDKのプレビューも公開した。ロードマップには、年末までにLingBot-Depthの商用ビルドを同梱した統合カメラ製品の提供が含まれている。
この提携の構図からは、製品開発が2つの層に分かれていることがうかがえます。第一に、ソフトウェアのチューニングとモデルの
Orbbecのハードウェア上の制約に対応するための変換。第二に、すぐに取り付けて使える知覚モジュールを求める顧客向けの垂直統合型オプションであり、これにより小規模なロボット開発チームの統合時間を短縮できます。注目すべき設計上の選択
Lingbo氏が説明した設計上の決定事項のうち、実務者にとって注目すべき点がいくつかあります。
・ 境界優先の目標。マスク付き境界モデリングは、モデルがデフォルトで学習する内容を変化させます。これにより、純粋な再構成や不変性に基づく表現を回避し、エッジを第一級の信号として扱います。
・ パラメータ効率に優れた学習モデル。0.3Bの蒸留モデルは単なる「おもちゃ」ではありません。深度転移において7BのDINOv3リファレンスモデルと同等の性能を発揮すれば、サーバークラスのハードウェアを持たないロボットでも、高性能な知覚処理を実行できる範囲が広がります。
・ 中規模の事前学習コーパス。1億6000万枚の画像コーパスは依然として大規模ですが、10億枚規模のコーパスを実行するよりも、資金力のある研究室にとって現実的な上限に近いものです。これにより、再現性とさらなる研究への道が開かれます。
· 深度補完との整合性。基盤モデルとDepth 2.0の密接な連携は、ガラスや鏡に関する結果に表れている。この組み合わせは、基盤モデルが、その帰納的バイアスを継承する特定のタスクと整合した際に成果をもたらすことを改めて示している。
限界はどこにあるのか
リリースノートでは、屋内シーンや、センサーベースの深度推定がしばしば誤処理しがちな素材に対する強みが指摘されている。未解決の課題も残っている。
· 屋外環境への汎化。強い日差し、天候、長距離のシーンは、単眼推論とアクティブ
深度センサー。本報告書は、屋内および屋内と同様の環境に焦点を当てている。屋外での実証データがあれば有用だろう。・ マルチカメラ融合。多くのロボットは、ステレオカメラ、RGB-Dカメラ、イベントカメラを組み合わせて使用している。LingBot-Visionの機能が、こうした融合パイプラインにおいてどのような性能を発揮するかは、検討に値する。
· 動きと時間的連続性。境界の目的関数は画像レベルで定義されている。時間的なエッジや動きの境界を明示的にモデル化することで、SLAMや動的障害物追跡といったタスクにおいて、さらなる性能向上が期待できる可能性がある。
・ ラベルフリーの整合性。自己教師付き学習法は、データセットのバイアスを引き継ぐ可能性がある。境界に重点を置いた事前学習は、幾何学的意味を持たないテクスチャやアートワークのエッジを過度に強調してしまう恐れがある。多様なドメインにおける慎重な評価が必要である。
これらの注意点のいずれも、深度補完に関して報告された進歩の重要性を損なうものではない。これらは、研究コミュニティが今後実施するであろう次の実験の方向性を示唆している。
これが、身体を持つAIやロボットの購入者にとって意味すること
倉庫、小売店、病院、ホスピタリティ業界で移動型ロボットを開発しているチームにとって、脆弱な知覚能力は絶え間ないダウンタイムの原因となっている。ガラス扉を誤認識したり、鏡を正しく判別できなかったりするロボットは、良くて動作が停止し、最悪の場合は損害を引き起こす可能性がある。基盤モデルと調整済みの深度ヘッドの組み合わせによってこうした事故が減少するのであれば、それは調達レベルの意思決定事項となるだろう。
・ センサーの交換が減少する。透明や反射性の素材は、しばしば高価なハードウェアによる回避策を必要とする。こうした課題を解消するソフトウェアがあれば、購入者は標準的なカメラや深度モジュールをそのまま使用し続けることができる。
·
エッジでの実用性。競争力を維持できる0.3Bモデルであれば、組み込みGPUやミッドティアのコンピューティングモジュールでの実行も現実的になります。これにより、モバイルプラットフォームにおける熱やバッテリーの制約が緩和されます。・ データの活用。モデルが1億6000万枚の画像で強力な空間表現を実現できれば、追加のデータ収集の拡大は、単なるデータ量の増加ではなく、エッジケースやドメインの網羅性の問題となる。
・ ベンダーのエコシステム。Orbbecとの統合およびSDKにより、統合の障壁を低減できます。統合されたカメラ製品が予定通りに登場すれば、システムインテグレーターにはすぐに利用できるアップグレードパスが提供されます。
オープンソースの詳細と始め方
Lingboは、ViT-GからViT-Sスタイルの処理能力に対応する4つのサイズについて、LingBot-Visionのコードとチェックポイントを公開しています。
· Hugging Face: robbyant/lingbot-vision
· GitHub: robbyant/lingbot-vision
· 技術報告書: arXiv 2607.05247
早期導入者は、まずBまたはSサイズから始めて、対象ハードウェアでのスループットとメモリ使用量をテストし、アプリケーションの要件が許せば、その後LまたはGサイズに移行することができます。 深度補完に関しては、LingBot-Depth 2.0がロボット工学タスク向けの主要なヘッドとして位置付けられています。同社は1億5000万件の深度コーパス用のトレーニングコードをまだ公開していませんが、評価マトリックスについては説明しており、エッジデバイスへの展開を容易にするためのSDKをリリースする予定です。
LingBotリリースの経緯
Lingboは2026年に急速なイテレーションを重ねてきました。1月27日にDepth 1.0がリリースされ、続いて1月29日にLingBot-Worldがリリースされ、
4月27日の「World-Fast」、続いて4月16日の「LingBot-Map」。本日のパッケージは、深層構造を強化し、基盤モデルと幾何学的ヘッド間の連携を緊密化することで、これらを結びつけています。このペースはまた、具現化されたAIには、単に大規模な汎用ビジョンモデルだけでなく、空間に偏重した事前学習が必要であるという戦略的な賭けを示唆しています。独自のスタックで主張を評価する方法
· 最も困難な表面でテストを行う。ロボットが鏡や半透明のガードに苦戦する場合は、自社のデータを用いて同社のシナリオを再現する。
· レイテンシと熱予算を測定する。0.3Bのディスティルド・スチューデントはエッジ向けに設計されているが、ワークロードの組み合わせによってはメモリ使用量や発熱が急増する可能性がある。自社のナビゲーションスタックを用いてエンドツーエンドでプロファイリングを行う。
· ロングテールの汎化性能を確認する。トレーニングセットとは異なる場所や照明パターンをテスト対象から除外して評価を行う。
· センサフュージョンの計画を立ててください。ステレオカメラやLiDARを使用する場合は、境界特徴量がフュージョンの安定性を向上させるかどうかを評価してください。
プロセスを透明化することで、購入者はその利点が自社の運用においても発揮されるかどうかを判断できるようになります。
今後の展望
境界目的関数がこのレベルの有効性を引き続き示すならば、それはエンボディッドモデルの事前学習における標準的な構成要素となる可能性があります。 最も短期的な効果としては、ガラスや鏡が多い環境下での屋内ナビゲーションおよびマニピュレーションの精度向上が挙げられるでしょう。年末までに、LingBot-Depthの商用ビルドを搭載したOrbbec製統合カメラが、市場に即戦力となる実証例を提供する見込みです。もしその製品が性能と価格の目標を達成すれば、研究機関やベンダーの間で、同様の境界目標を模倣したものが次々と登場するものと予想されます。
現時点では、オープンソース化により、
このアプローチを試す上での障壁となります。これにより、スタートアップや研究機関は、数十億サンプル規模のトレーニングを実行することなく、より強力な深層転移を実現するための具体的な道筋を得ることができます。これは、単に大規模なモデルだけでなく、より実践的な成果を必要としているエコシステムにとって朗報です。出典
· QbitAI
· GitHub: robbyant/lingbot-vision
· Hugging Face: robbyant/lingbot-vision











