
AGIBOTの「WITA-Omni」がステージ上で即興の会話を行う
AGIBOTは、リアルタイムの対話タイミングに合わせて構築された具現化AIモデル「WITA-Omni」を実演し、マカオでヒューマノイドロボットがテレビ司会者と台本なしのライブ対話を交わす様子を披露した。これは、対話型ロボットがサービス現場での運用に耐えられるかどうかを検証するためのテストであった。

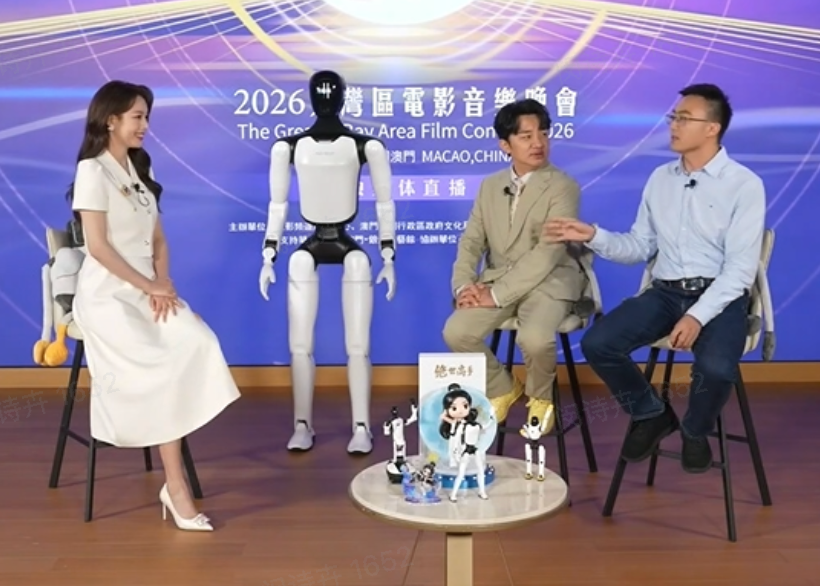
9月21日(月)にマカオで行われたテレビ中継のコンサートで、上海のAGIBOT社が開発したヒューマノイドロボットが、中国のタレントの向かいに座り、単に彼女と会話を交わした。その会話は、あらかじめプログラムされた決まり文句を機械的に繰り返すのではなく、リハーサルなしの生放送ならではの自然な流れに沿って行われた。 ロボットは誰が話しているかを把握し、自然に返答できるタイミングを待ち、会話のリズムに合わせて発話、ジェスチャー、姿勢をリアルタイムで調整していた。 「グレーターベイエリア・フィルム・コンサート」で行われたこのデモンストレーションは、AGIBOTが「WITA-Omni」を初めて大勢の観客の前で披露したものであった。WITA-Omniは、個別のコマンドに反応するのではなく、台本のない人間とのやり取りにロボットが追随し、参加できるように特別に構築された、身体性を備えたネイティブAIモデルである。
AGIBOT(正式名称:AGIBOT Innovation (Shanghai) Technology Co., Ltd.、中国では「智源ロボティクス」としても知られる)は、元ファーウェイのエンジニアである鄧泰華氏と彭志慧氏によって2023年2月に設立され、以来、中国のヒューマノイドロボット分野において、最も多額の資金調達を受けた新興企業の一つとなっている。2026年6月には生産ラインから15,000台目のロボットが完成したと報告し、同年7月には香港でのIPO手続きを開始した。 同社の製品ラインナップは、AシリーズおよびXシリーズのヒューマノイド、Gシリーズの汎用ロボット、Dシリーズの四足歩行ロボット、そして業務用清掃プラットフォームに及び、AGIBOTが「WITA-Omni」モデルを単一のステージでのデモにとどまらず展開することを選択した場合、同モデルを稼働させるための幅広いハードウェア環境が整っている。
マルチモーダル知覚をリアルタイムのやり取りへ
現在、ロボット工学や民生用デバイスに搭載されているマルチモーダルAIシステムの多くは、テキスト、画像、音声の入力を組み合わせて処理し、回答を返すように設計されている。 しかし、人であふれる部屋でリアルタイムの会話を交わす場合、システムは誰が話しているのか、数秒前に何が言われたのか、ジェスチャーや発言が誰に向けられたものなのか、そしてその瞬間に応答が必要かどうかまで判断しなければならないため、これは根本的に異なる課題である。WITA-Omniは、この課題を解決するために構築されている。
2つ目の課題。このモデルは、視覚、音声、言語、タイミングの各信号を単一のフレームワークに統合しているため、各入力を個別のクエリとして扱うのではなく、相互作用が展開していく様子を追跡することができます。AGIBOT社はこの主張を裏付けるベンチマーク結果を公表しており、 サードパーティの「DailyOmni」視聴覚推論ベンチマークにおいて、「WITA-Omni」のプレビュー版は平均精度85.21%を記録し、総合1位を獲得するとともに、他AI研究所の汎用マルチモーダルシステムを相手に、8つの評価カテゴリーのうち6つでトップの成績を収めた。このスコアを支えるアーキテクチャは、AGIBOTが「Thinker-Talker-Actor」と呼ぶもので、一部の対話型AIシステムで使用されている「Thinker-Talker」構造を拡張し、身体表現(エンボディメント)のために特別に構築された第3のコンポーネントを追加したものです。 「Thinker」モジュールは、シーンで何が起こっているかを解釈し、ロボットがどのように応答すべきかを大まかに決定します。「Talker」は実際の音声を生成し、「Actor」はロボットの身体の動きや顔・体の表情を制御します。 これら3つの機能を別々の連続したステップとして実行するのではなく、パイプラインはそれらを同一のタイムライン上に整合させる。これにより、ロボットのジェスチャー、表情、声は、後から3つの切り離された出力を継ぎ接ぎするように表示されるのではなく、話す際に一体となって変化する。 AGIBOTは、実際の人間とのやり取りから収集した大規模なマルチモーダルデータを用いてモデルを学習させ、発話、動作、表情の間のタイミング関係を維持しました。これにより、システムは「何を言うか」だけでなく、「いつ言うか」、そして「その瞬間を身体的にどう表現するか」も学習できるようになりました。
台本なしのデモが、振り付けされたデモとは一線を画す理由
今年、中国の活況を呈するエンボディッドAI分野において、見本市や製品発表会でのヒューマノイドロボットのデモンストレーションは日常的なものとなりましたが、その圧倒的多数は振り付けされたものです。つまり、ロボットは決まった経路を歩き、決められたジェスチャーを行い、合図に合わせてあらかじめ書かれた台詞を話すというものです。この形式は、ロボットが一連の動作を確実に実行できることを証明するものであり、これは
製造や物流の業務には活用されているが、部屋いっぱいの人が台本通りに動いていない状況で、ロボットがどのように振る舞うかについてはほとんど語られていない。 マカオでのデモンストレーションは、その正反対の状況を検証するために企画された。著名なゲストは、ロボットが反応するようにあらかじめ書かれた台詞を朗読していたわけではない。ロボットは、彼女が自分に話しかけているタイミングを識別し、会話の途切れが「中断」ではなく「発言の機会」であることを判断し、あらかじめプログラムされていない相手の口調に合わせて姿勢や表情を調整しなければならなかった。 受付カウンター、小売店舗、ホテルのロビー、あるいはエンターテインメント施設向けにヒューマノイドロボットを評価している調達チームにとって、これこそが、単に「動作できる」ロボットと、実際に一般の人々との生のやり取りを伴う役割を担えるロボットとを分ける、具体的な能力の差である。この区別は、基盤となる技術が成熟するよりも速いペースで、商業的な重要性を帯びつつある。 AGIBOT社が提示するWITA-Omniの用途は、サービス現場、エンターテインメント施設、小売スペース、ホテル、受付エリアといった場面に直接向けられている。こうした場所では、対話を事前に台本化することが本質的に困難であり、動作が固まったりタイミングがずれたりして反応するロボットは、単にリハーサル済みのルーチンを実行するロボットよりも悪い結果をもたらす。 競合する研究機関も、異なる角度から同様の機能の実現を目指している。Figure AIは、同様のリアルタイム対話機能を実現するため、自社のヒューマノイドロボットにOpenAIの会話モデルを組み合わせており、UnitreeとUBTECHは今年、消費者向けおよびサービス向け製品ラインに音声対話機能を導入した。 AGIBOTのアプローチを際立たせているのは、タイミングとターン取りを、事後的に既存のマルチモーダルモデルに追加された機能ではなく、第一級の問題として扱うという、アーキテクチャ上の明確なコミットメントである。
ベンチマークスコアと信頼性の高い実運用との隔たり
サードパーティのベンチマークで85.21%の精度スコアを記録し、たとえ1位を獲得したとしても、それはホテルのロビーで監督なしで勤務できるロボットが完成したということとは別問題です。
DailyOmniのようなベンチマーク評価では、管理された条件下で、音声、動画、テキストの各入力に対してモデルが推論を行う能力がテストされます。観客の前で行われる、台本のないライブでのステージ上のやり取りは、購入者が実際に重視する導入時の実情により近いものですが、それでもなお、継続的な運用実績というよりは、単発の厳選されたデモンストレーションに過ぎません。 AGIBOTは、実環境の騒音条件下での失敗率や遅延値、あるいは同社がターゲットとする小売・ホスピタリティ業界でよくある、複数人が同時に話し合う状況下でのWITA-Omniの性能については明らかにしていない。 WITA-Omniを搭載したロボットと、台本に基づいた代替案を比較検討している購入者は、月曜日のデモンストレーションを、その基盤となるアーキテクチャが少なくとも1つの実演環境では機能するという証拠として捉えるべきであり、その機能が監視なしでの大規模な商用展開にすぐに対応できるという証明として捉えるべきではない。基盤となるデータ戦略が示唆するAGIBOTのロードマップ
WITA-Omniのトレーニング手法は、発話、動作、表情の正確なタイミング関係を保持したデータに基づいてモデルを構築するものであり、ほとんどの身体付きAI研究所が操作タスクに依存している動画や画像データセットとは異なるデータ収集パイプラインを必要とします。 これは意味のある投資判断だ。AGIBOTは、ヒューマノイドロボットが工場から抜け出し、生産ライン上で単独で作業するのではなく、一般の人々と共に働く環境へと移行するにつれ、単にタスク達成の精度だけでなく、インタラクションの質こそが差別化要因になると見込んでいる。また、これは同社のより広範な製造戦略を反映している。 すでに15,000台のロボットを出荷し、香港での上場を目指している企業にとっては、短期的に製品化の見込みがない能力を実証するよりも、すでに量産可能なハードウェアの潜在市場を拡大する製品機能を構築する方が、初期段階のスタートアップよりも強い動機となる。
「インタラクション競争」の行方
中国におけるヒューマノイド分野の広がり2026年の大半、中国の人型ロボットメーカー各社は、生産量や移動性能のベンチマークで競い合い、走行速度の記録更新や障害物コースの攻略、工場現場での耐久試験を実施し、自社のハードウェアが産業現場での持続的な使用に耐えうることを証明してきた。 WITA-Omniは、これとは異なる競争の軸を体現している。そこでの差別化要因は、ロボットがどれほど速く、あるいはどれほど長く働けるかではなく、台本通りに動かない人々と同じ空間に、いかに説得力を持って溶け込めるかという点にある。 この転換は商業的に重要だ。なぜなら、AGIBOTがターゲットとする導入分野――ホスピタリティ、小売、エンターテインメント――では、倉庫現場とは異なる種類の信頼性が求められているからだ。 センサーの読み取り値を時折誤認する四足歩行の点検ロボットなら、一晩で再調整が可能です。しかし、間違った客に応答したり、有料の顧客との会話の途中で固まってしまったりする受付ロボットは、目に見える即時の失敗を引き起こし、その役割にロボットを採用すること自体の正当性を損なうことになります。 AGIBOTが、既存の人型プラットフォームに単に音声アシスタントを追加するのではなく、対話タイミングアーキテクチャを構築し、公開デモを行うことを決定したことは、基本的な移動や操作のベンチマークが差別化要因ではなく「必須条件」になりつつある市場において、同社がこの信頼性の格差を次の競争の焦点と見なしていることを示唆している。
AGIBOTと、今年いずれも既存の製品ラインに音声対話機能を追加したUnitreeやUBTECHといった中国の競合他社を比較検討する購入者にとって、 重要な問いは、どどの企業がヒューマノイドのシャーシ上でチャットボットを稼働させているかではなく、どの企業が最初から、会話の順番管理、割り込み処理、および多者間認識を基盤となるモデルアーキテクチャに組み込んでいるかということである。 AGIBOTの「Thinker-Talker-Actor」設計は、ロボットが単一の来訪者に対するデモンストレーションから、複数の来訪者が同時に存在する環境へと移行した際、この違いが導入時の信頼性に表れるという賭けである。
スピーカーの音や周囲の雑音、小売店の売り場やホテルのロビーに見られる日常的な喧騒――月曜日の入念に演出されたコンサート会場では、こうした条件に対処する必要はなかった。AGIBOT社は、WITA-Omniの開発を継続し、同モデルを自社のロボットプラットフォーム全体に展開していくと述べた。その明確な目標は、ロボットを単なる指示の受け手という枠を超え、その場で行われている人間同士のやり取りに積極的に参加させることにある。 その野心が、実際のホテルのロビーや、ホリデーシーズンの混雑した小売店の売り場、あるいは同時に3つの質問に対応しなければならない受付カウンターといった現場で通用するかどうかは、単一のステージ上でのデモンストレーションだけでは判断できない試練である。 月曜日にマカオで行われたパフォーマンスが明らかにしたのは、範囲は狭いものの依然として注目に値する事実だ。すなわち、ヒューマノイドロボットが、生中継の視聴者の前で、プロのパフォーマーと対峙し、台本なしに堂々と振る舞い、それを実行するために台本を必要としなかったということである。
本記事は、AGIBOTの2026年9月の製品デモンストレーションに関する同社の開示情報および公開報道をまとめたものです。本記事は一般的な情報提供のみを目的としており、投資、財務、または法律上の助言を構成するものではありません。
ヘッダー画像のクレジット:AGIBOT。












